AI×マーケティング
動画内文字の編集、評価基準を整備
動画内の看板やラベルの文字を、背景の動きを保ったまま差し替える技術の評価基準「ViTeX-Bench」が公開された。広告やEC、多言語展開の制作工程を変え得る基盤として注目される。
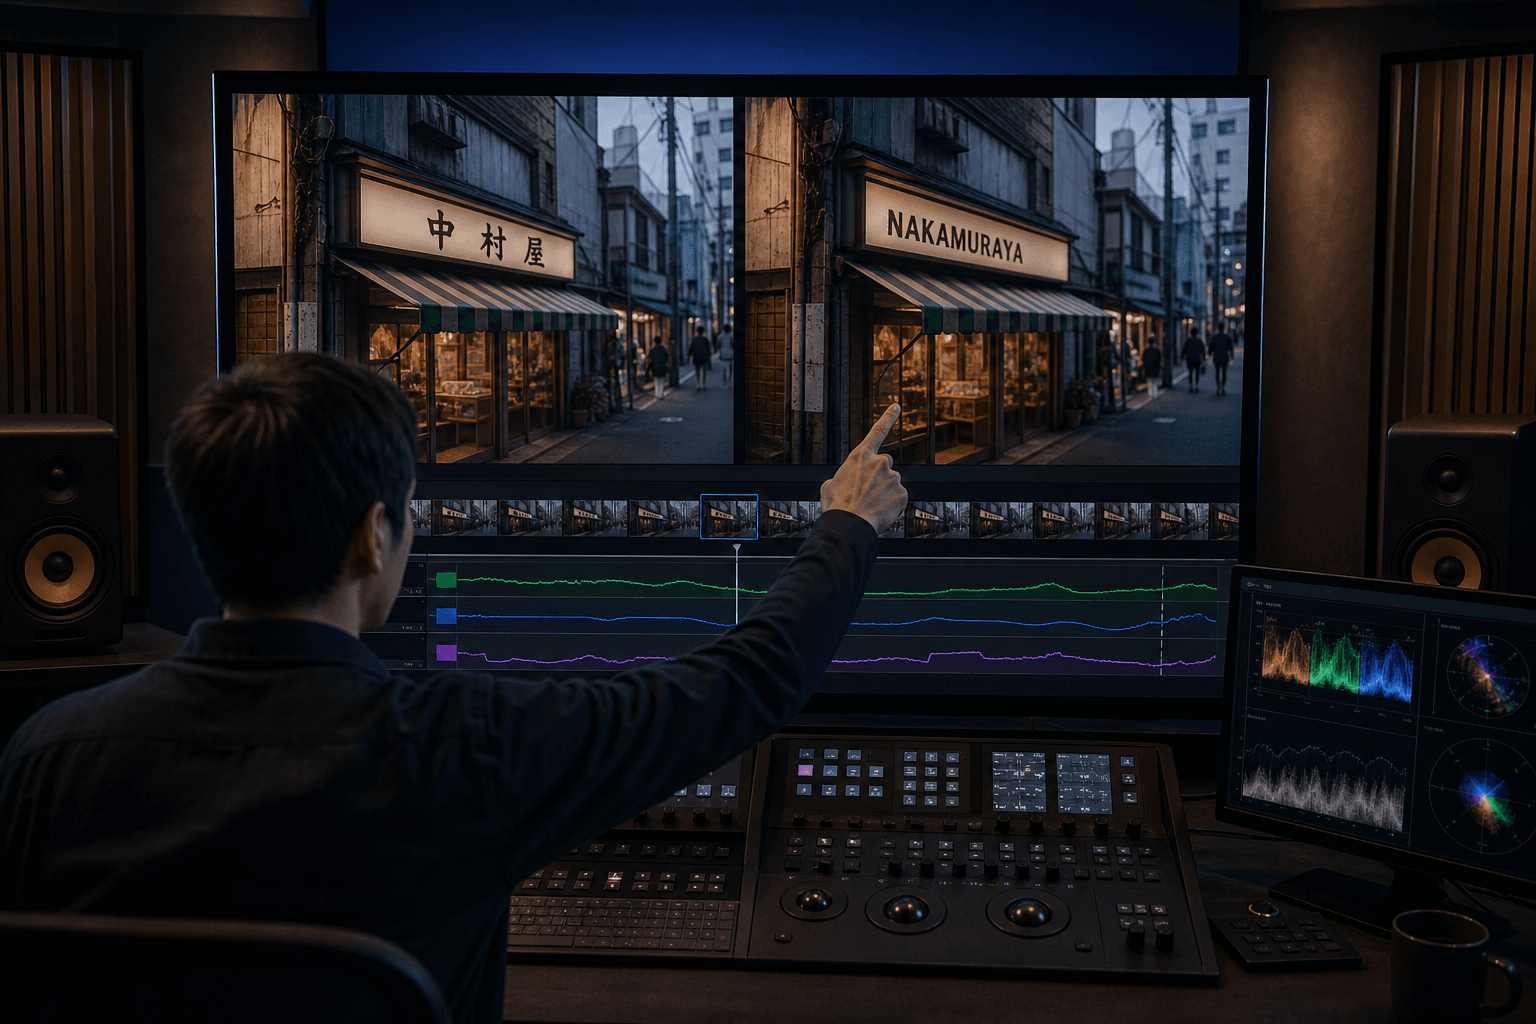
動画内の看板やラベルの文字を、背景の動きを保ったまま差し替える技術の評価基準「ViTeX-Bench」が公開された。広告やEC、多言語展開の制作工程を変え得る基盤として注目される。
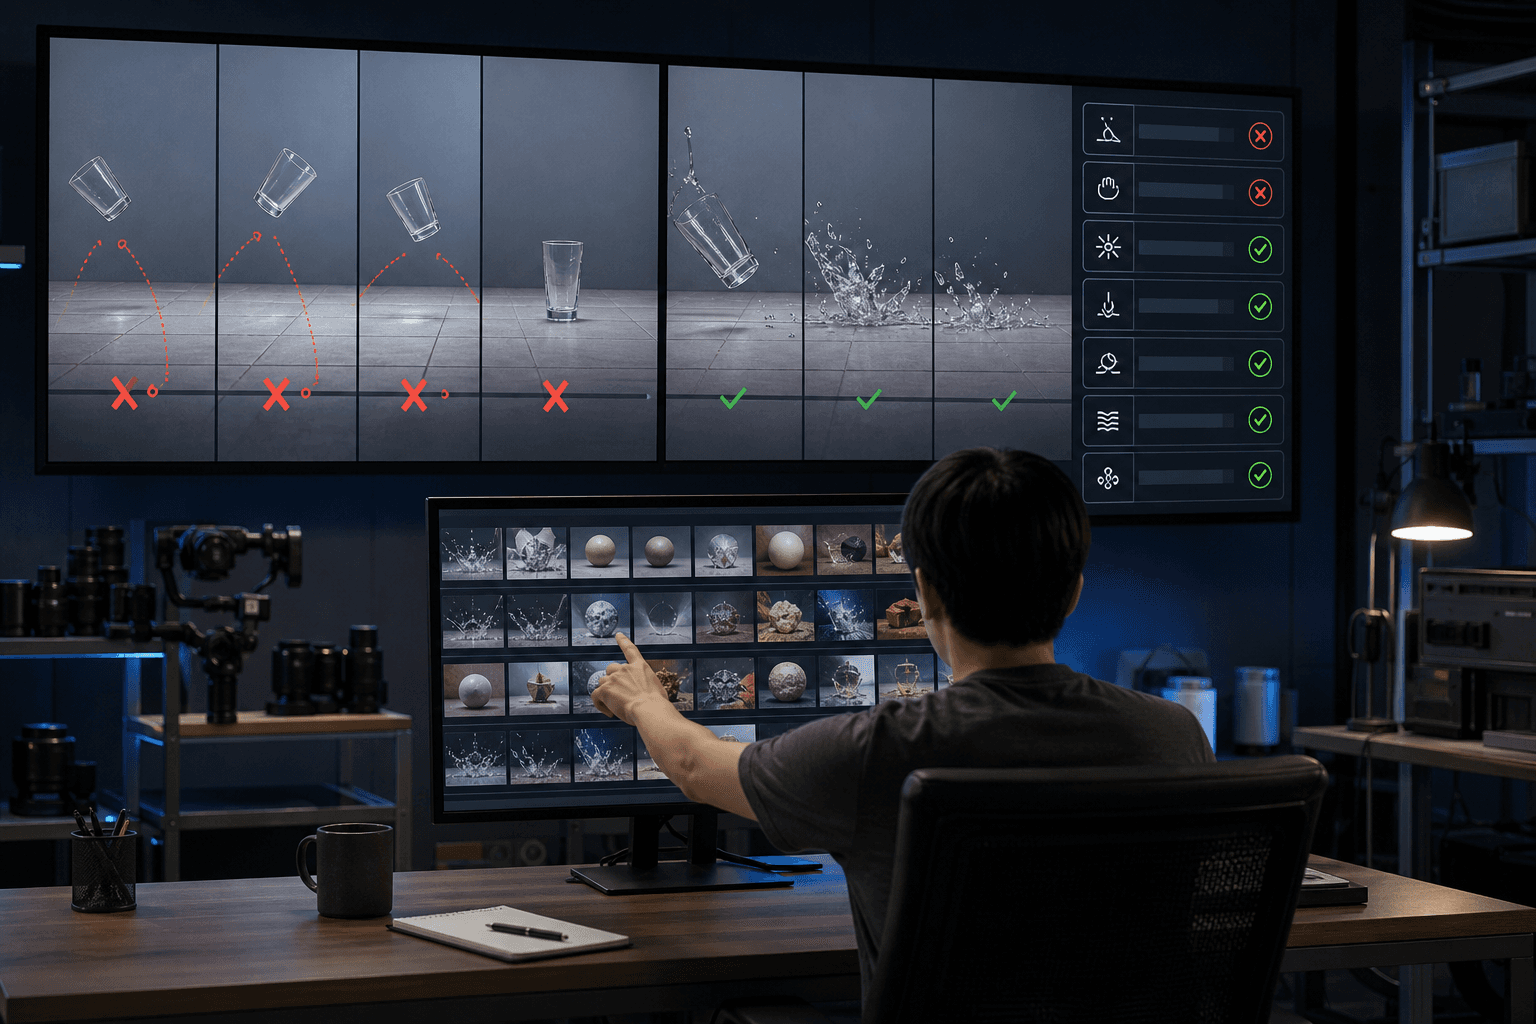
動画生成AIの物理的な不整合を、物理現象を記述する言語表現の自己改善で抑える枠組みPhysis-Langが提案された。オープンモデルが商用最上位のVeo 3.1を上回り、製造やロボティクスの合成データ活用に影響する。
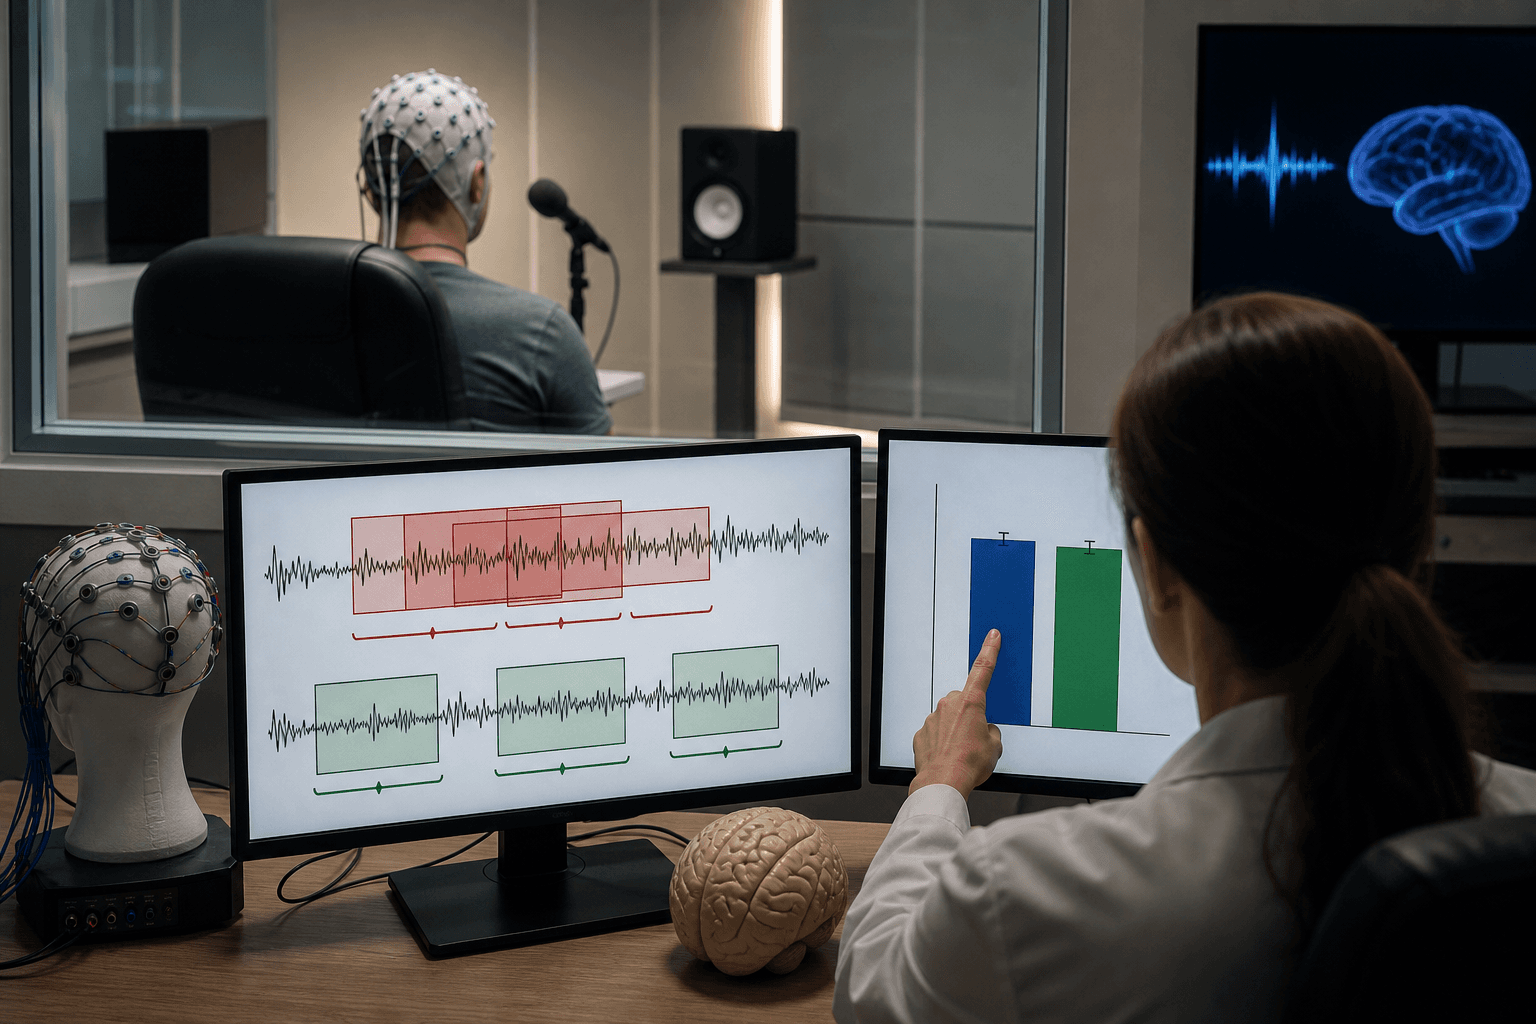
非侵襲の脳波などから単語を復元する有力手法の精度向上は、脳データなしでもほぼ再現できることが判明した。研究チームは近道を除く簡素な改良で、単語誤り率36.6%を達成した。
中国の研究チームが、問題の本質と無関係な表現変化に弱いAIの癖を抑える強化学習手法SCAPOを提案した。小型モデルでも数学推論の精度が向上し、業務AIの安定運用に道を開く。
医療向けマルチモーダルAIのプロンプト改善で、正解率ではなくAUROCを最適化する手法Ranking-PEが提案された。不均衡な臨床データで診断の順位付け精度を最大16.2ポイント高めた。
華中科技大学などの研究チームが、言語と画像を連続的な埋め込み空間で一体的に扱う生成モデル「Multimodal Flow」を発表した。1500億トークンの学習で競合に迫り、基盤モデル開発費の抑制につながる可能性がある。
中国の研究チームが、ロボットの行動と未来予測を同時に学ぶ世界行動モデル「ReWAM」を発表した。動画生成の事前学習なしで高い成功率を示し、開発コスト低減の道を開く。
英研究チームは衛星画像の時系列から作物を区分けする新モデル「PAtteRNS」を開発した。主要データで既存手法を上回り、区画境界の精度も高い。データ設計の欠陥も指摘した。
米UCバークレー校などの研究チームが、線形注意型LLMの再帰状態を8ビットに量子化しても精度を保つ手法LeapQuantを開発した。長文推論の費用を下げ、実運用の採算改善に資する成果である。
中国の研究チームは、線形注意モデルの再帰状態を6ビットで圧縮する量子化手法STEPQuantを開発した。精度をほぼ維持し、同時処理時のサービング総メモリを最大68.7%減らす。
米アドビなどの研究チームは、画素拡散モデルに敵対的学習を後付けし、構造を変えず画像の微細な質感を回復させる手法を示した。生成画像の品質向上を低コストで狙える点が注目される。
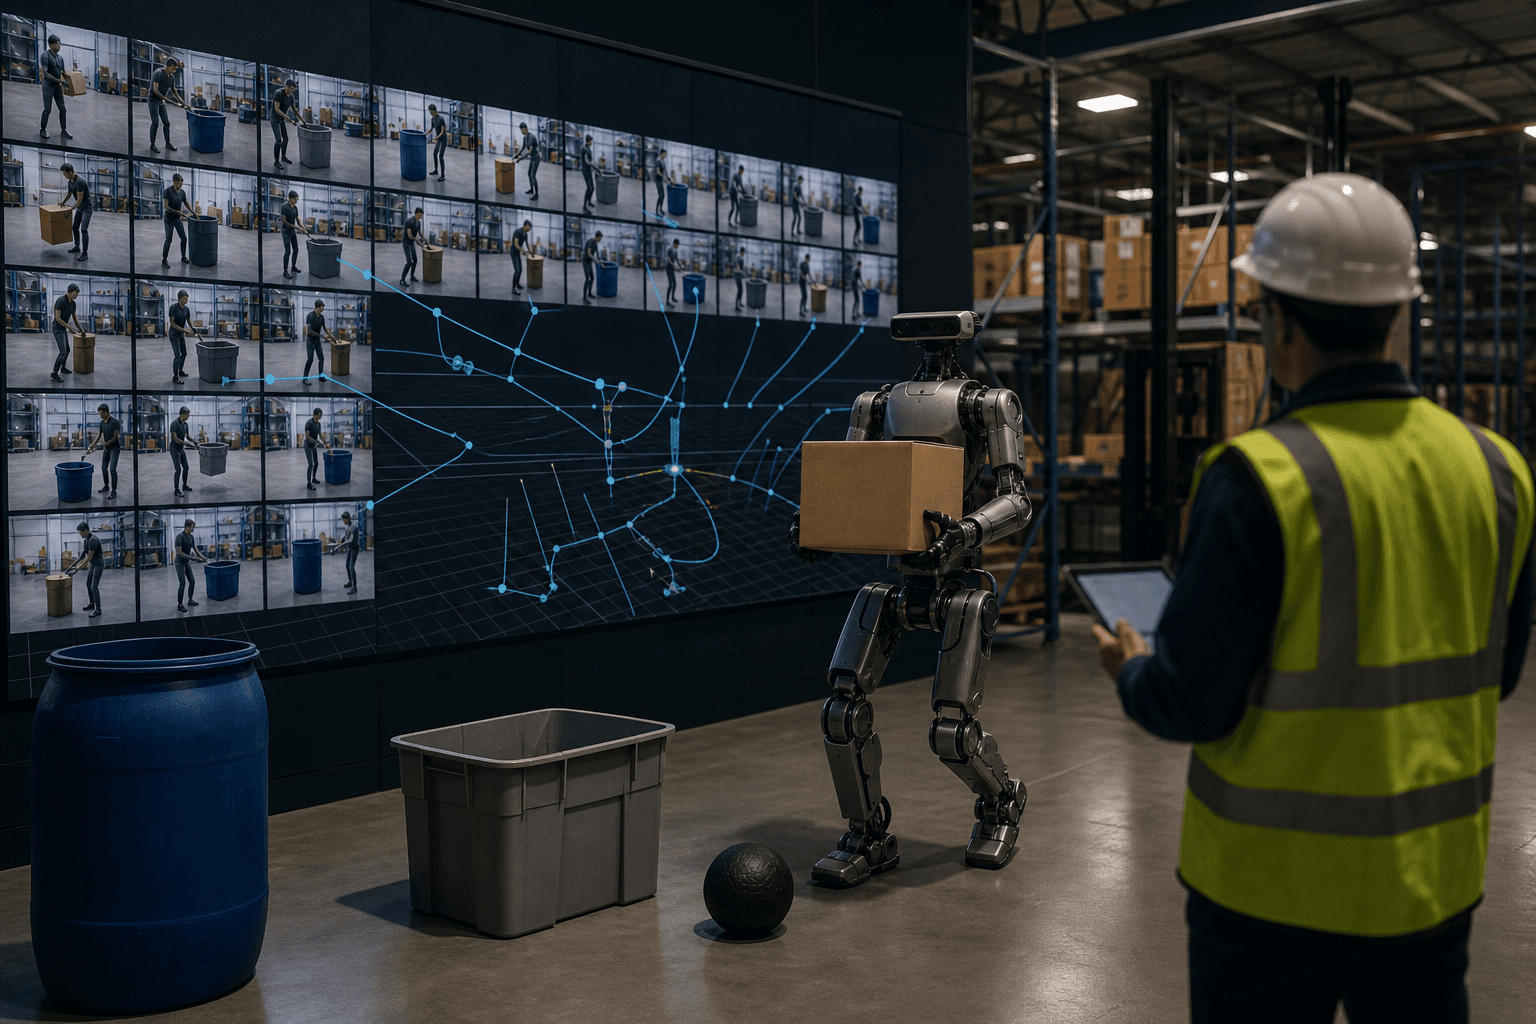
米研究チームが、少数の実映像から数百本の多様な動画を生成しヒューマノイドに物体搬送を学習させる手法PRISMを開発した。実機での追加調整は不要で、物流現場の導入コスト低減につながる。
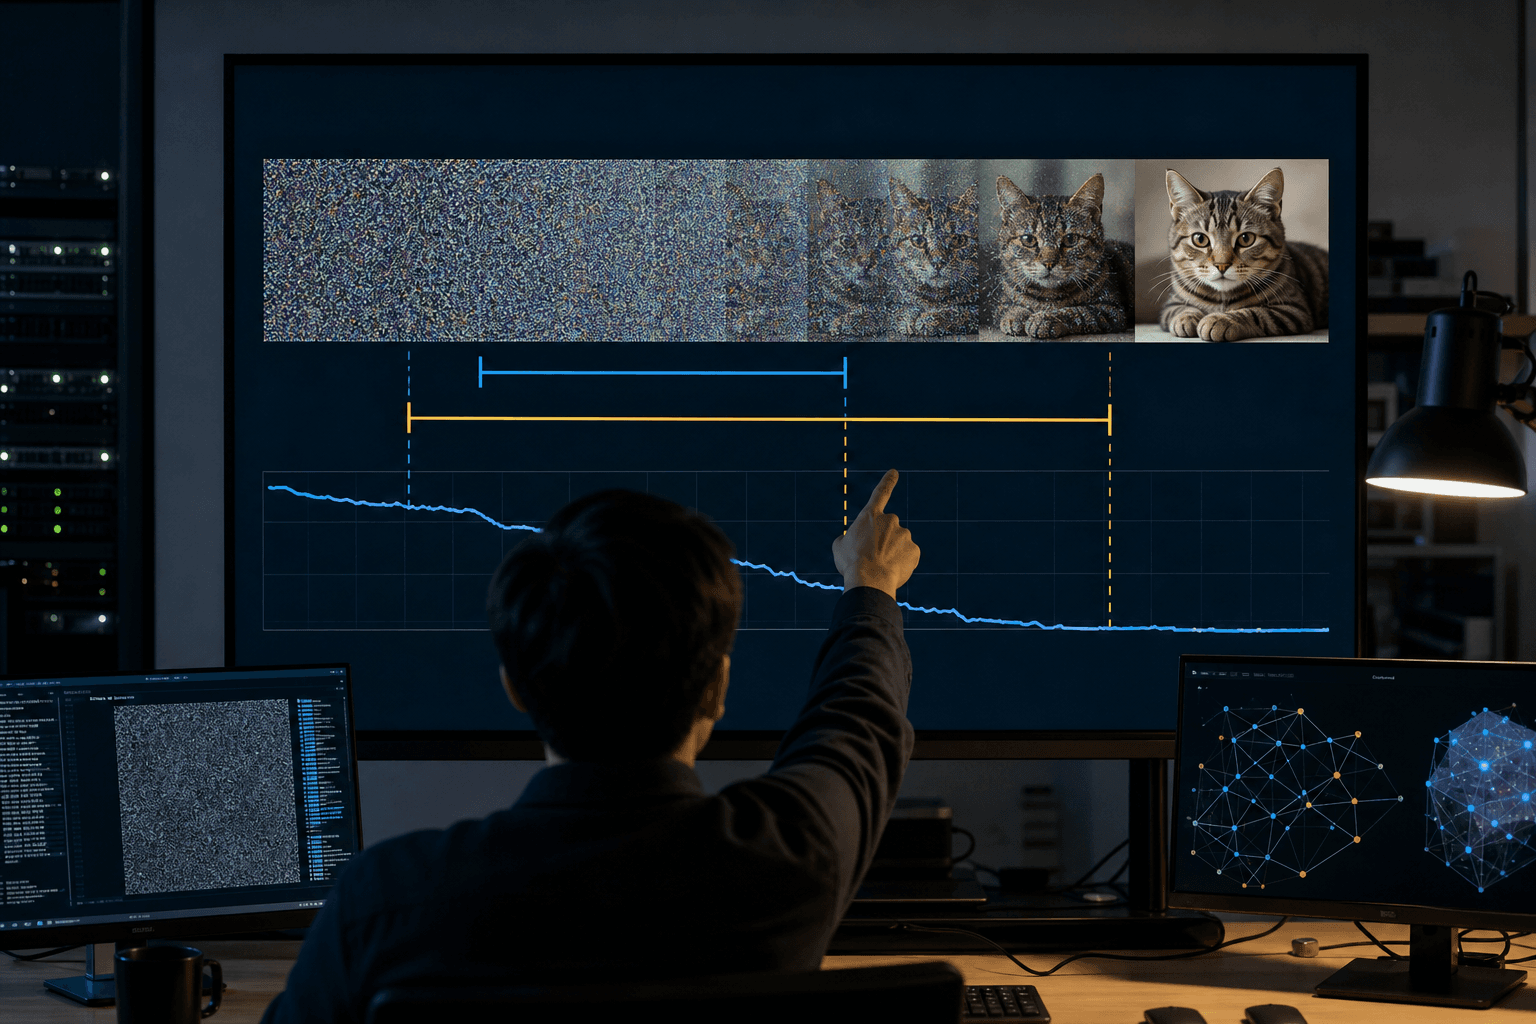
生成モデルで意味クラスが確定する時期と、局所的な文脈だけでは生成できなくなる時期が重なる理由を、理論的に証明した研究が登場した。モデル設計や推論効率の指針となる。
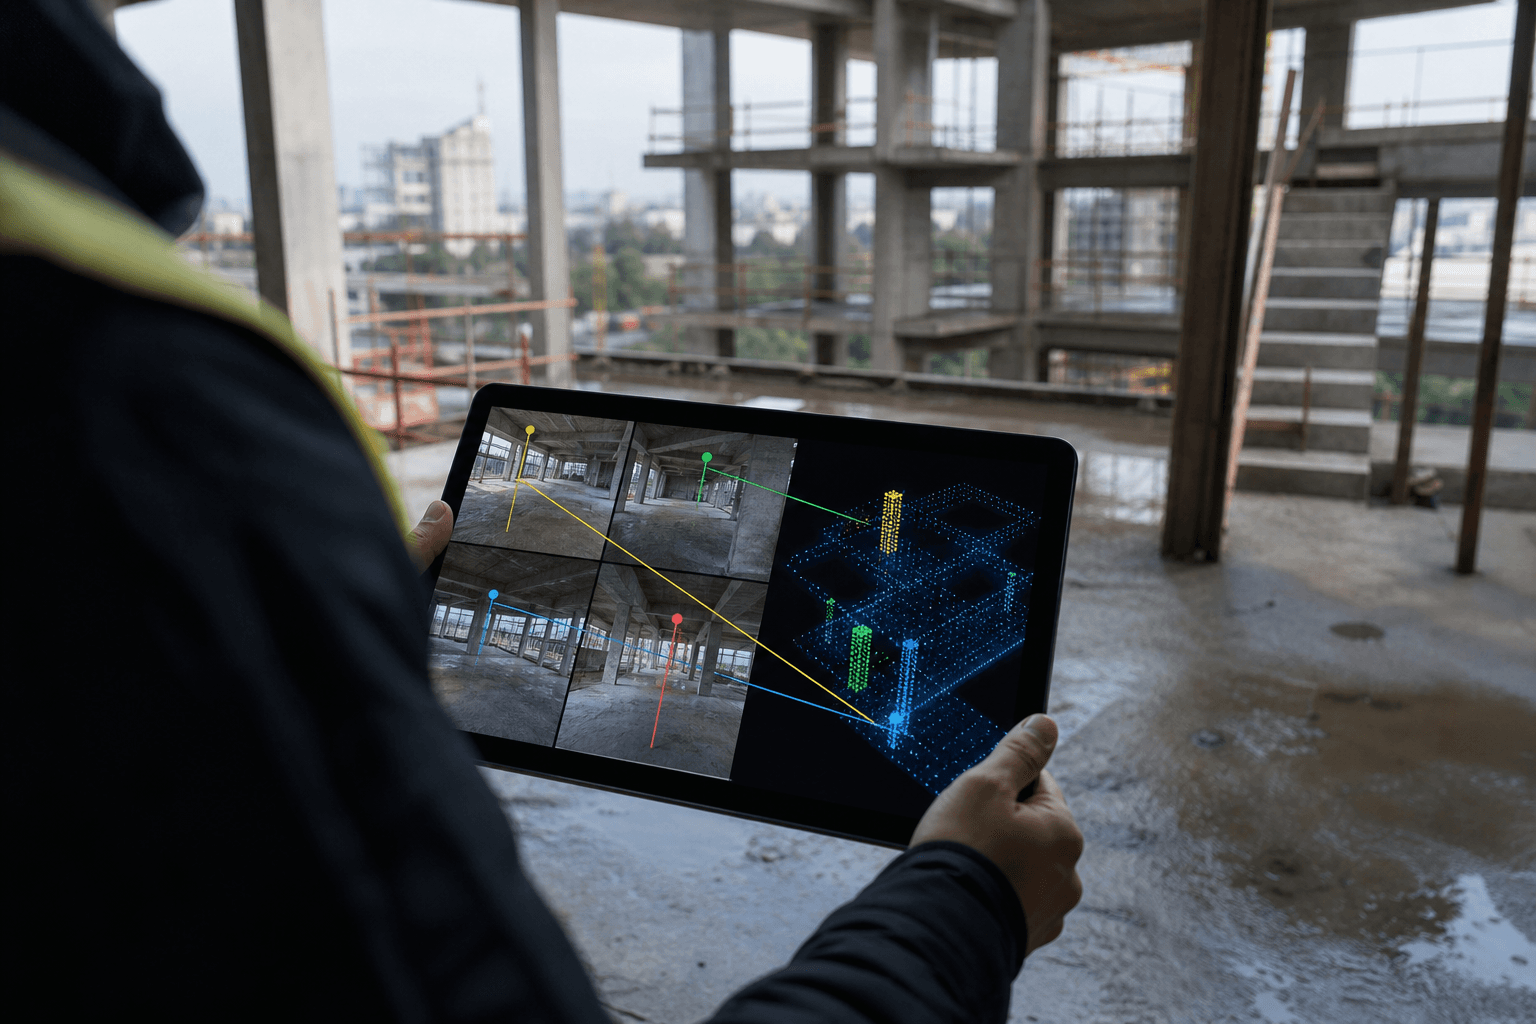
韓国の研究チームは、複数視点の画像から粗い3D表現を内部で組み立ててから回答するMLLM「Imagine3D-LLM」を発表した。精密な幾何情報に頼らず、空間推論で既存手法を上回った。
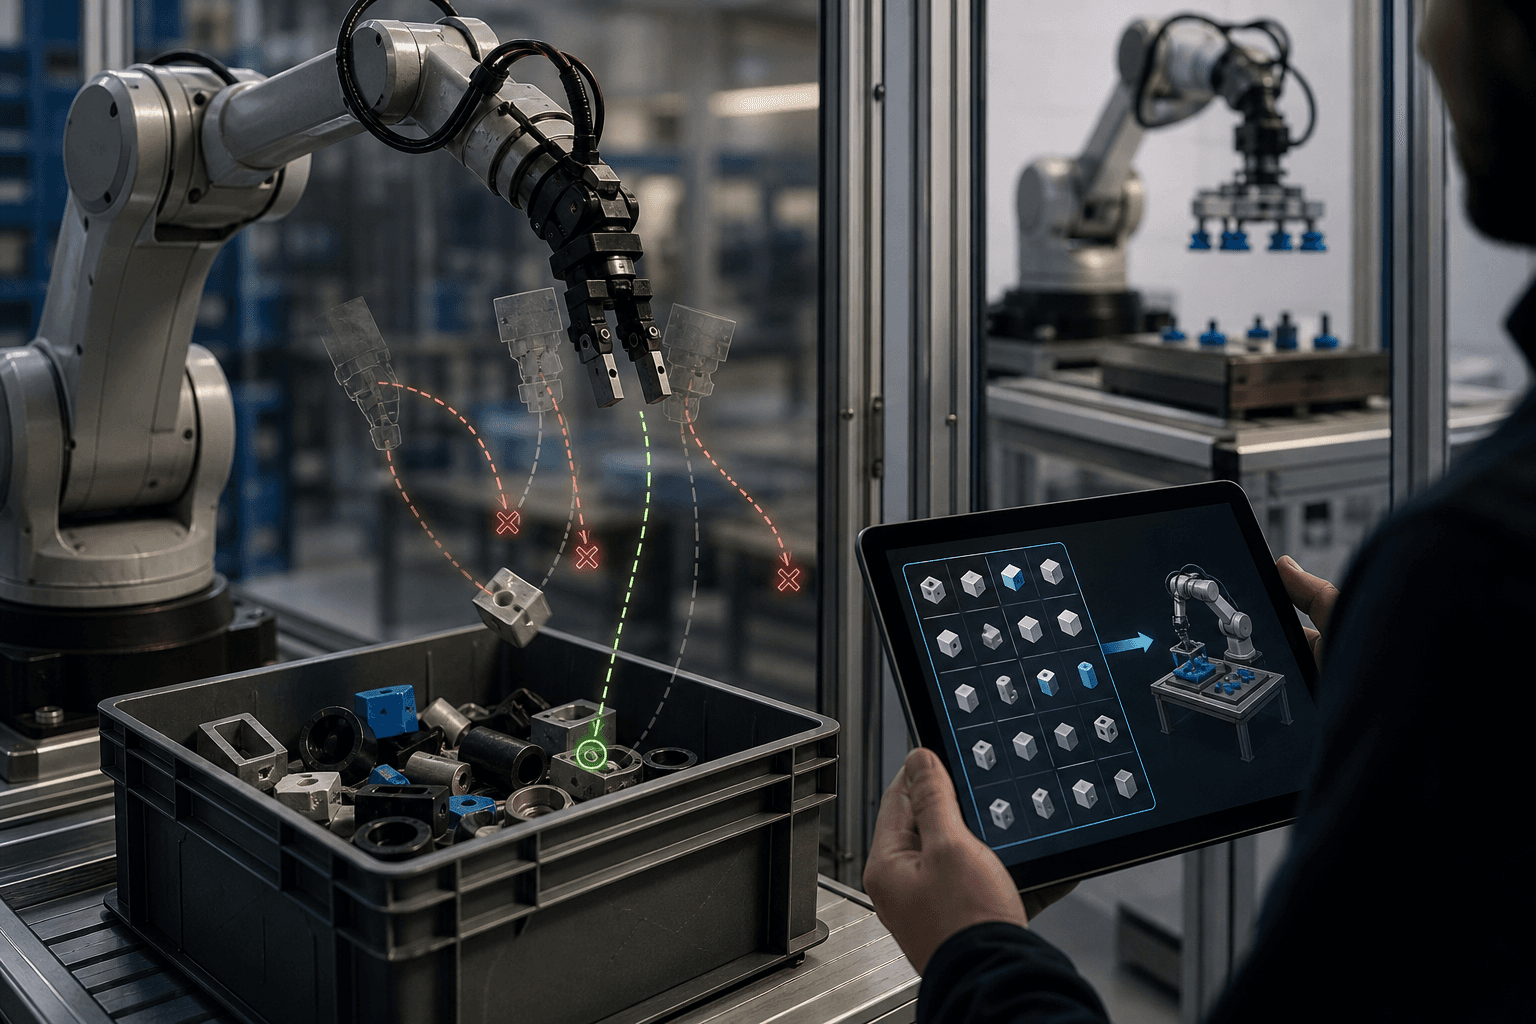
ロボットが基盤モデルの助言で既存の短い技能を試し、成功例を学習に回して失敗を自ら克服する手法が登場した。人手の実演なしに現場で性能を高められる点が、導入費用の抑制につながる。
米研究チームが、点の指定だけで3D形状を重複も隙間もない部品に分割する手法Point2Partを開発した。部品間の整合性を従来比で一桁改善し、設計や制作の工程効率化に道を開く。
米研究チームは、外乱の時間変化を潜在状態として統計的に学習する適応制御を開発した。液体揺動を伴う車両実験で従来手法を上回り、物流や製造現場の搬送安定化に道を開く成果である。
LLMエージェントの実行中にトークン消費量を予測する手法TokenCastが提案された。追加のLLM呼び出しなしで予測を更新し、予算制御でトークンを21.3%削減。運用コストの管理手段として注目される。
研究チームが、登場人物や伏線を構造化して追跡する学習不要の枠組みNstAgentを提案した。10万語規模でも整合性と文章品質が低下せず、出版・映像業界の制作工程に影響し得る。
研究チームが、画像生成AIを1回の推論で動かす学習枠組みMGFlowを発表した。FLUX.2 klein 4Bを1段階化し、4段階の元モデルを主要指標で上回り、生成コスト削減の道を開く。