生成AIの意味確定と非局所性が同時期に発生
生成モデルで意味クラスが確定する時期と、局所的な文脈だけでは生成できなくなる時期が重なる理由を、理論的に証明した研究が登場した。モデル設計や推論効率の指針となる。
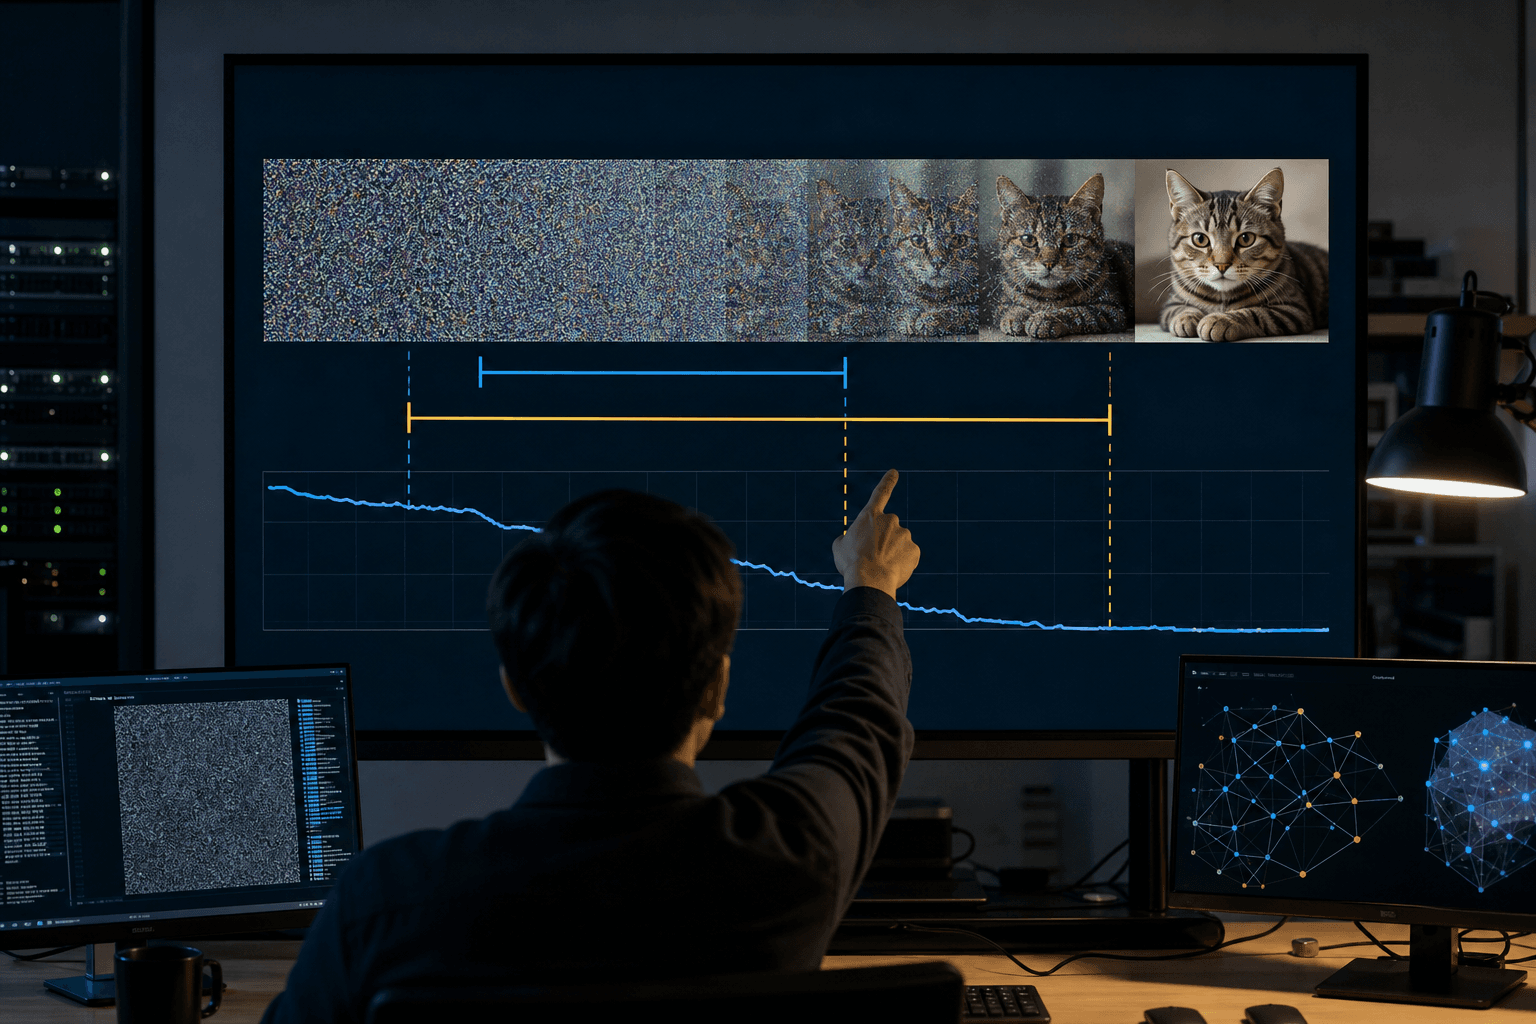
研究の概要
Liu氏らの研究チームは、拡散モデルなど生成モデルの生成過程における二つの時間的区間の関係を理論的に解明した。この研究では、第一に生成サンプルが特定の意味クラスに確定する「種分化(スペシエーション)区間」と、第二に近傍の文脈だけでは生成を進められなくなる「非局所性区間」が取り上げられた。これらの区間は、複数の先端モデルでほぼ同時期に現れることが経験的に知られていたが、その理由は明確ではなかった。
研究チームは「共通原因」仮説を提唱し、意味ラベルが離れたトークン同士の相関の一部を説明するという仮定に基づいている。この仮説は、多くの実データにおいて自然に成り立つ条件とされており、非局所性区間が種分化区間の内部に必ず収まることを数学的に証明した。さらに、系のサイズが大きくなるにつれて、両区間が単一の極限時刻へ収束する条件を示し、これを「相転移」と位置づけた。この挙動は、ガウス混合モデルで解析的にも検証されている。
しくみをやさしく
この研究の核心は、生成モデルにおける意味の確定とその非局所性についての理解を深めることである。生成モデルは、特定の意味を持つサンプルを生成する際に、まず「種分化区間」において意味が決まる。この段階では、生成されるサンプルが特定のクラスに分類される。次に、「非局所性区間」が訪れると、生成プロセスは近傍の文脈だけでは進行できなくなり、より広範な情報を必要とする。このように、意味の確定と非局所性の発生は密接に関連しており、これらの理解は生成モデルの設計や推論の効率化において重要な指針となる。
ビジネスへの示唆
本研究は基礎理論であり、直ちに製品化される成果ではないが、生成の「どの段階で意味が決まるか」を予測できる点は、実務上の指標設計に直結する。例えば、画像・動画生成を扱うメディア・広告業界においては、意味内容が決まる時間帯に計算資源を集中させることで、推論コストの削減が見込まれる。この場合、自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを考えることが重要である。生成ステップ数の削減は、1枚当たりの生成単価や応答時間といったKPIの改善につながる。
製造業の設計・検査部門では、合成データ生成や異常検知に生成モデルを用いる例が増えている。意味が確定する区間を把握できれば、欠陥パターンなど制御したい属性をどの段階で条件付けるべきかを判断しやすくなる。これにより、合成データの品質や、検出モデルの再現率の向上が期待できる。
医療・創薬分野では、分子や医用画像の生成において、クラス(構造の種類)が決まる時点の制御が課題である。関連する部門は以下の通りである。
- 研究開発部門:生成候補の多様性と有効率
- AI基盤・MLOps部門:推論コストと生成遅延
- 品質保証部門:生成物の属性一致率
また、局所的な処理で足りる区間では、計算量の小さい局所モデルや並列処理を適用できる。非局所性が強まる区間にのみ大域的な注意機構を割り当てる設計は、GPUコストの抑制に寄与しうる。
現場での導入イメージ
仮に導入支援に入るなら、以下のようなステップで進めることが考えられる。
-
棚卸し
現在の業務プロセスを詳細に把握し、生成モデルの導入が可能な領域を特定する。この段階での目指す到達点は、業務の全体像を把握し、生成モデルがどのように活用できるかの見通しを立てることである。 -
差し込み先の設計
既存ツールや業務プロセスの中で、生成モデルをどこに組み込むかを設計する。この段階では、新しいツールを増やさずに、既存のシステムとの統合を目指す。目指す到達点は、業務フローにおける自然な統合を実現することである。 -
小さく試す(PoC)
限定的な範囲で生成モデルを試験的に導入し、その効果を検証する。この段階では、実際のデータを用いて生成モデルの性能を評価し、問題点を洗い出すことを目指す。目指す到達点は、実用性を確認し、必要な調整を行うことである。 -
運用と横展開
成功したPoCを基に、全社的な運用を開始し、他の部門への展開を図る。この段階では、運用における課題を解決し、他部署への適用を進めることを目指す。最終的な目指す到達点は、生成モデルを活用した業務の効率化と品質向上である。
今後の展望
今回の証明は、意味ラベルが遠隔相関を説明するという仮定に依存しているため、ラベルで説明できない相関が支配的なデータでは結論が成り立たない可能性がある。また、解析的な検証はガウス混合に限られ、実際の大規模モデルでの定量的な検証は今後の課題である。
一方で、相転移という枠組みは、モデル規模やデータ規模を拡大する際の挙動を予測する手がかりとなる。生成モデルの開発企業にとっては、経験則に頼っていたサンプリング設計やスケジュール調整を理論に基づいて最適化する道が開ける。意味確定の時期を診断する手法が整備されれば、生成AIの品質管理や安全性評価の新たな基準として定着する可能性がある。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AIが能力を隠せると証明、評価の限界露呈
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

ReLU網が描ける形状の規模を数学が証明
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

概念を隠して画像AIの判断根拠を探る新手法
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
