AI×医療
生成・検証・改善で視覚推論を実現
英国の研究チームが、候補の生成、検証、反復改善を一体化した推論枠組みGenVerOptを提案した。IQパズルや前立腺がん領域の抽出で人間や臨床医に並ぶ成果を示し、画像判断業務の自動化に道を開く。
|arXiv:2610.13925v1
英国の研究チームが、候補の生成、検証、反復改善を一体化した推論枠組みGenVerOptを提案した。IQパズルや前立腺がん領域の抽出で人間や臨床医に並ぶ成果を示し、画像判断業務の自動化に道を開く。
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

Chronos Policyは、観測の取得時刻と行動の実行時刻をロボット方策に明示的に与える手法である。センサーや推論の遅延が揺れる現場でも、動作の安定性を保てる可能性を示した。

ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。

画像生成AIが途中経過の誤りを自らの文章理解に反映し、ずれを固定化する現象が判明した。この逆流を抑える新手法SFGは、追加コストを抑えつつ指示への忠実度を高める。
異なる構造の画像生成AIの途中経過を共通の潜在空間で受け渡し、生成を引き継ぐ技術InstantFusionが提案された。モデルを再学習せず組み合わせられ、運用の柔軟性を高める。
スマートフォンによる室内スキャンだけで、汎用ロボット制御AIを個別の現場に適応させる手法が登場した。実機での把持成功率は63.9%に達し、現場ごとの実演収集コストを抑える道を開く。

オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。

言語モデルにウィキペディアのリンクだけで目標記事へ到達させる実験で、上位モデルは人間に匹敵した。ただし人間を有意には上回らず、言語や分野で順位が入れ替わる。検索系AIの選定に注意を促す結果である。
密度比と変位場を単一の凸最適化で同時に推定する手法が提案された。分布のずれの大きさと動かし方を一度に得られ、学習済み生成モデルを再学習せず補正できる点が実務上重要である。
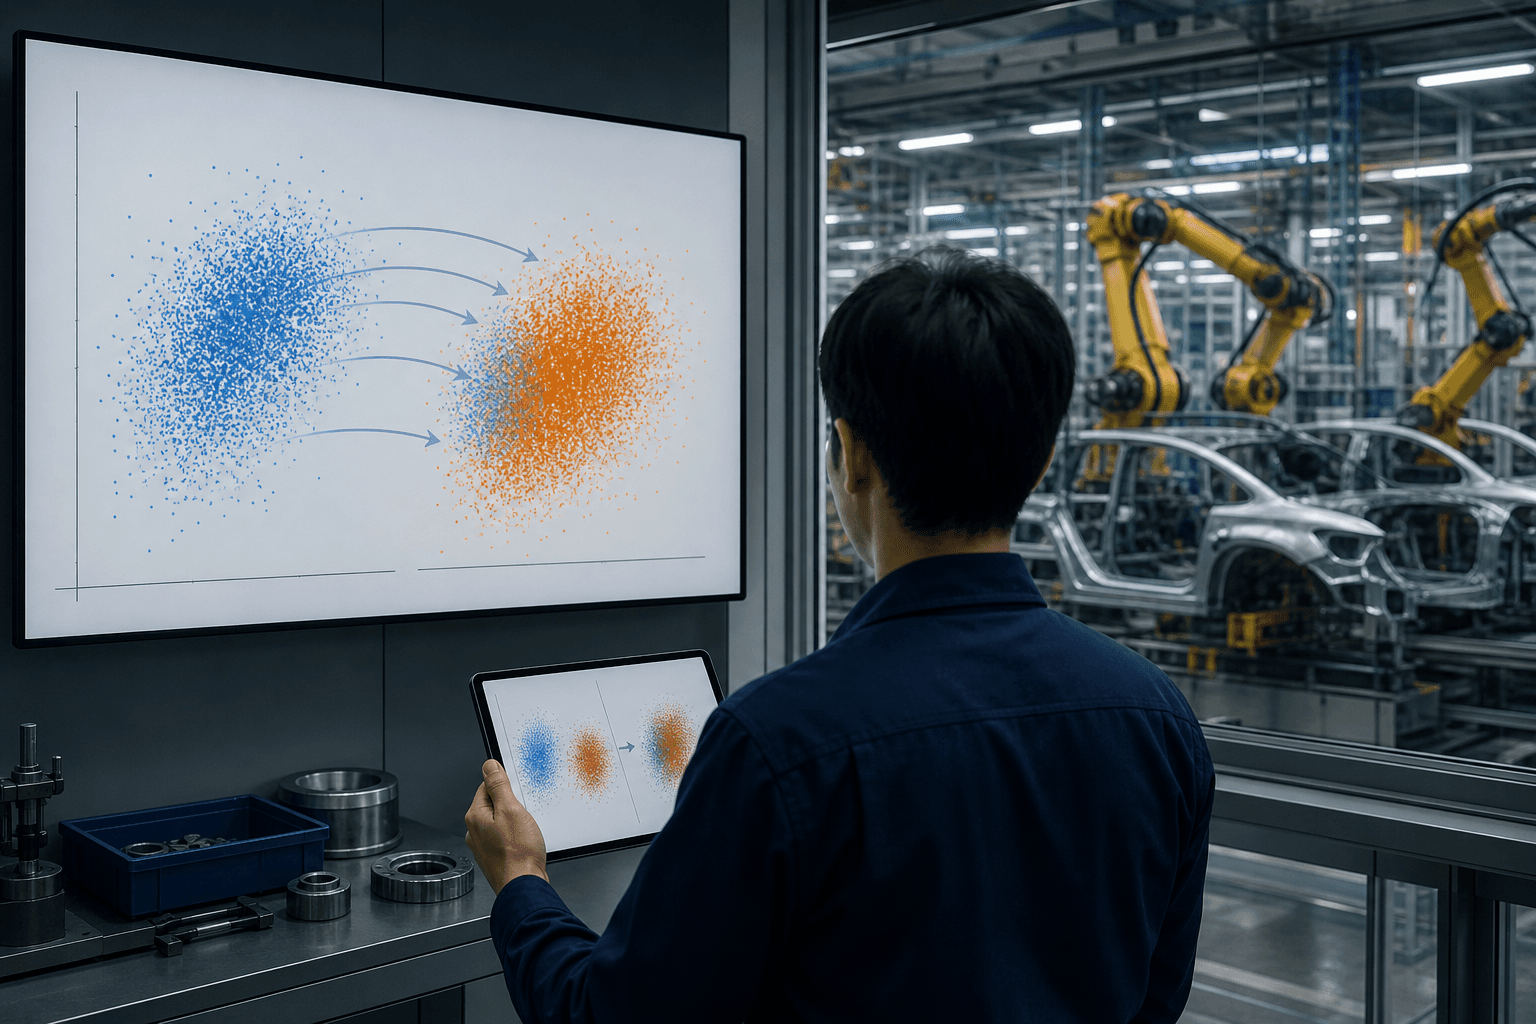
外部カメラの映像から作業者の一人称視点を生成する新手法LEGOが登場した。深度推定や点群化を省き、構造を担う変換器と細部を担う拡散モデルを分担させ、従来法を上回る精度を示した。
AdamWの最適化状態を4ビットで保持する際の丸め方を見直した新手法ZIP-SRとZE-EDENが提案された。メモリ削減と学習精度の両立を狙え、LLM自社学習の費用負担を下げる可能性がある。
LLMの内部状態を読み取る「プローブ」が、AIエージェントの妨害行為を98.8%のAUCで検出し、テキスト監視を上回った。発話に表れない欺瞞も捉え、AI監査の新たな基盤となる可能性がある。
独Bi-FORKは、座屈など一つの入力から複数の解が生じる分岐現象を、生成モデルで一度に復元する。最大26万点の高次元系にも対応し、シミュレーション代替の適用範囲を広げる。
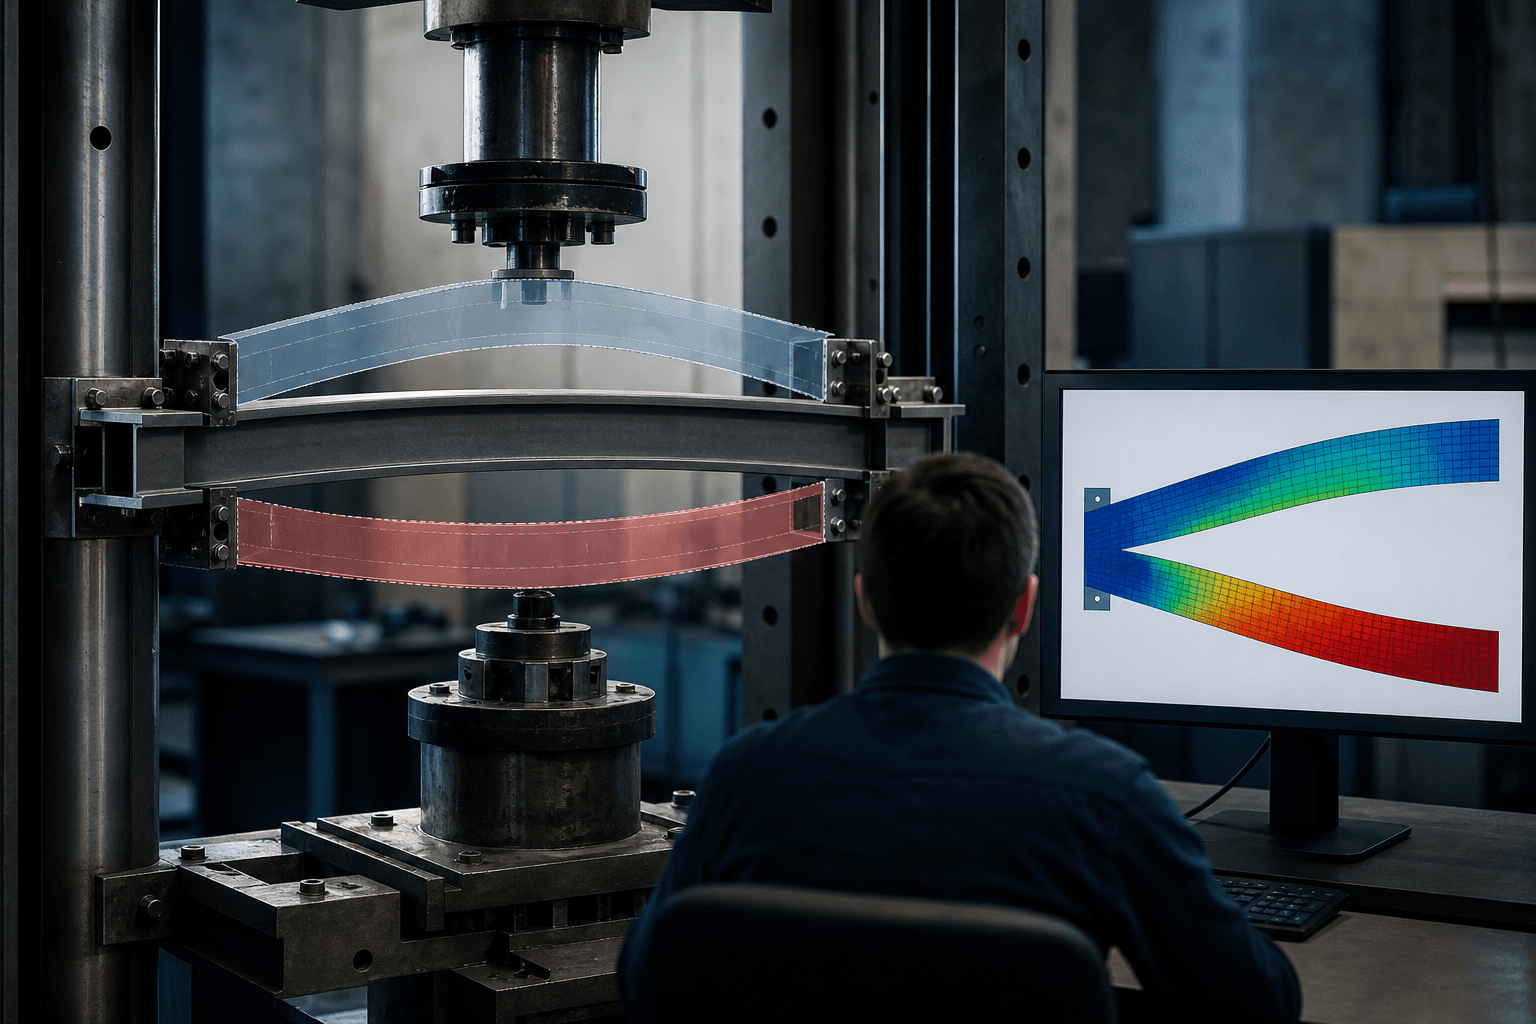
単一のTransformerブロックを繰り返し使う画像認識モデル「reViT」が、全層モデルと同等の精度を保ちつつ保存パラメータを約70%減らした。端末搭載や配布のコストを下げる道を開く成果である。
カメラの台数や位置が変わっても動作するロボット操作AI「VersaCamVLA」が提案された。現場ごとの再学習を減らせる可能性があり、導入コストの抑制に資する。
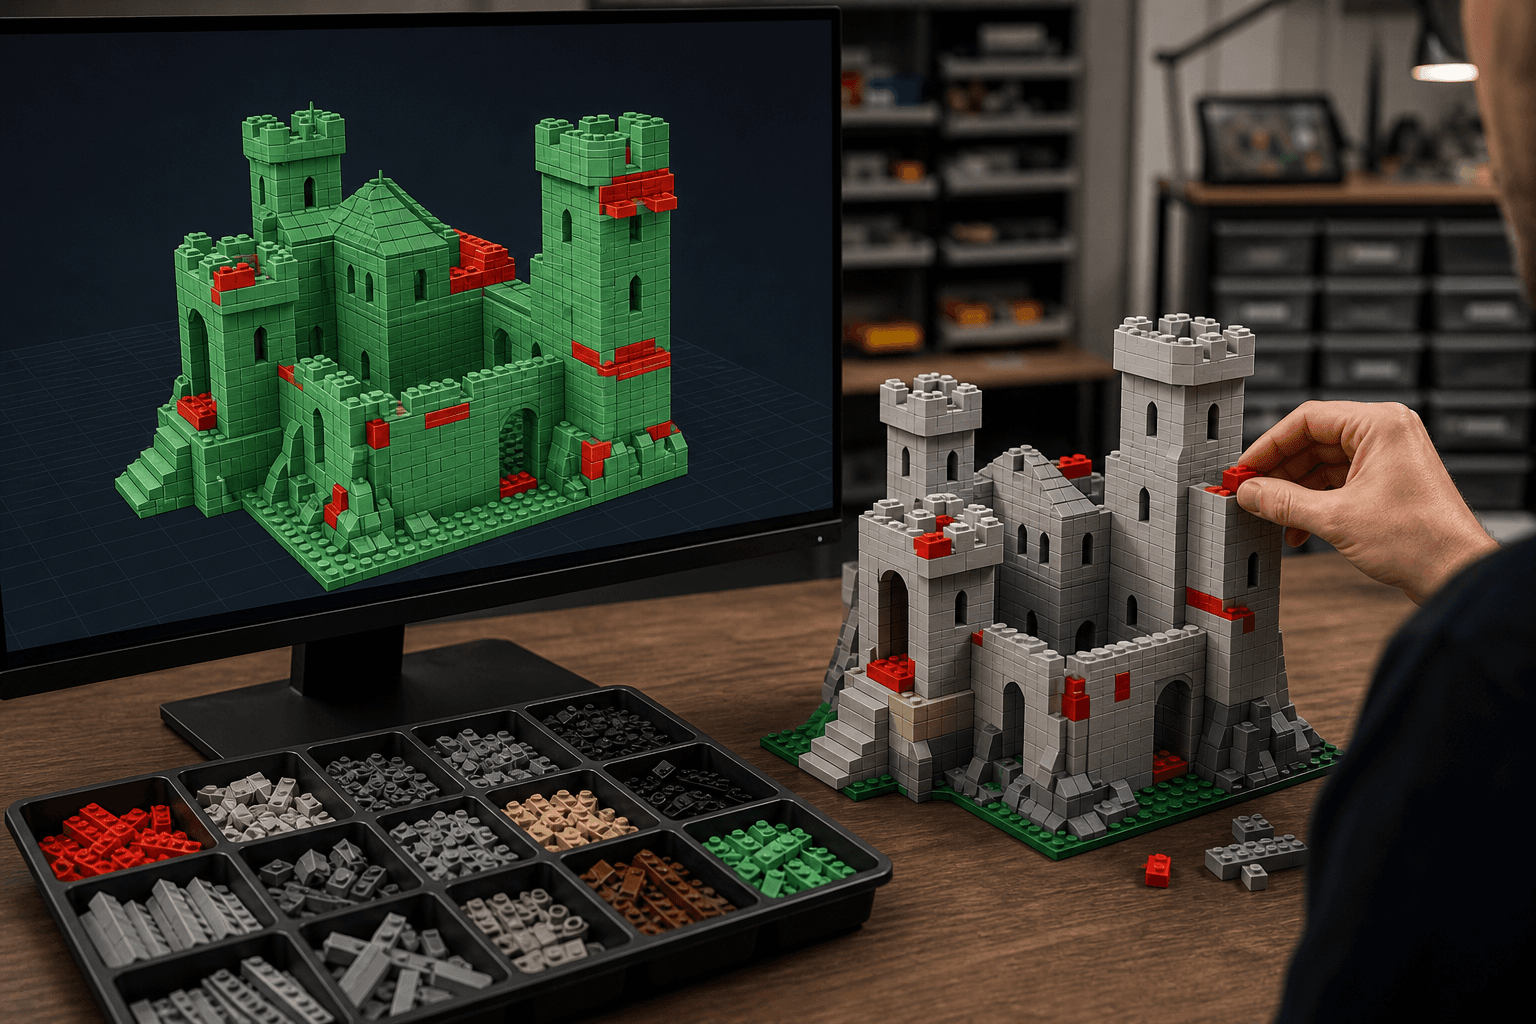
スタンフォード大などがレゴ設計をAIに課す評価基準BrickBenchを公開した。最新エージェントは物理的な組み立て可能性を概ね満たすが、人間の設計には及ばず、製造設計での実用性を測る物差しとなる。
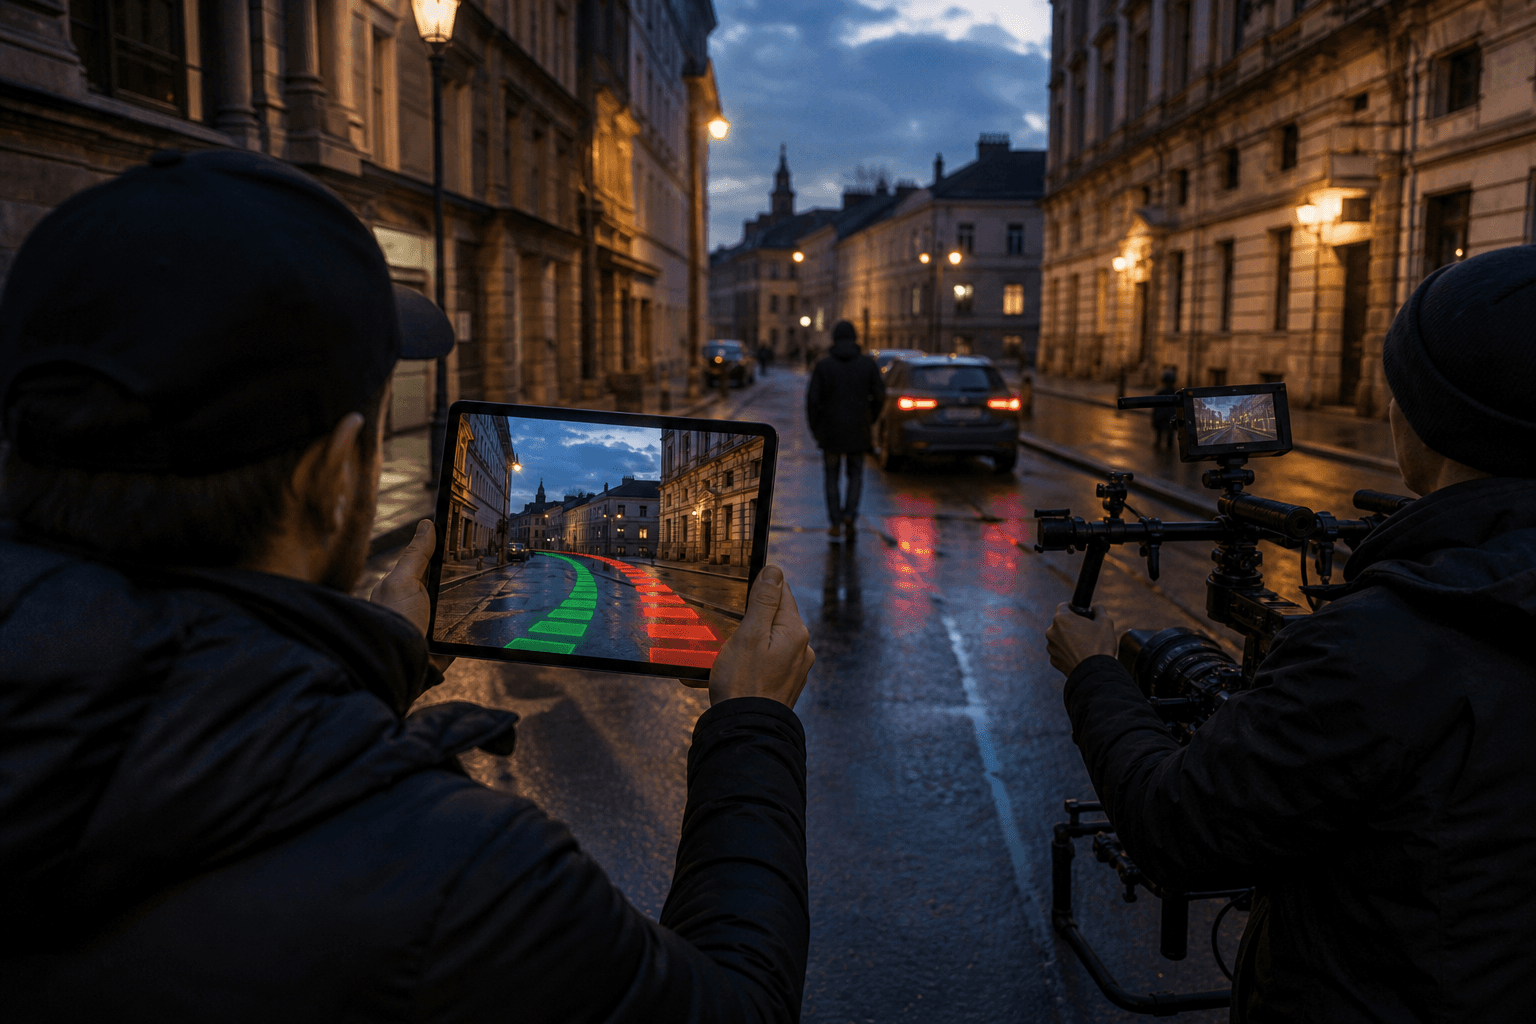
撮影後にカメラ動作を変える生成AI再撮影では、未撮影部分の捏造が撤収後に発覚する課題がある。新手法は現場で破綻リスクを即時に可視化し、手戻りの抑制を目指す。
音声と映像を同時に理解するAIの能力を、原子的な評価単位で精密に診断する新ベンチマークが公表された。人物の取り違えや音と映像のずれなど、実務で致命傷となる誤りの特定に道を開く。