MLLM、3D情景を想像し空間推論を強化
韓国の研究チームは、複数視点の画像から粗い3D表現を内部で組み立ててから回答するMLLM「Imagine3D-LLM」を発表した。精密な幾何情報に頼らず、空間推論で既存手法を上回った。
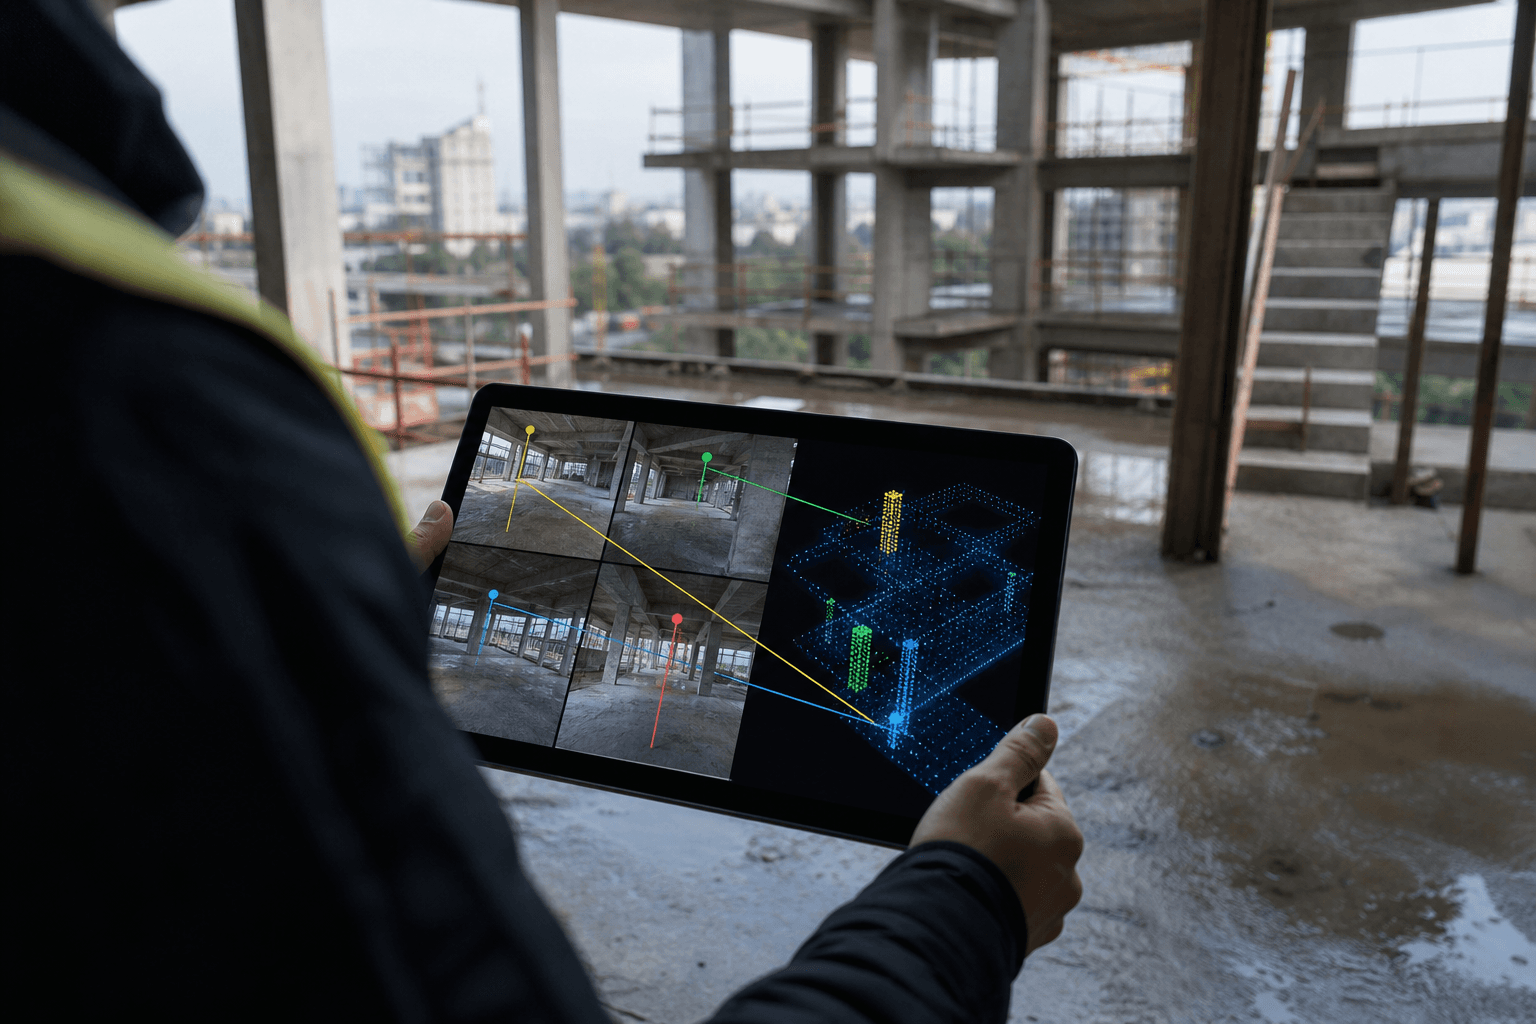
研究の概要
韓国のソウル大学校を中心とする研究チームは、複数視点の画像から3D空間を理解する能力が、マルチモーダル大規模言語モデル(MLLM)にとって根本的な課題であることを指摘している。従来の手法は、単一画像の処理には優れているものの、視点を超えて証拠を統合し、一貫した3D理解を築くことが難しいという問題を抱えていた。これまでのアプローチとしては、画素単位の視点間対応を強化する手法や、3D幾何基盤モデルの特徴を融合する手法が試みられてきたが、人間の推論との間には大きな隔たりが残っていた。
この研究チームは、人間の空間推論に着目し、精緻な幾何情報に依存せず、視点間で共通する物体をおおまかに特定し、視点間の相対的な位置関係を推定して、場面の粗い3次元配置を組み立てる手法を提案した。これに基づいて開発された「Imagine3D-LLM」は、画像トークンの後ろに少数の学習可能な要約トークンを付加し、このトークンを3Dガウシアン・スプラッティングと呼ばれるコンパクトな3D表現へ復号する。この手法では、測光的再構成損失を用いて教師信号を与え、学習は通常の次トークン予測と同時に行われる。これにより、モデルは自ら組み立てた3D表現を踏まえて回答を生成することが可能となる。
特筆すべきは、再構成教師を受けるのが要約トークンのみであるにもかかわらず、LLM内部の画像特徴においてフレーム間の対応関係が強化されたことである。再構成の学習がモデル全体へ3D認識の信号を波及させていると分析され、結果として複数の空間推論および3D理解のベンチマークで、従来手法を一貫して上回る成果を上げた。
しくみをやさしく
「Imagine3D-LLM」は、複数視点の画像を使用して、3D空間を理解するための新しいアプローチを採用している。具体的には、各画像から得られる情報を要約トークンとして集約し、それを基に3D空間の粗い配置を復元する。このプロセスでは、視点間の物体の相対的な位置関係を推定し、精緻な幾何情報に依存せずに3D表現を生成することが可能である。これにより、従来の手法に比べて、より効率的に空間理解を行うことができる。
ビジネスへの示唆
この技術の最大の特徴は、専用の3Dセンサーや高精度な幾何推定器を必要とせず、通常の複数枚の画像から空間理解を引き出せる点である。これにより、導入コストの低減が見込まれ、さまざまな業界での応用が期待される。具体的には、以下のような業務が考えられる。
-
建設・不動産:現場の写真を用いて空間配置を把握し、進捗確認や出来形検査を省力化することができる。これにより、現場監督部門の巡回工数や手戻り発生率を低減することが可能である。
-
物流・倉庫:庫内の複数カメラ映像から棚や荷の位置関係を推論し、ピッキング誤り率や在庫照合時間を改善することが期待される。
-
ロボティクス・製造:組立や検査工程において、物体間の配置関係を言語で指示・確認することで、ティーチング時間の短縮が見込まれる。
-
保険・損害査定:事故や災害現場の複数写真から状況を把握し、査定リードタイムの短縮が期待される。
これらの業務において、担当部門が評価すべき指標は、空間関係に関する回答精度、人手による確認工数、現場撮影から判断までの所要時間である。既存の画像解析パイプラインに追加の3D計測機器を導入せずに済むことができれば、投資回収期間も短くなる可能性が高い。
さらに、再構成を補助課題として学習させる設計は、自社データでMLLMを追加学習する企業にとっても参考になる。社内で蓄積した多視点画像を活用し、自社現場に特化した空間理解モデルを構築する際の設計指針となるだろう。
現場での導入イメージ
仮にこの技術を導入支援する場合、以下のようなステップで進めることが考えられる。
-
棚卸し:現在の業務プロセスや使用している画像解析ツールを棚卸しし、どの業務にこの技術が適用可能かを評価する。目指す到達点は、導入候補業務の特定と、現在の業務フローの可視化である。
-
差し込み先の設計:既存ツールや業務のどこにこの技術を組み込むかを設計する。新たなツールを増やさず、既存の業務フローに自然に組み込むことを目指す。目指す到達点は、業務フローの中での技術の適切な位置付けである。
-
小さく試す(PoC):選定した業務に対して、技術の小規模な試験運用を行う。これにより、実際の業務での有効性を確認し、必要な調整を行うことを目指す。目指す到達点は、技術の実用性を確認し、フィードバックを得ることである。
-
運用と横展開:試験運用の結果を基に、正式な運用を開始し、他の業務への展開を図る。目指す到達点は、全社的な導入と運用の安定化である。
この一連のプロセスを通じて、最終的には、業務の効率化とコスト削減を実現することが目指される。導入によって得られる成果は、空間理解の精度向上や業務の省力化に寄与することが期待される。
今後の展望
今回の成果は、詳細な幾何情報を外部から与えるよりも、モデル自身に場面を再構成させる方が有効である可能性を示した。しかし、評価はベンチマーク上の結果に基づいており、照明条件の悪い現場や動的に変化する環境、大規模な屋外空間での頑健性については、実運用に向けてさらなる検証が必要である。また、推論時の計算負荷や応答遅延も、リアルタイム用途では導入判断の要素となる。
今後は、ロボットの行動計画や拡張現実、自動運転支援など、空間理解と言語指示を結びつける用途への展開が焦点となる。実務側では、自社の撮影条件に近いデータでの概念実証を通じて、精度と運用コストの両面から適用範囲を見極めることが求められる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AIが能力を隠せると証明、評価の限界露呈
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

ReLU網が描ける形状の規模を数学が証明
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

概念を隠して画像AIの判断根拠を探る新手法
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
