AI×経営戦略
異種画像生成AIを共通空間でつなぐ手法が登場
異なる構造の画像生成AIの途中経過を共通の潜在空間で受け渡し、生成を引き継ぐ技術InstantFusionが提案された。モデルを再学習せず組み合わせられ、運用の柔軟性を高める。
全セクション横断 34 件
異なる構造の画像生成AIの途中経過を共通の潜在空間で受け渡し、生成を引き継ぐ技術InstantFusionが提案された。モデルを再学習せず組み合わせられ、運用の柔軟性を高める。
動画生成AIが物理法則や単純な規則を破る問題に対し、高ノイズ段階で順次生成し低ノイズ段階で一括精緻化するS2PDが提案された。生成映像の信頼性向上に道を開く手法である。
中国・米国の研究チームが、拡散モデルを少ステップで動かす蒸留手法DMADを発表した。補助モデルを不要とし、1~4ステップで教師モデルを上回る品質を示し、生成コストの削減に道を開く。
Tom Goldstein氏らの研究チームは、球面の潜在空間から画像を生成するオートエンコーダ「Sphere Encoder 2」を発表した。生成の速さと単純さを保ちつつ画質を高め、低コストな画像生成の実用化に寄与する。
米研究者らが、学習済みの画像生成AIに手を加えず、エッシャー「プリント・ギャラリー」風の自己参照構図を生成する手法を提案した。画像と歪みを同時に生成する点が特徴である。
生成モデルで意味クラスが確定する時期と、局所的な文脈だけでは生成できなくなる時期が重なる理由を、理論的に証明した研究が登場した。モデル設計や推論効率の指針となる。
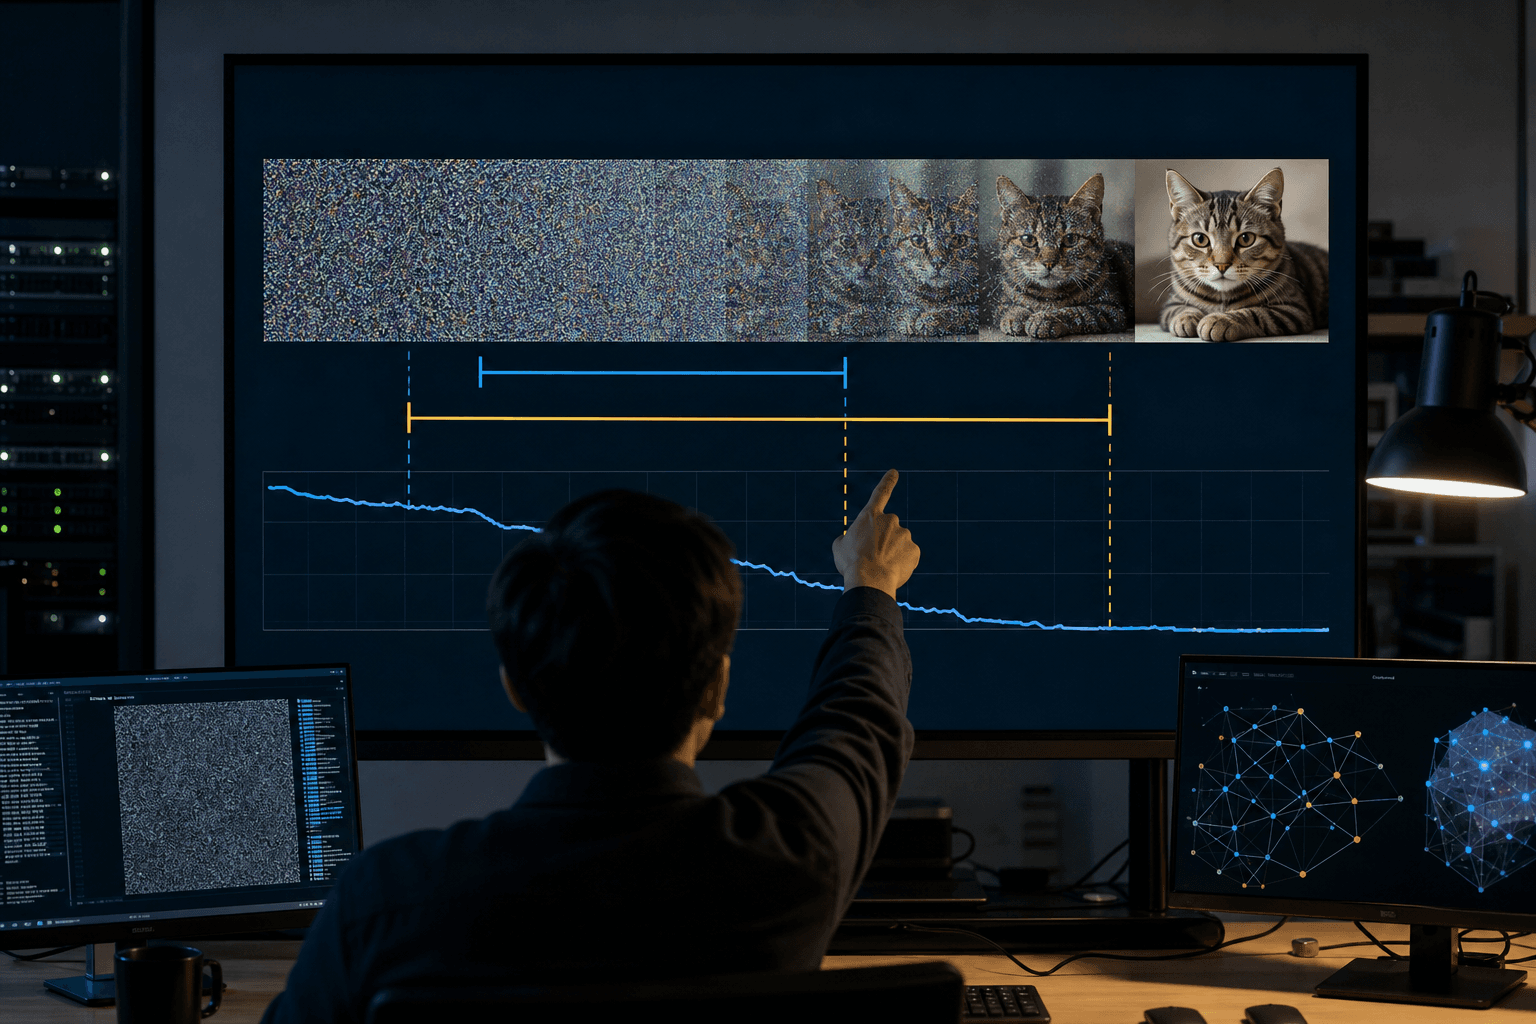
動画拡散モデルを4回の推論で動かす蒸留手法に、学習の劣化を抑える新手法PDMDが登場した。コード1行の変更で品質が向上し、動画制作の生成コスト削減に寄与する可能性がある。
逆拡散を用いる生成AIの標本抽出について、データの凸性を仮定しない一次定常性の理論保証を、統計研究者らが示した。品質検証の根拠として産業応用の信頼性向上につながる。
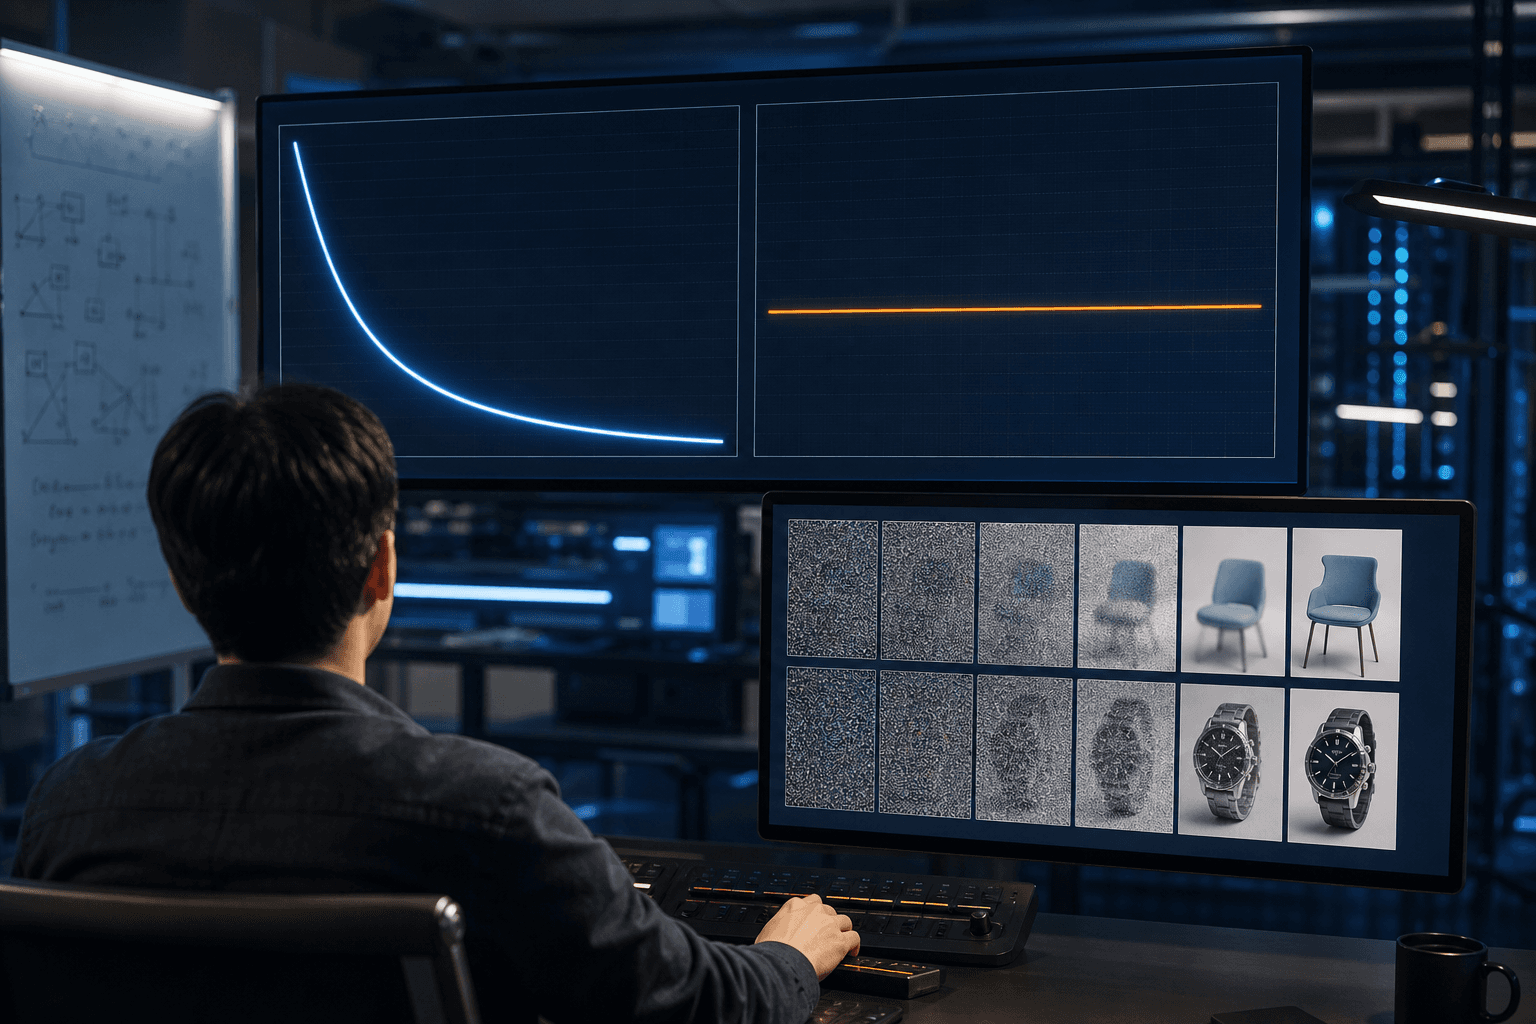
国際研究チームが、画像生成AIの内部表現統合を頑健化する新手法「FuseReg」を発表した。エンコーダー層の組み合わせをランダムに学習させることで、モデル再学習なしに生成品質を最大29%改善できるという。
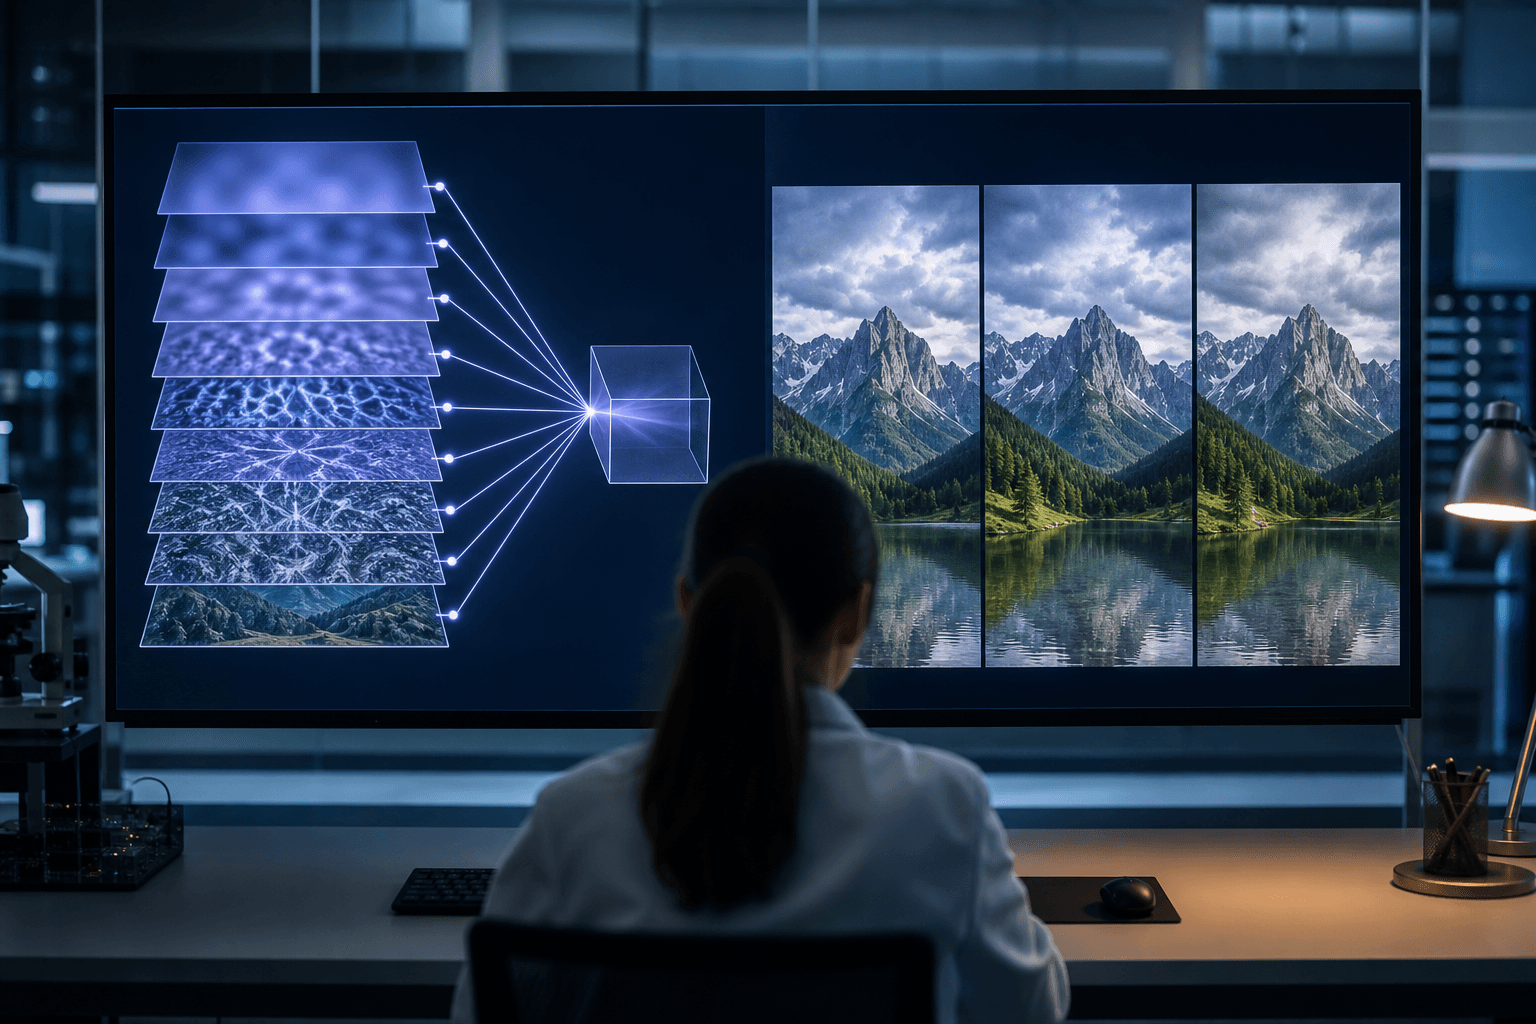
Googleらの研究チームが、単一画像から3D形状を高精度に推定する新手法「PointDiT」を発表した。既存の複雑なモデルを凌駕しつつ構造を大幅に簡素化しており、製造・小売・建設など幅広い産業でのコスト削減が期待される。
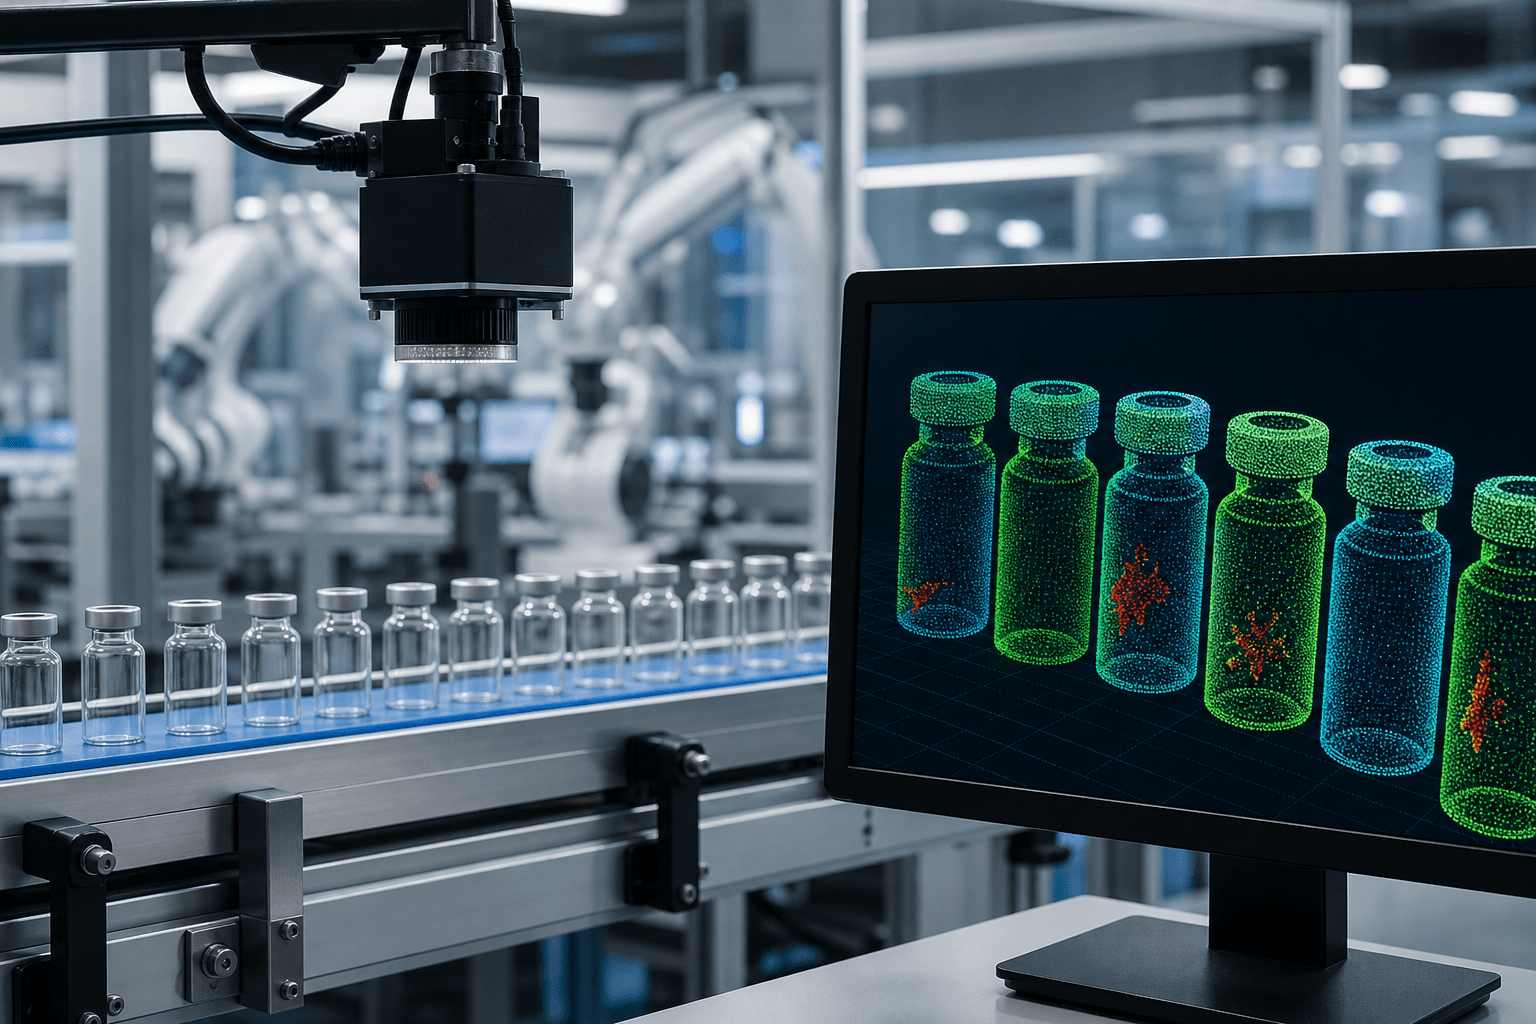
中国・浙江大学らの研究チームが、テキストや画像など任意の入力から動く3Dコンテンツを自動生成するフレームワーク「Align4D」を発表した。製造・エンタメ・EC業界のコンテンツ制作コストを根本から変える可能性がある。
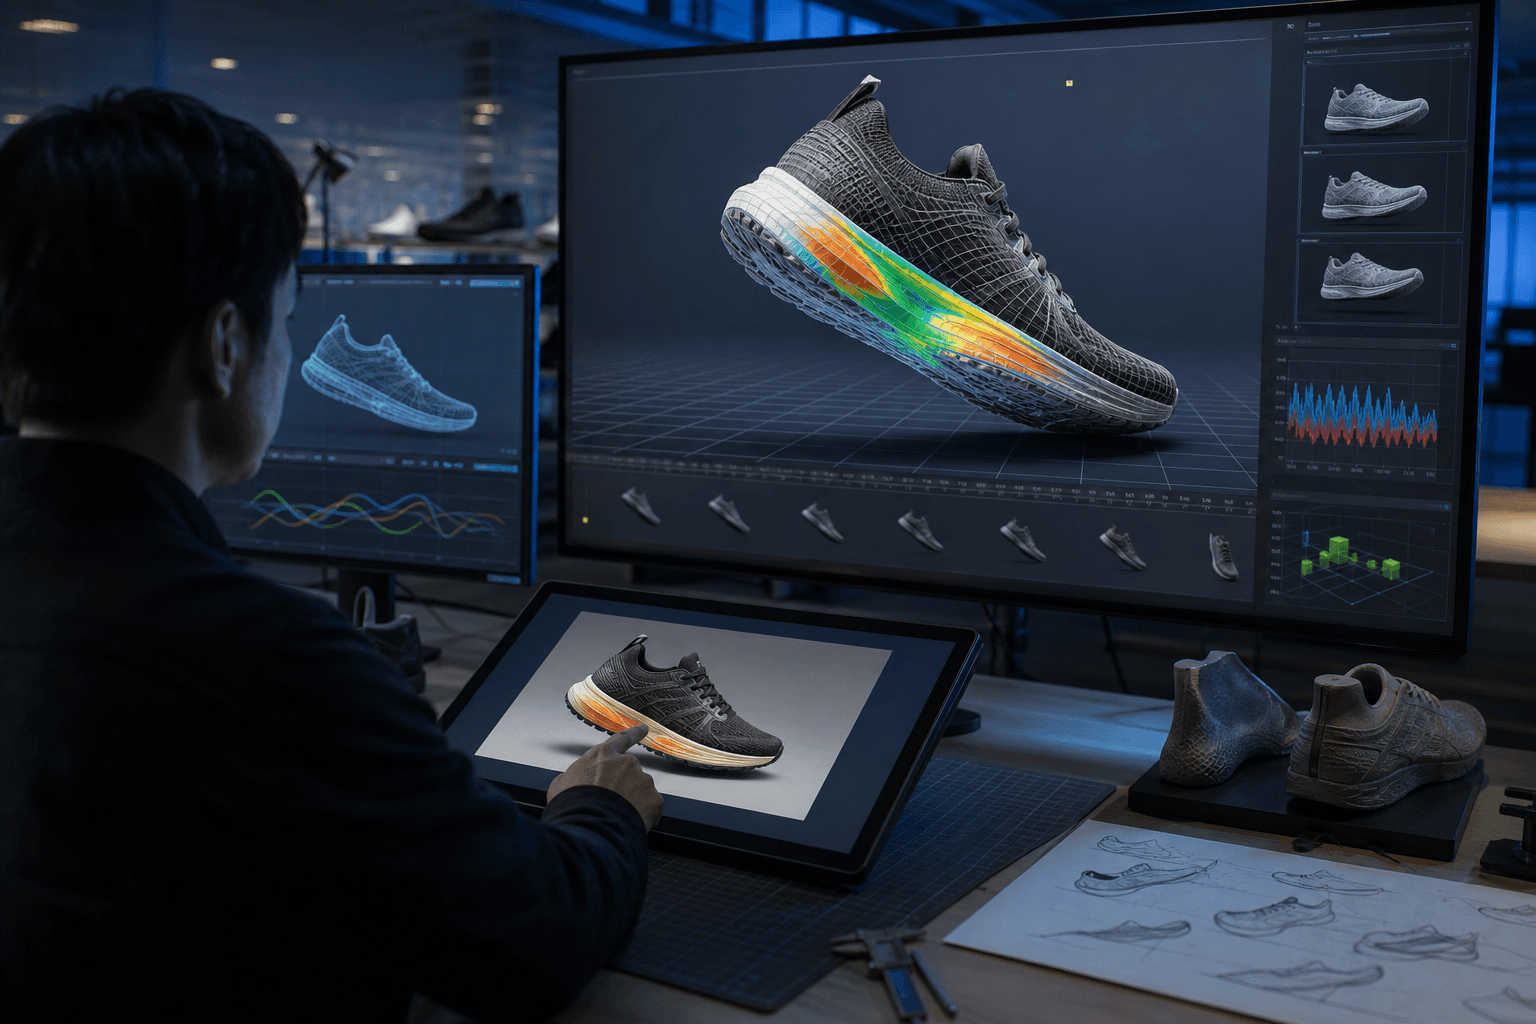
イスラエル・米国の研究チームが、追加学習なしに360度パノラマ画像・動画を生成するAIフレームワーク「SpheRoPE」を発表した。不動産・観光・XR産業のコンテンツ制作コストを根本から変える可能性がある。
中国の研究チームが発表したAI楽曲生成システム「LeVo 2」が、専門家による聴取評価で商用サービスに匹敵する品質を達成した。音楽制作コストの大幅削減と、広告・ゲーム・映像産業のコンテンツ制作工程の再編につながる可能性がある。
ドイツ自動車系研究グループが、自律走行車の閉ループ交通シミュレーションを拡散モデルで高速かつ制御可能にする新手法を発表した。開発コスト削減と安全検証の効率化に直結する成果として注目される。
京都大学などの研究チームが提案した新正則化手法「LISA」が、AIによる条件付き画像・動画生成モデルの学習収束を大幅に加速させることが判明した。広告・映像制作・製造業のコスト削減に直結する成果として注目される。
拡散モデルを用いた新たな画像編集技術「ICRDrag」が登場した。領域単位での直感的な形状変形を高精度で実現し、製造・広告・EC業界のビジュアル制作コスト削減に直結する可能性がある。
米スタンフォード大学などの研究チームが、単眼動画から任意の視点の新規動画を高精度で生成する新フレームワーク「MVTrack4Gen」を発表した。映像制作・不動産・ECなど複数産業のコスト構造を根底から変える可能性がある。
京都大学らの研究チームが、1ステップ拡散モデルによる画像編集の精度を大幅に向上させる手法を発表した。広告・EC・ゲーム開発などクリエイティブ産業のコスト構造を根本から変える可能性がある。
研究者らが画像1枚から高忠実度の3Dアセットを自動生成するAIフレームワーク「FLUX3D」を発表した。製造・小売・エンタメ業界の3Dコンテンツ制作コストを大幅に圧縮する可能性がある。
米カーネギーメロン大などの研究チームが、拡散モデルの低次元適応特性が係数選択に依存しない堅牢な性質であることを数学的に証明した。生成AIの実用展開における設計の自由度を大幅に高める成果として注目される。
カリフォルニア工科大などの研究チームが開発した動画編集AI「Vera」は、既存映像の人物・背景を改変せずにエフェクトや表現を追加する層分離技術を実現。広告・映像制作業界における制作コストと品質管理の課題を同時に解消しうる。
米独欧の研究チームが、参照画像から人と物体の自然なインタラクション動作を自動生成するAIシステム「IMAGIN-4D」を発表した。キャラクター制作やロボット訓練の工数を大幅に削減できる可能性がある。
インド科学院などの研究チームが、参照画像を用いた拡散モデルの推論速度を最大4倍に高める手法「Sparse Context」を発表した。商用画像生成サービスのコスト構造を根本から変える可能性がある。
カーネギーメロン大学などの研究チームが、通常のカメラ映像から動く物体の4次元モデルを高精度で生成するフレームワーク「Lift4D」を発表した。専用機材なしに3次元形状と時間変化を同時に捉えられる点が産業界に広く波及する可能性を持つ。
画像と3D点群データを組み合わせた新手法「CMDS-AD」が、わずか1枚の正常品画像から高精度な異常検知を実現した。製造業の品質管理工程における検査コスト削減と不良品流出防止に直結する成果として注目される。
京都大学らの研究チームが動画生成AIの品質評価を生成途中の「ノイズ状態」から直接実施できる手法「PRISM」を開発した。従来比で大幅な計算コスト削減が見込まれ、映像制作・広告業界のAI活用コスト構造を根本から変える可能性がある。
スペインの研究者が拡散モデルの中核機能である時刻埋め込みを除去しても画像生成品質が維持され、一部指標では向上することを実証した。AI開発コストの削減と推論高速化に直結する知見として注目される。
ハンブルク大学の研究チームが、音声識別用に学習済みのモデルを拡散型音声生成AIへ転用する手法を開発した。モデル二重管理の廃止により、音声AI導入コストの大幅削減が見込まれる。
米台の研究チームが、視点によって異なる意味を持つ3Dオブジェクトをテキスト指示のみで3〜5分以内に生成するAIフレームワーク「JanusMesh」を発表した。従来比で大幅な時間短縮を実現し、広告・小売・エンターテインメント産業に実用的な応用が見込まれる。
従来の評価指標AUCがディープフェイク検知器の実力を過大評価する欠陥を持つことが判明した。新指標「Cross-AUC」の導入により、金融・メディア・法務部門における偽造コンテンツ対策の信頼性評価が根本から変わる可能性がある。
米テキサスA&M大学らの研究チームが、3次元顔モデルの年齢を高精度かつ視点一貫性を保って変換するAIフレームワーク「ReAge3D」を発表した。映像制作コストの削減から医療シミュレーションまで、幅広い産業への応用が見込まれる。
京都大学らが開発したMOCHIは、複数人が物体を共同操作する動作データのノイズを自動修正する技術である。製造業や医療、エンタメ分野でのAI訓練データ取得コストを大幅に削減する可能性がある。
拡散モデルを用いた画像復元において事後スコアを閉形式で導出する新手法「EPS」が登場した。医療画像診断や製造業の品質管理など、劣化画像の高精度復元が求められる産業分野での業務効率化に直結する成果である。
米ワシントン大学らの研究チームが、スマートフォン1台で撮影した動画から動的な4Dデジタルヒューマンを自動生成するAIモデル「Flex4DHuman」を発表した。ゲーム・AR/VR・映像制作などの制作コストを根本から変える可能性がある。