動画生成AI、直列と並列の併用でルール違反を抑制
動画生成AIが物理法則や単純な規則を破る問題に対し、高ノイズ段階で順次生成し低ノイズ段階で一括精緻化するS2PDが提案された。生成映像の信頼性向上に道を開く手法である。
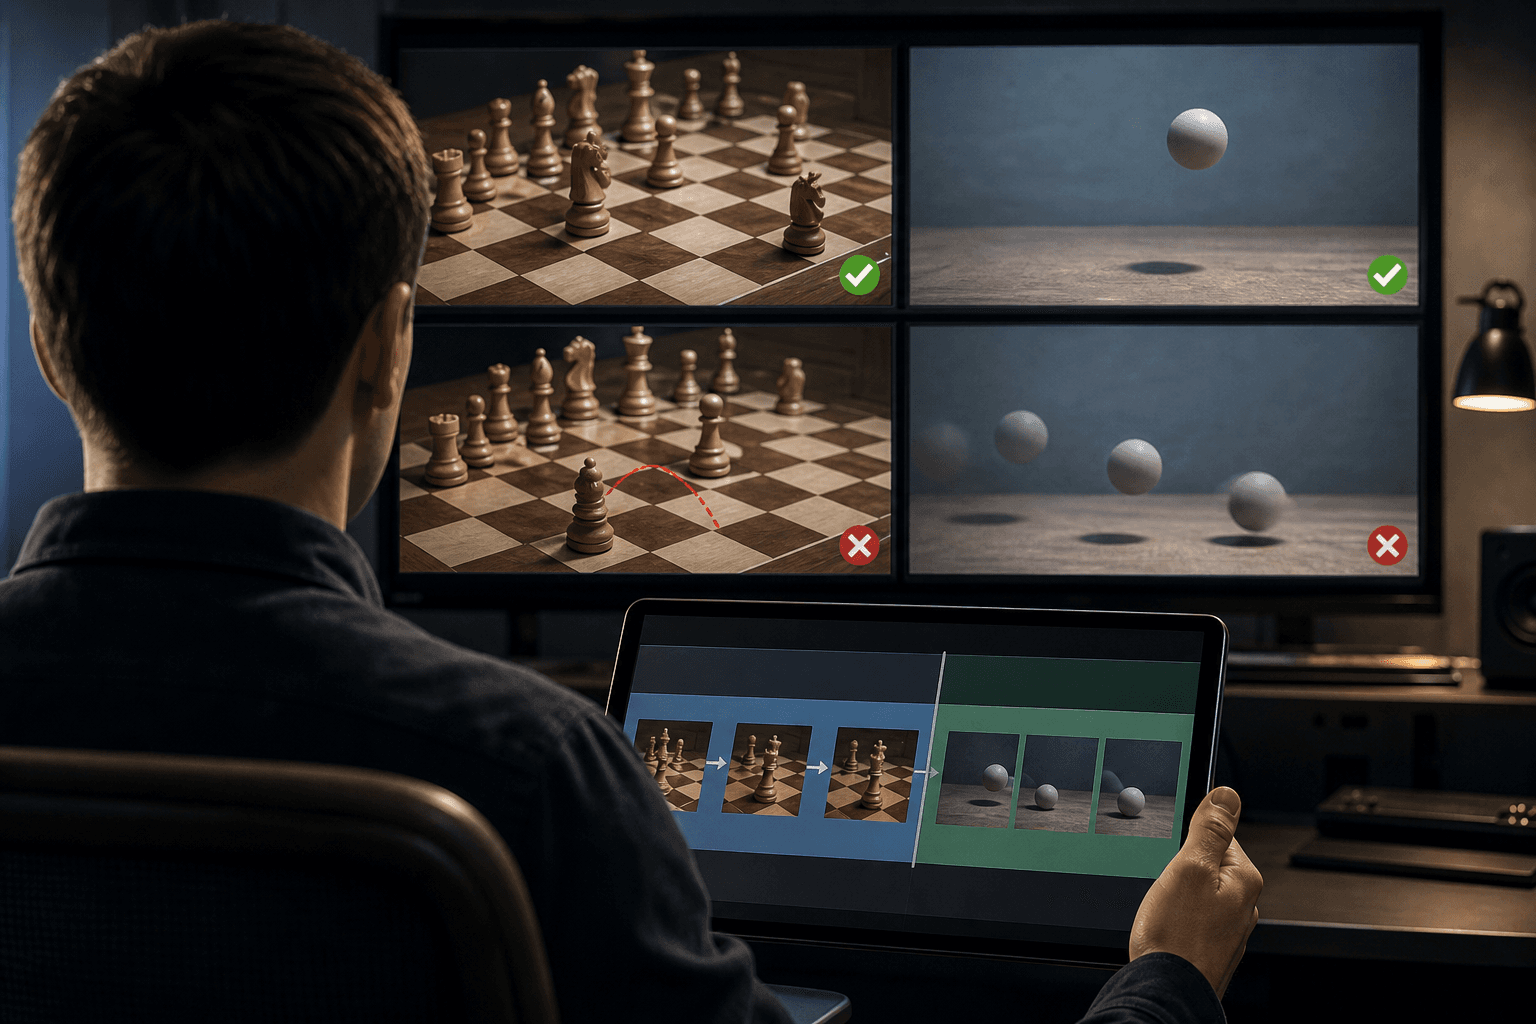
研究の概要
動画生成AIの主流は、動画全体を対象に段階的なノイズ除去を行う「双方向拡散モデル」である。この方式では、全フレームを同時に扱うため見た目の一貫性は出しやすいが、研究チームは大量の学習データを与えた場合でも物理法則や単純な記号的規則を破り続けるという問題を指摘している。具体的には、因果関係や順序が重要な場面で不適切な状態遷移が発生し、結果として業務利用に耐えうる信頼性を欠くことがある。
提案された手法はSerial-to-Parallel Diffusion(S2PD)と呼ばれる。生成過程を二段階に分割する点が特徴である。ノイズが大きい初期段階では、フレームを時間順に一つずつ生成する自己回帰型の拡散を用い、個々のフレーム間の因果や規則性を直列的に担保する。ノイズが小さくなった後段では、全フレームを同時に並列で精緻化し、画質と時間的整合性を高める。
実装は二通り提示されている。一つはピクセル空間の拡散トランスフォーマーを一から学習する構成、もう一つは既存の学習済み動画モデルに因果的注意機構を導入し、LoRAのような軽量微調整で適合させる構成である。評価はゲーム、物理シミュレーション、実写動画を対象に行われ、条件を揃えた双方向ベースラインよりもルール順守性が高く、他の直列手法と比べて時間的安定性とサンプリング効率に優れると報告されている。
しくみをやさしく
S2PDの核心は「直列」と「並列」を役割分担させる点である。生成開始時点は情報が断片的で不確かであるため、時間的順序に沿って一コマずつ作ることで、因果の鎖や手順の一貫性を確保する。例を挙げれば、ボードゲームで一手を打つたびに盤面が正しく変化すること、物体の衝突によって次の動きが決まることを、まずは順序立てて作る段階で担保している。
その後、画面全体の見栄えや細部のブレを取り除く段階で並列処理に切り替える。並列処理は全フレームを同時に整えるため、時間的ノイズの均質化や画質向上に寄与する。結果として、直列で得た因果的一貫性を保持しつつ、全体の見た目や再生中の安定感を高めることができる。
技術実装面では、直列部分に因果的注意機構や自己回帰的拡散を導入し、並列部分は既存の並列拡散ネットワークで仕上げる構成が取られる。既存モデルへの適応では、全重みを学習し直すのではなく、因果的注意を付加した上でLoRAのような軽量微調整を行う現実的選択肢が示されている。これにより、大規模な再学習コストを抑えつつ因果性の改善を図れる点が利点である。
ビジネスへの示唆
動画生成AIが業務に入ると、「見た目は自然だが中身が間違っている」映像が生じることが最も大きな障害となる。これにより発生するのは、誰かが目視で確認して差し戻すという人的コストである。自部署で動画生成を使う場面を想像し、いま誰がどれだけ検収に手をかけているかを具体的に問い直すことが重要である。
自部署での該当業務を見立て、次の問いを立ててほしい。例えば、自社の教育用動画や操作手順を生成している場合、現在どの程度の時間を担当者が確認・修正に費やしているか。マーケティングの動画広告で誤った使用手順が入ると差し戻しや法務対応が発生しているか。ゲームの演出でルール違反があると後工程でやり直しが発生していないか。回答はKPIとして次のように結びつく。
- 検収工数(人時):検収にかかる合計時間。整合性が改善すれば削減される可能性がある。
- 手戻り率(差し戻し件数/作成件数):規則違反によるやり直しの割合。低下すれば全体コストが下がる。
- 選別コスト(データの除外・検品時間):学習や検証用に生成した映像を選別する工数。物理的不整合が減れば効率化につながる。
これらは速度や画質ではなく、確認工数と手戻り率が主要評価軸となる点を示す。導入検討時は、自部署の代表的な定常業務を一つ選び、上記のKPIを起点に効果試算を行うことを推奨する。
現場での導入イメージ
仮に導入支援に入るなら、以下の四段階で進める。
-
棚卸し:まず、動画生成を現状利用している業務、あるいは導入を検討している業務を洗い出す。特に「ルール違反の生成物が出て人が直している」箇所を可視化する。到達点は、整合性の誤りが最も手間を生んでいる業務と担当者を特定し、現在の検収時間と担当の実感を数値化して共有することである。
-
差し込み先の設計:既存の制作フローや外部サービスを変えずに、どの段階でS2PD的な処理を差し込むかを設計する。具体的には既存の学習済みモデルへ因果的注意を付加するか、生成後の検査工程に整合性検出を組み込むかを検討する。到達点は、既存ツールを増やさずに整合性を改善できる接続点を決め、実装上の最低限の改修計画を確定することである。
-
小さく試す(PoC):対象を一部署や一プロジェクトに限定し、規則が明確な題材で短期間の試験を行う。PoCでは担当者が検収で直す回数や手戻り感を従来方式と比較して定量・定性で記録する。到達点は、現場の実感として「確認が楽になった」「手戻りが減った」と言えるかどうかの判断材料を得ることである。
-
運用と横展開:PoCの成果を踏まえ、整合性判定基準と検収手順を文書化し、他部署へ横展開するための教育とチェックリストを整備する。到達点は、誰が見ても同じ判断が下せる運用基準を整え、現場で再現可能な運用体制を構築することである。
最終的に目指すエンドステートは、動画生成AIの出力が「毎回人が疑って見る」状態から、「要所だけオペレーターが確認すれば足りる」状態へ移行することである。これにより検収工数と手戻り率が低減され、AI活用による業務効率化が現実的になる。
今後の展望
直列と並列を組み合わせる発想は、動画生成にとどまらず、因果や手順を伴う生成タスク全般に応用できる余地がある。とはいえ、実写動画における複雑な社会的・物理的規則すべてを満たせるかは今後の検証課題である。企業は速度や画質に加えて整合性を評価軸に組み込み、業務適用の段階で段階的なPoCと運用基準の整備を進めることが望まれる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AIが能力を隠せると証明、評価の限界露呈
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

ReLU網が描ける形状の規模を数学が証明
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

概念を隠して画像AIの判断根拠を探る新手法
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
