単眼動画から4D人体を自動生成する拡散モデル登場
米ワシントン大学らの研究チームが、スマートフォン1台で撮影した動画から動的な4Dデジタルヒューマンを自動生成するAIモデル「Flex4DHuman」を発表した。ゲーム・AR/VR・映像制作などの制作コストを根本から変える可能性がある。
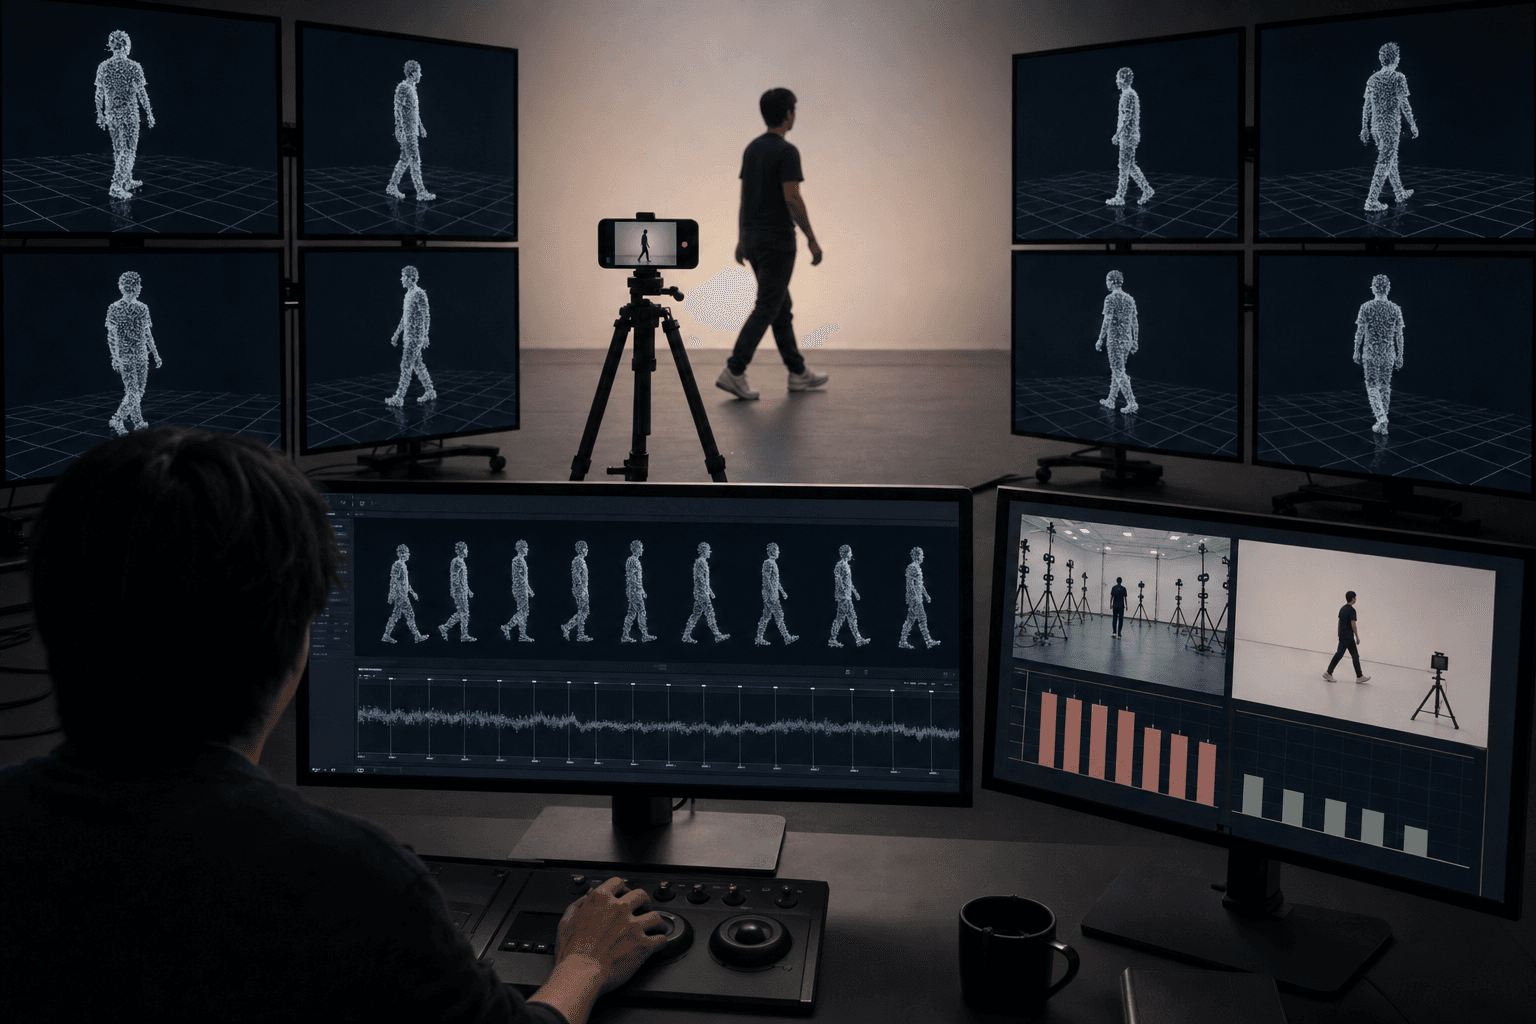
米ワシントン大学などの研究チームは、単眼カメラ映像から高品質な4次元(3D空間+時間軸)の人体モデルを自動生成するマルチビュー映像拡散モデル「Flex4DHuman」を発表した。従来手法が骨格推定や深度マップなど複数の幾何学的前処理を必要としていたのに対し、同モデルはカメラ姿勢の相対的な位置エンコーディングのみを条件として使用し、特殊な事前処理なしに任意視点の同期映像を生成する。
システムの基盤には、中国Wanが開発した13億パラメータのテキスト・トゥ・ビデオモデル「Wan 2.1」を採用する。5軸の位置エンコーディングにより空間・時間・視点方向の情報を統合的に処理し、3段階のカリキュラム学習でポーズ追従、参照視点から目標視点への映像生成、時間的ロールアウトを順次習得させる。生成された多視点映像は、汎用の4Dガウシアンスプラッティング技術に直接入力でき、リアルタイムレンダリング可能な4Dモデルへと変換される。公開ベンチマーク「DNA-Rendering」および「ActorsHQ」での評価では、先行する最先端手法を上回る精度を示した。さらに、人体と動物の混合学習により動物カテゴリへの汎化も確認されている。
ビジネス上の影響は複数の産業に及ぶ。ゲーム・エンターテインメント業界では、モーションキャプチャースタジオや多数のカメラアレイを必要としていた3Dキャラクター制作ワークフローの大幅な簡素化が見込まれる。従来、プロ仕様のキャラクターモデル1体の制作には数百万円規模の設備投資と数週間の制作期間を要していたが、同技術を活用すれば通常の撮影映像からの自動生成が現実的になる。制作リードタイムやコンテンツ制作費用(CPコスト)の削減指標として直接反映される可能性がある。
映像・広告制作部門においては、ロケ撮影後に任意の視点からの映像を再生成する「映像リシュート」機能が注目される。撮影済み素材から新たなアングルを後処理で生成できるため、再撮影に伴う人件費や会場費を削減でき、広告キャンペーンの修正対応コストの低減に寄与する。
AR/VRおよびメタバース領域では、現実の人物をリアルタイムに近い速度でアバター化する基盤技術として機能する。小売業のバーチャル試着サービスや、医療・リハビリテーション分野での患者動作解析への応用も想定される。特に医療機器・リハビリテーション支援の分野では、多視点3D動作データの取得コスト削減が、動作解析の精度向上と普及拡大に貢献しうる。
シミュレーション用途では、自動運転や産業ロボット向けの歩行者・作業者データの合成生成に活用できる。現在、自動運転開発企業が課題とするリアルな歩行者シナリオのデータ多様性確保において、単純な撮影映像から大量の多視点トレーニングデータを生成する手段として機能し、データ取得コストやアノテーション工数の削減に直結する。
課題としては、生成精度が入力映像の品質に依存する点、および商用利用に向けたライセンス体制の整備が挙げられる。研究チームはコードとモデルの公開を予定しており、オープンソース化が進めば中小規模のコンテンツスタジオや開発者による活用が加速する見通しである。4Dコンテンツ制作の民主化という観点から、今後1〜2年での実用展開が注目される。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
画像生成AI、逆流を抑え指示への忠実度向上
画像生成AIが途中経過の誤りを自らの文章理解に反映し、ずれを固定化する現象が判明した。この逆流を抑える新手法SFGは、追加コストを抑えつつ指示への忠実度を高める。
生成AI再撮影の破綻を撮影現場で事前に可視化
撮影後にカメラ動作を変える生成AI再撮影では、未撮影部分の捏造が撤収後に発覚する課題がある。新手法は現場で破綻リスクを即時に可視化し、手戻りの抑制を目指す。
静止3D空間を無限ループ動画化するAI登場
台湾の研究チームが、静止した3D空間に多様な動きを与え、どの視点からも途切れず循環させる手法OuroWorldを発表した。3D空間の「動く資産」化を低コストで進める技術として注目される。