AI×経営戦略
操作信号で動画生成を高速化、新手法
対話型の動画世界モデルで、ユーザー操作の変化に応じ計算を使い分ける手法CtrlCacheが提案された。再学習なしでDiT部の処理を1.21〜1.41倍に高速化し、品質評価も上回った。
対話型の動画世界モデルで、ユーザー操作の変化に応じ計算を使い分ける手法CtrlCacheが提案された。再学習なしでDiT部の処理を1.21〜1.41倍に高速化し、品質評価も上回った。
学習者の成績向上を報酬に強化学習で訓練したAI講師「Sherpa」が、生徒タイプ別の指導を使い分け、全タイプで平均20.5ポイントの成績向上を示した。AI研修の個別最適化に道を開く成果である。
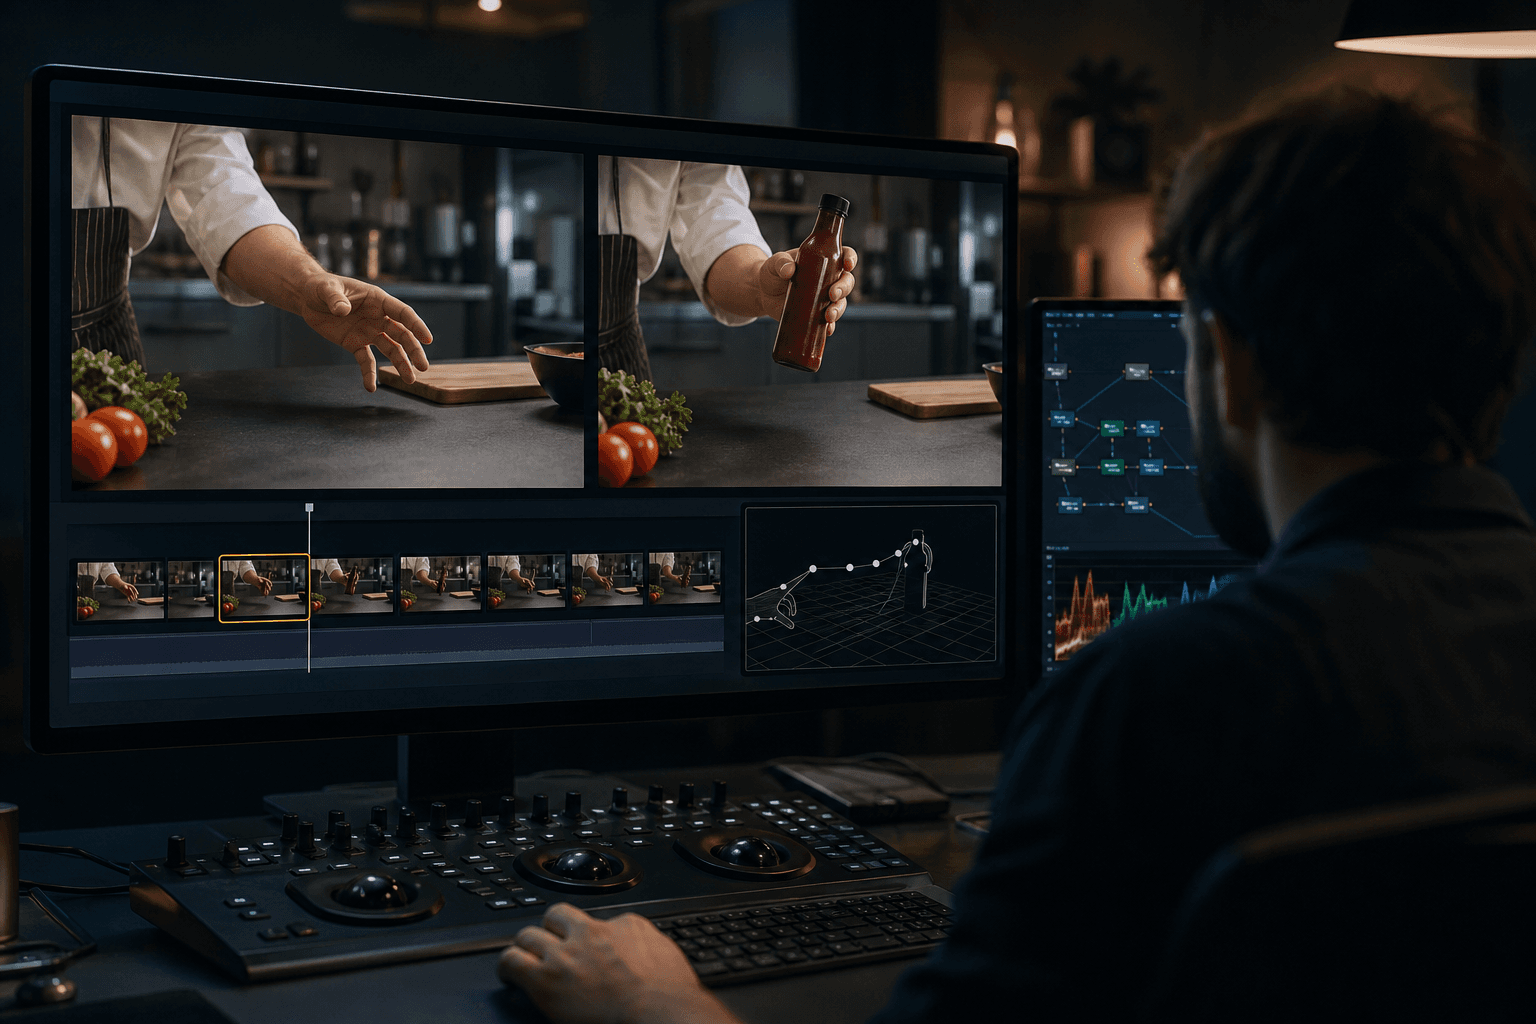
動画に後から加えた物体が、持ち上げられるなど元映像の動作と噛み合うよう編集するAI「ALIVE」が登場した。撮り直しに頼ってきた広告・研修動画の制作工程を変える可能性がある。
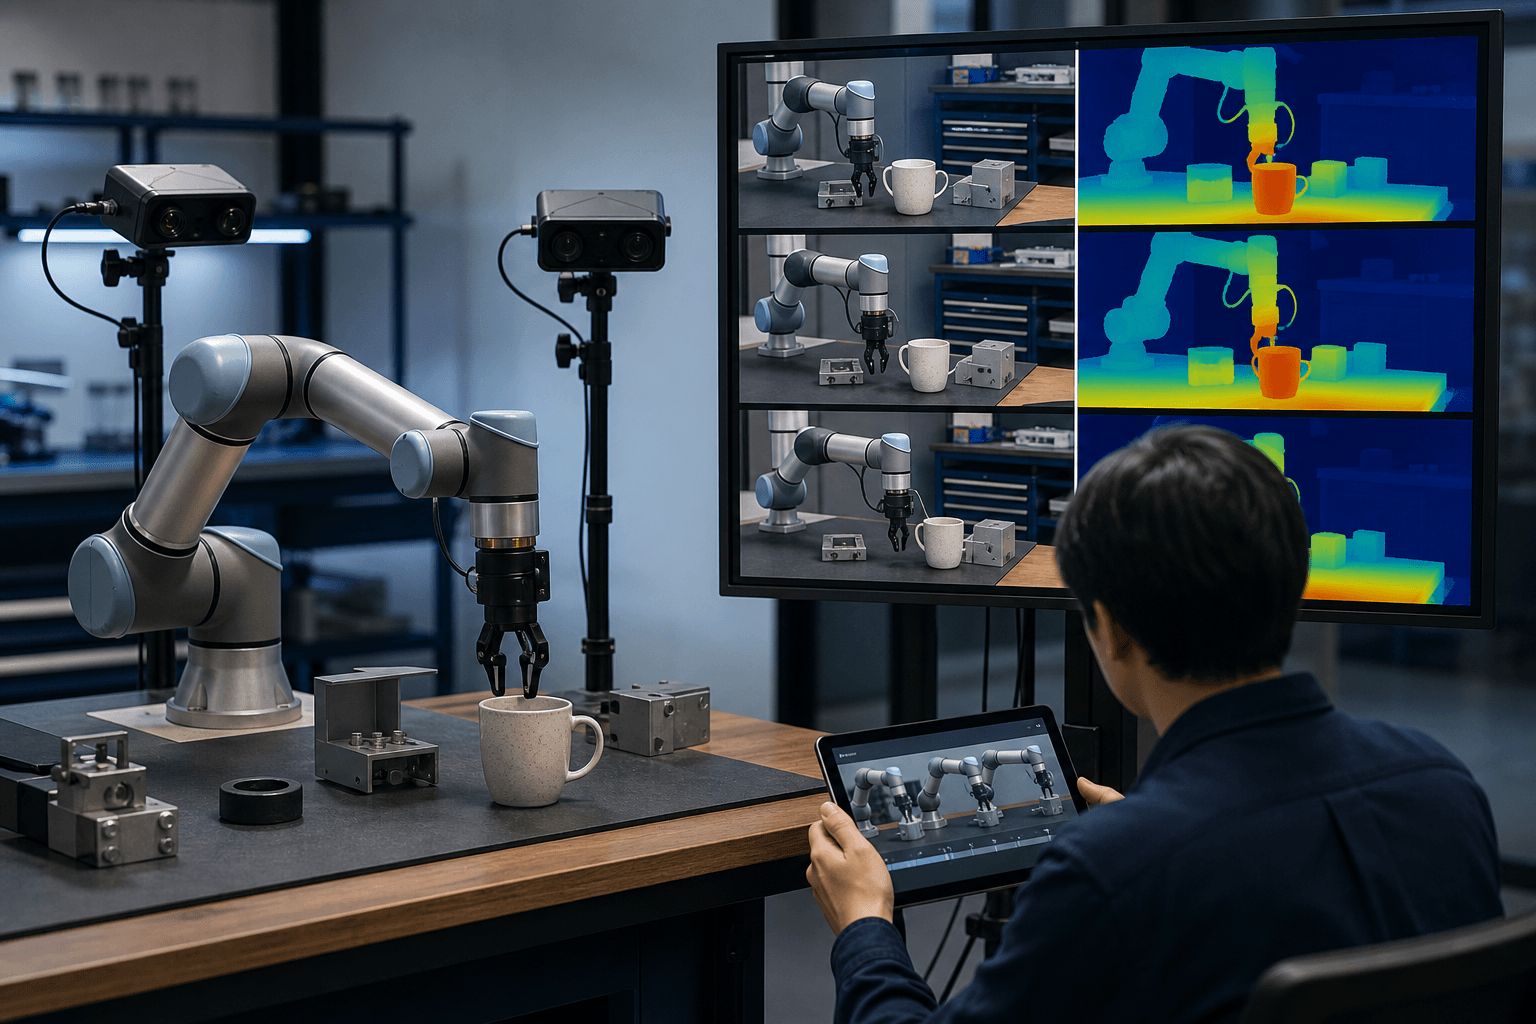
ロボット操作の予測映像に奥行き情報を加えた世界モデル「DepthWorld」が発表された。奥行きの学習が映像予測自体も改善し、実機を使わない動作評価の信頼性を高める可能性がある。
複数の先行論文を統合して新しい研究アイデアを出すLLMの訓練法「IdeaAnchor」が登場した。各論文の役割と合成基準を設計図として学習に使う。R&Dや企画の起案業務を変え得る手法である。
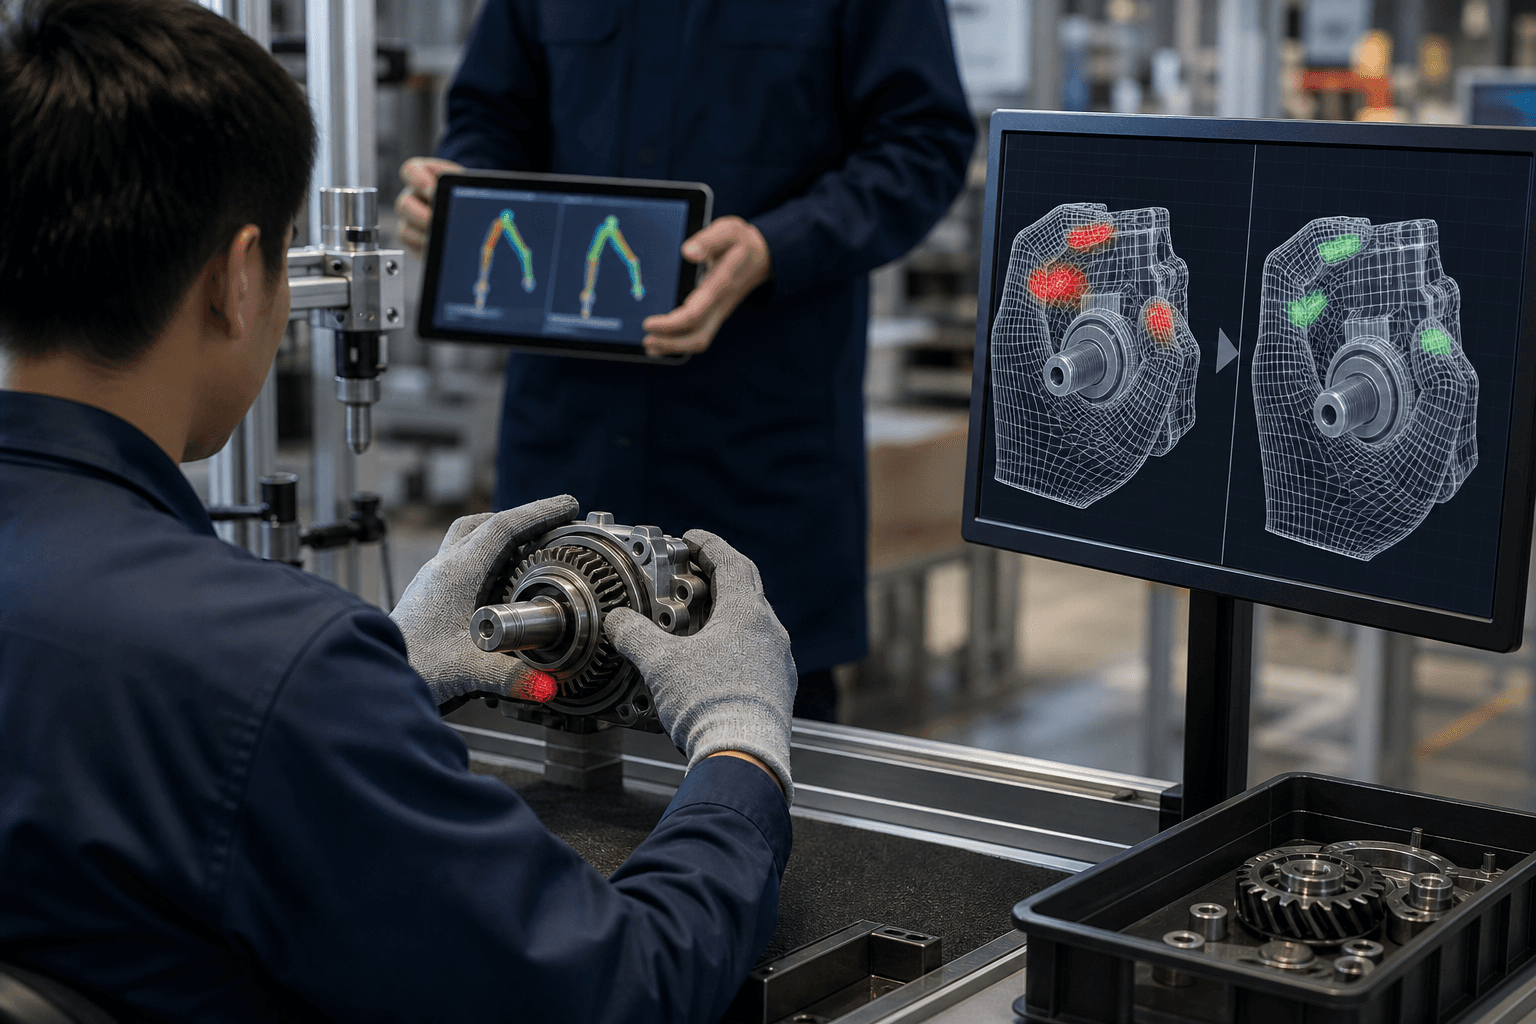
4D-HOFは、基盤モデルの粗い推定を生成モデルで補正し、手と物体の相互作用を単一パスで復元する。物理制約も組み込み、個別最適化を不要にする点が注目される。
コンフォーマル予測の「予測集合の縮み幅」が、情報理論上の情報量として理論的に裏付けられた。特徴量選定やデータ投資の判断基準を、保証付きで見直す契機となる。
米国の研究チームが、フローポリシーを高速に強化学習するQF3を開発した。人型ロボットの歩行を白紙から学習し実機へ直接移植でき、学習時間は従来手法の約10分の1になった。
米国などの研究チームが、1枚の画像から未撮影の裏側まで含む3Dシーンを屋内外とも生成する手法を発表した。現場写真を3D資産へ変える初期コストを下げ、建設や不動産、小売の業務を変える可能性がある。
動画生成AIの物理的な正しさを、光学や流体など40課題で定量測定するベンチマークが提案された。最高モデルでも100点中57.76点にとどまり、実務利用前の検証の必要性が浮かんだ。
ループ型言語モデルで状態が固定点に近づく性質を利用し、学習・復号・RLを効率化する手法が提案された。KVキャッシュを3分の1にしても精度を保ち、運用コスト低減に道を開く。
拡散モデルによる条件付き生成で、逐次モンテカルロ法を途中時点から開始する手法が提案された。同数の粒子で精度が約2倍に高まり、稀な事象の再現では桁違いの改善も確認された。
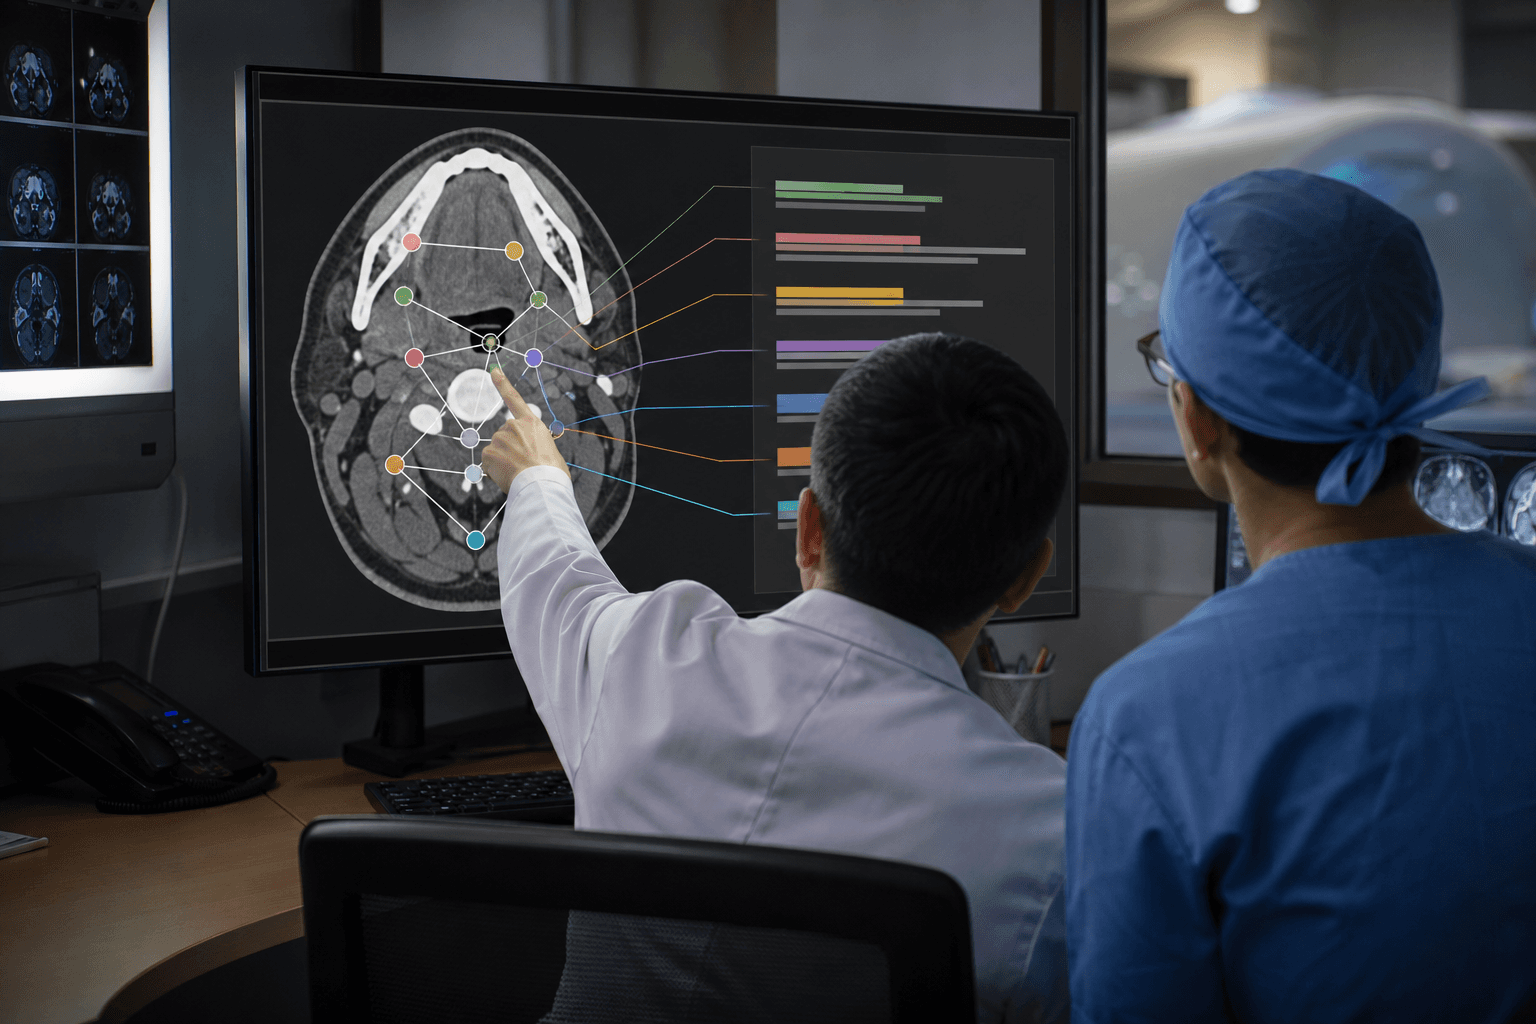
CT画像と読影レポートを臓器単位のグラフで結び付け、喉頭咽頭がんのT分類を予測する枠組みが提案された。腫瘍の手作業での切り出しを要さず、生検に頼る診断の補完を狙う。
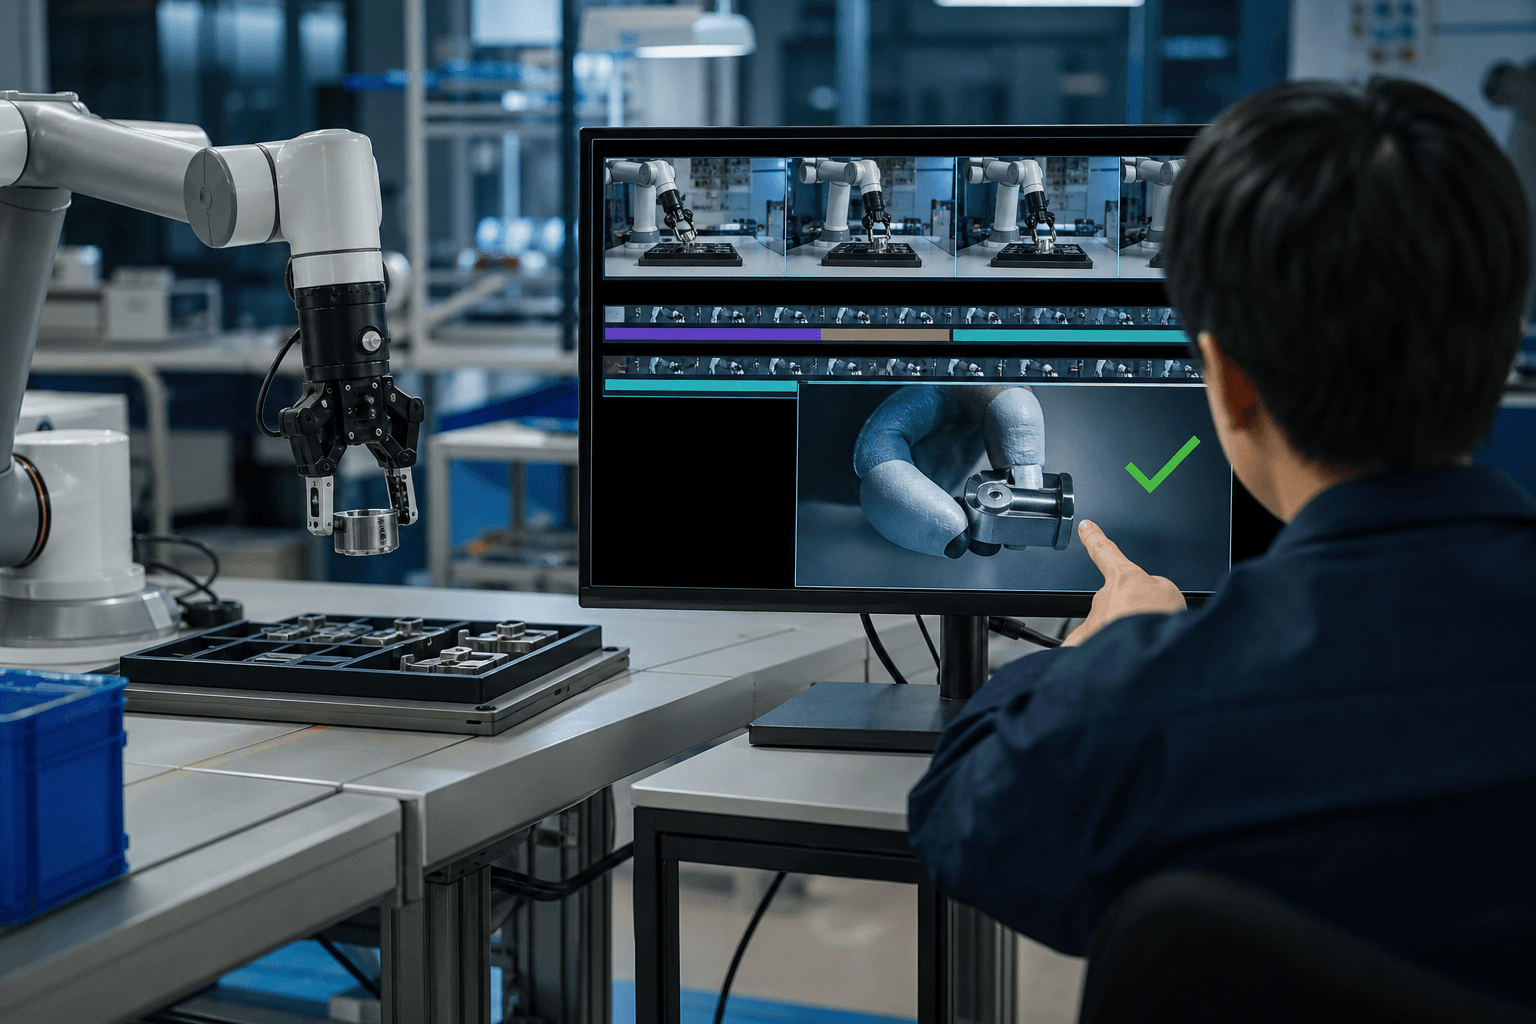
LLMが動かすロボットが、手本動画を階層に整理して必要な場面だけ参照する手法が登場した。1本の動画で追加学習なしに成功率を高め、現場導入の負担を下げる点で注目される。
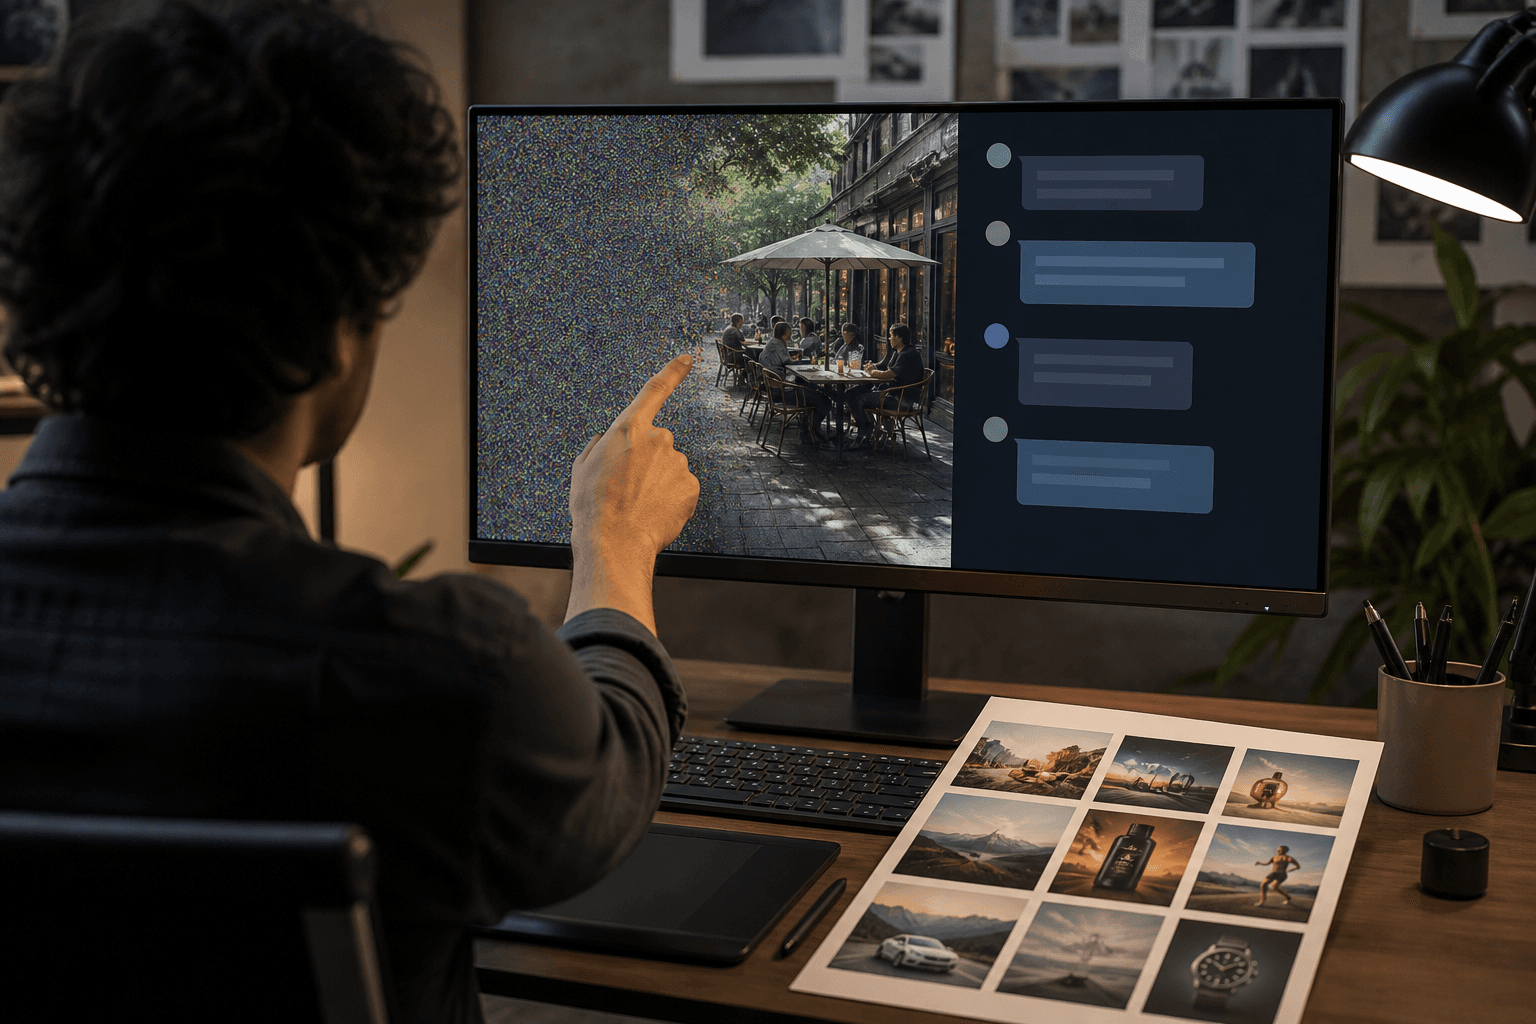
画像生成AIの内部状態に自然言語で質問し、生成途中の絵の中身を読み取る手法が提案された。内部情報を品質改善にも使えると示した点で、制作現場の品質管理に影響しうる。
画像AIが背景など見かけの手がかりに頼る度合いを幾何学的に監視し、抑える手法BiasFlowが登場した。凍結した基盤部分に偏ったデータで新たな出力層を学習させても、最悪グループ精度が40.7%から64.1%に改善した。
動画生成AIが物理法則や単純な規則を破る問題に対し、高ノイズ段階で順次生成し低ノイズ段階で一括精緻化するS2PDが提案された。生成映像の信頼性向上に道を開く手法である。
人の動作データを人型ロボットの実行可能な動作へ変換し、成功した変種だけを再学習に回す枠組み「InterMimicGen」が提案された。少量の実演から作業の網羅範囲を広げる道筋を示す。
基盤モデルの応答冒頭に特定の語を固定するだけで、強化学習済みモデルに迫る数学・コード性能が得られると判明した。再学習なしで性能を引き出す手法として、AI運用コストの見直しにつながる。
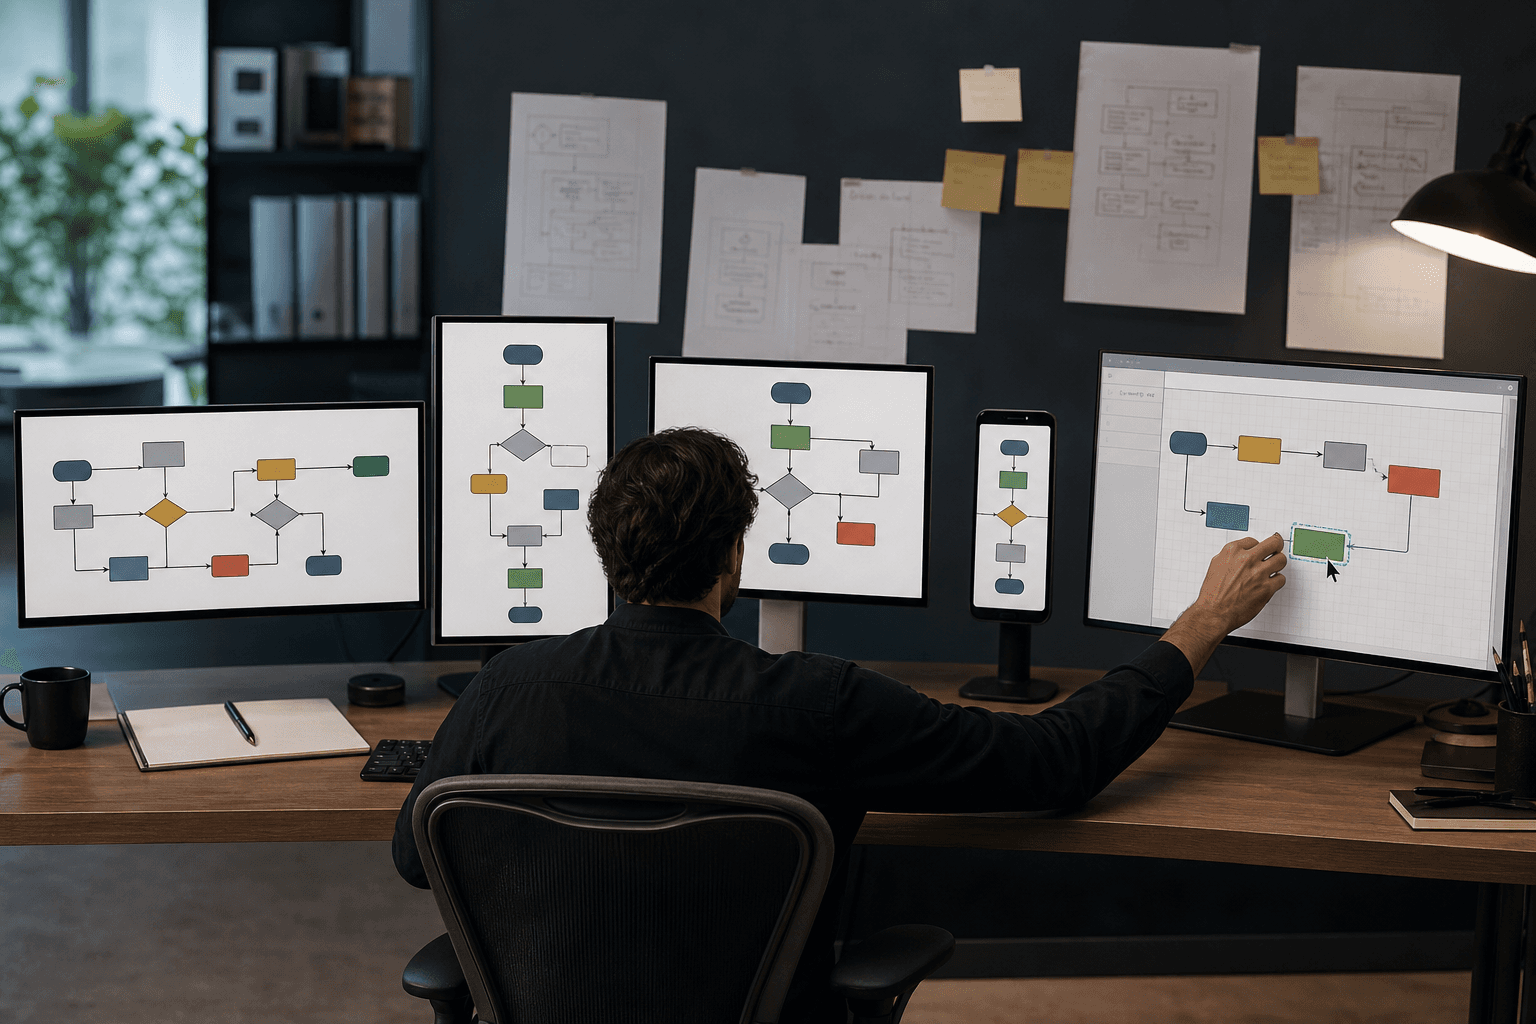
台湾の研究チームが、フローチャート画像を任意の縦横比へ接続を壊さず再配置し、編集可能な形式で出力するAIパイプラインを発表した。資料作成の転用工数を減らす技術として注目される。