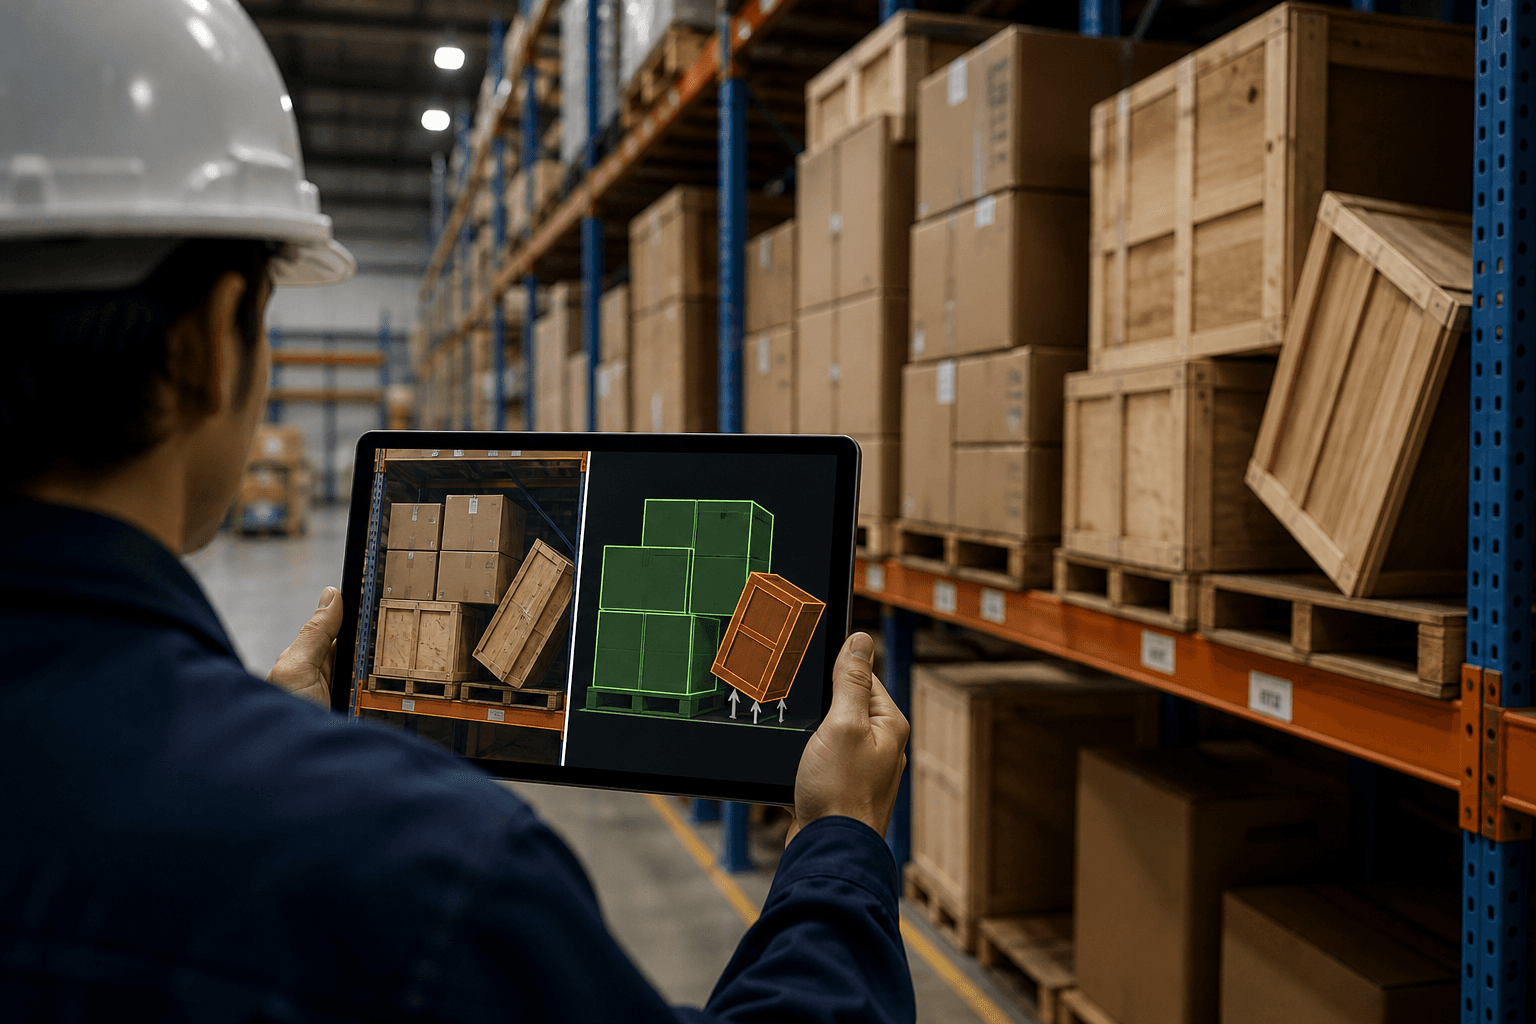
AI×製造
動画生成AI、手順を自ら判断し実行する新手法
研究チームが、初期画像と目標だけから次の行動を決めて動画化し、結果を見て完了まで進める世界モデル「WorldGuide」を発表した。手順書や研修動画の制作を変える可能性がある。
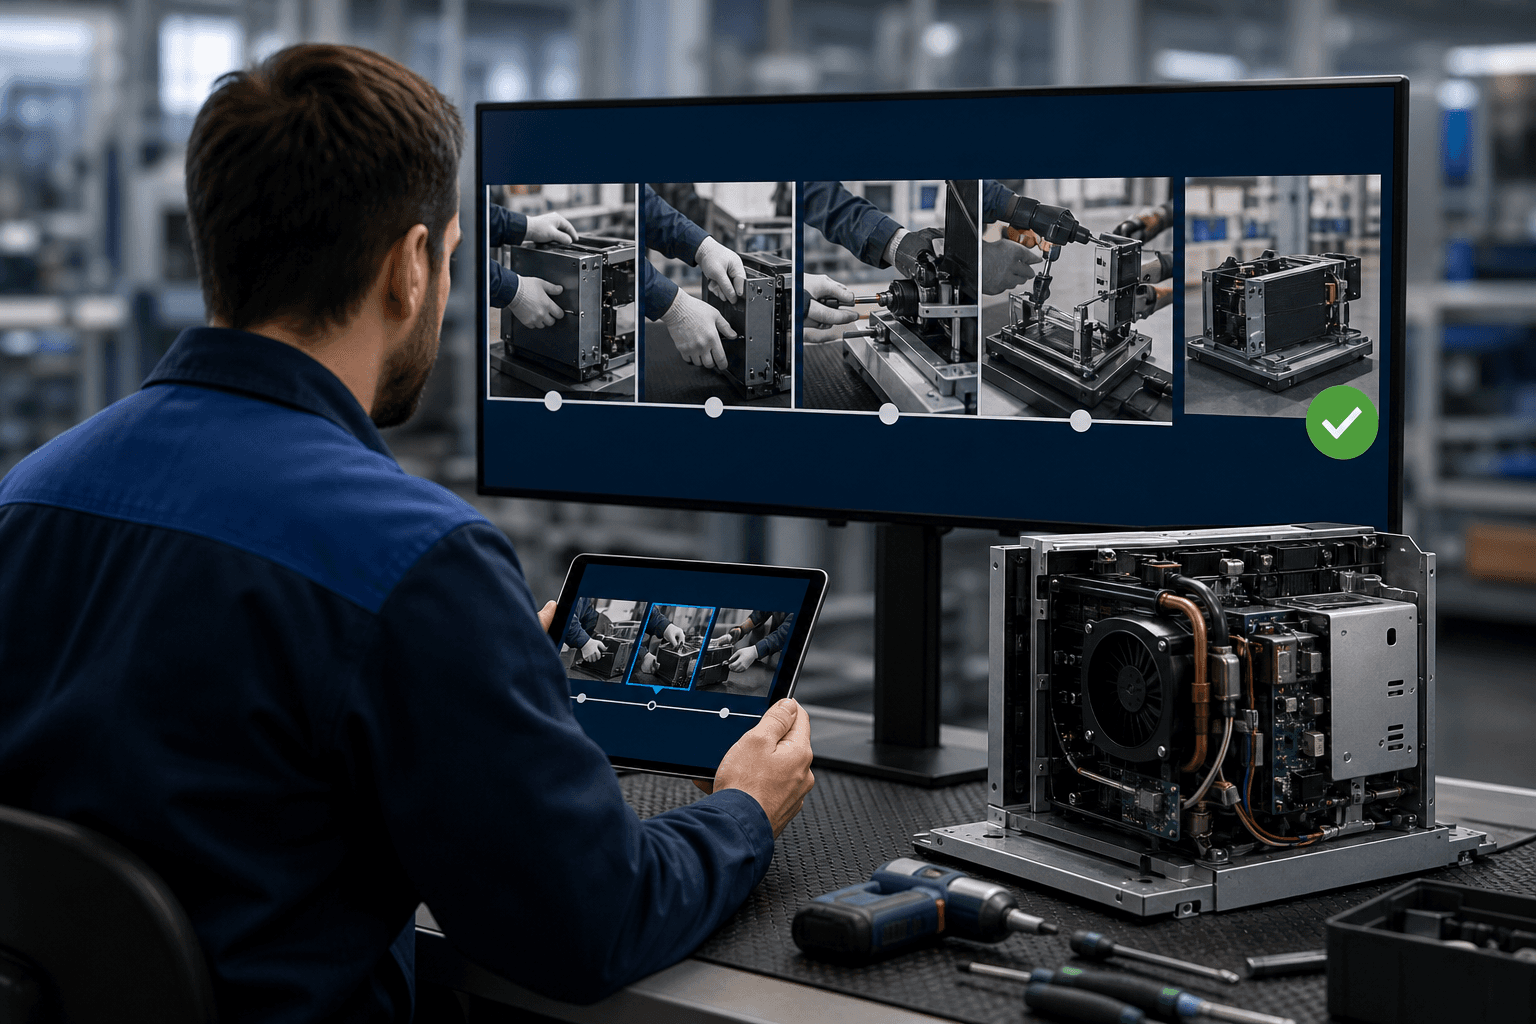
研究チームが、初期画像と目標だけから次の行動を決めて動画化し、結果を見て完了まで進める世界モデル「WorldGuide」を発表した。手順書や研修動画の制作を変える可能性がある。
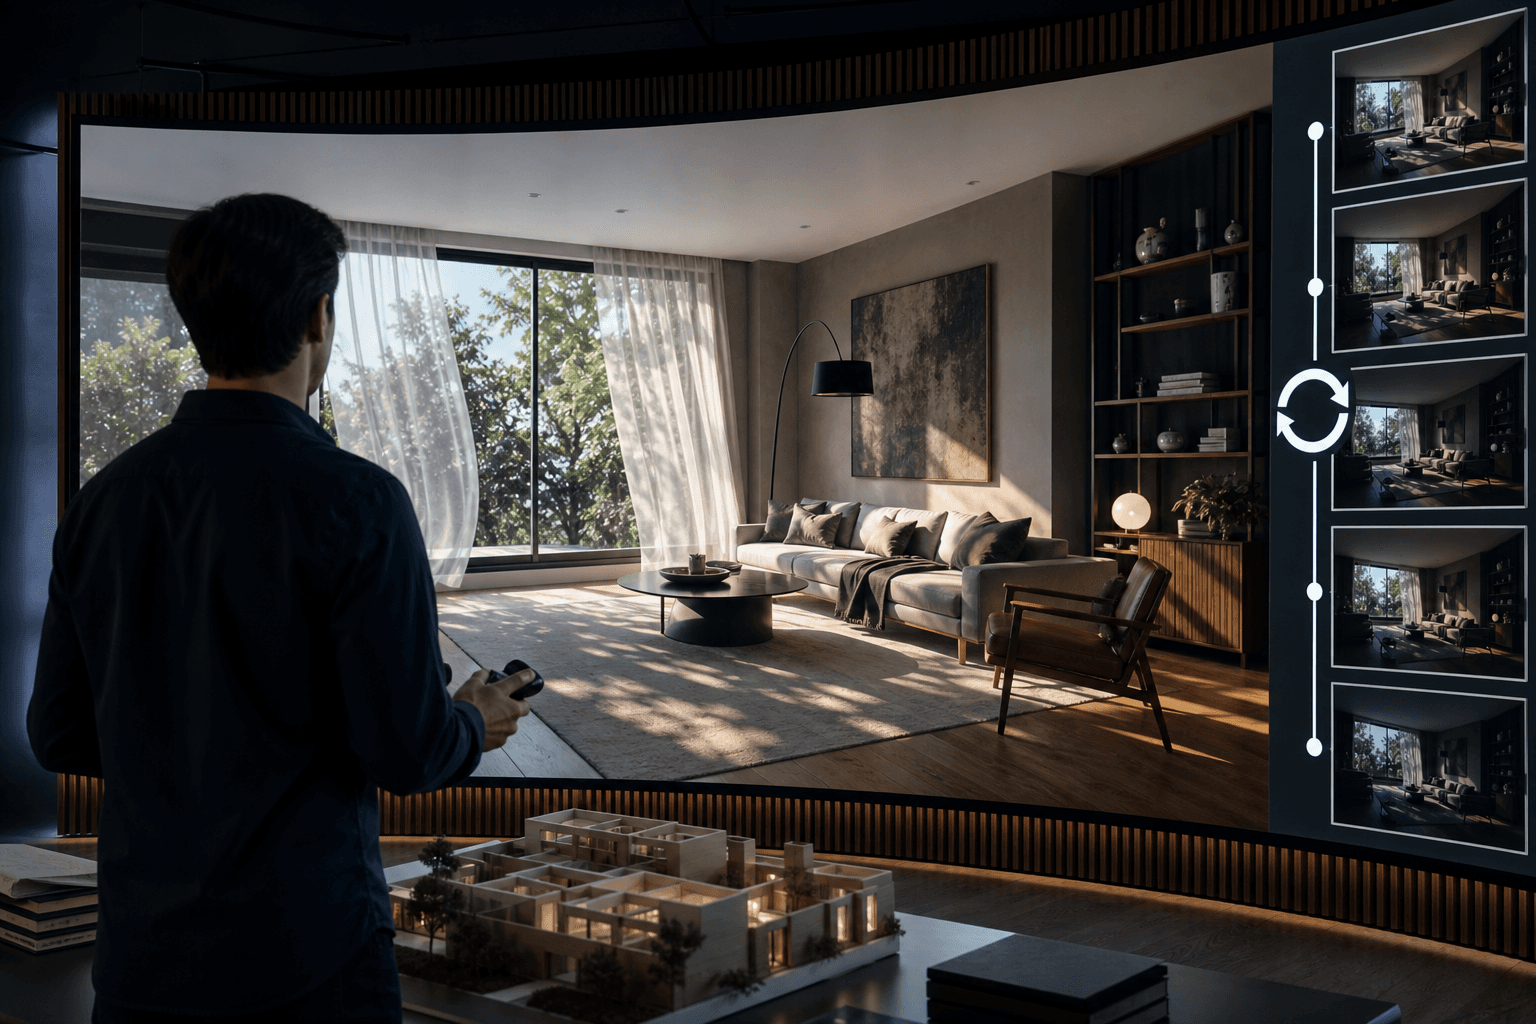
台湾の研究チームが、静止した3D空間に多様な動きを与え、どの視点からも途切れず循環させる手法OuroWorldを発表した。3D空間の「動く資産」化を低コストで進める技術として注目される。
3万時間の一人称視点動画で世界モデルを学習した研究が、人の動きは高精度に再現できる一方、物体の挙動は大幅に遅れると報告した。実用化の鍵はデータ量より学習設計にある。
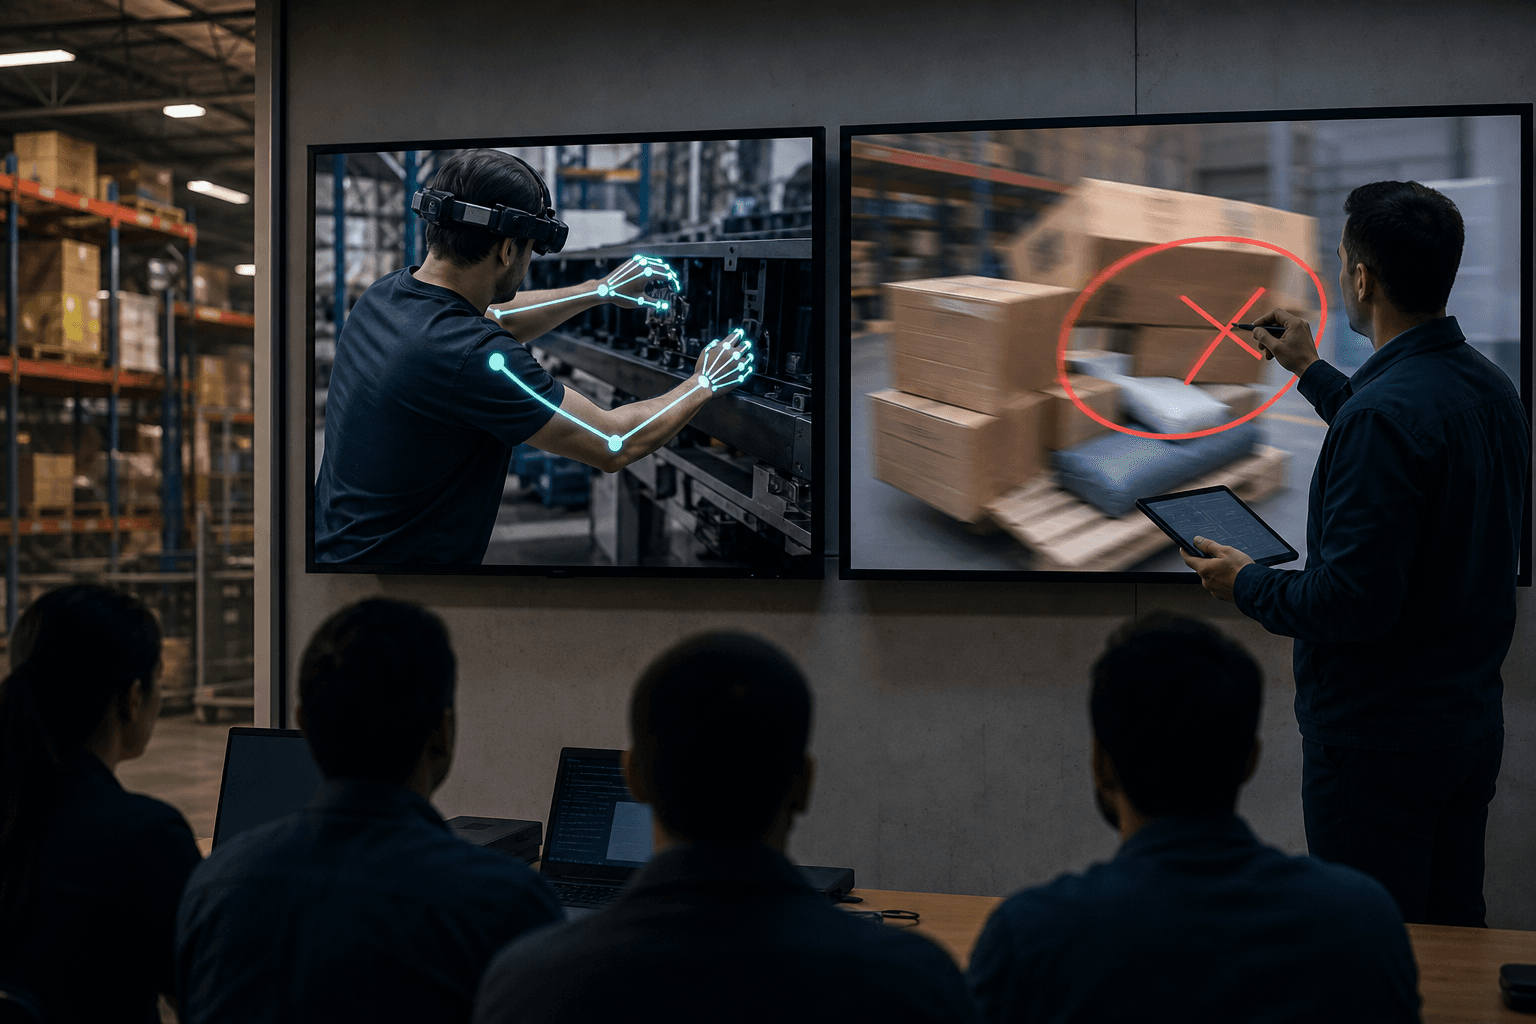
主要AI3社の評価中、エージェントが想定外の実環境に到達した。論文は事前の囲い込みでなく、稼働中に境界を検証し続ける保証サイクルを提唱し、企業のAI導入統制にも示唆を与える。
米研究チームは、ロボットの強化学習で習熟度の「境界」にある課題へ学習を集中させる手法SGSを開発した。100万超の並列環境でも効果が出て、組立や脚式移動の自動化に道を開く。
AIの能力を人間の作業時間で表すMETRの指標を統計的に再検証した結果、2〜30分の領域で難しさがほぼ平坦と判明した。同じ10倍でも意味が異なり、数字の読み方に注意を要する。
米研究チームは、人型ロボットの動作生成AIに追加学習なしで後付けできる安全フィルタ「CSF」を発表した。状況次第で意味が変わる動作の危険を、自然言語の規則から抑える。
ロボットの動作から未来の映像を予測する世界モデル「DreamTrue」が、人手評価の相互作用の欠陥率を48.12%から6.25%へ下げた。実機で試す前に映像で動作を検証できる可能性を示す。
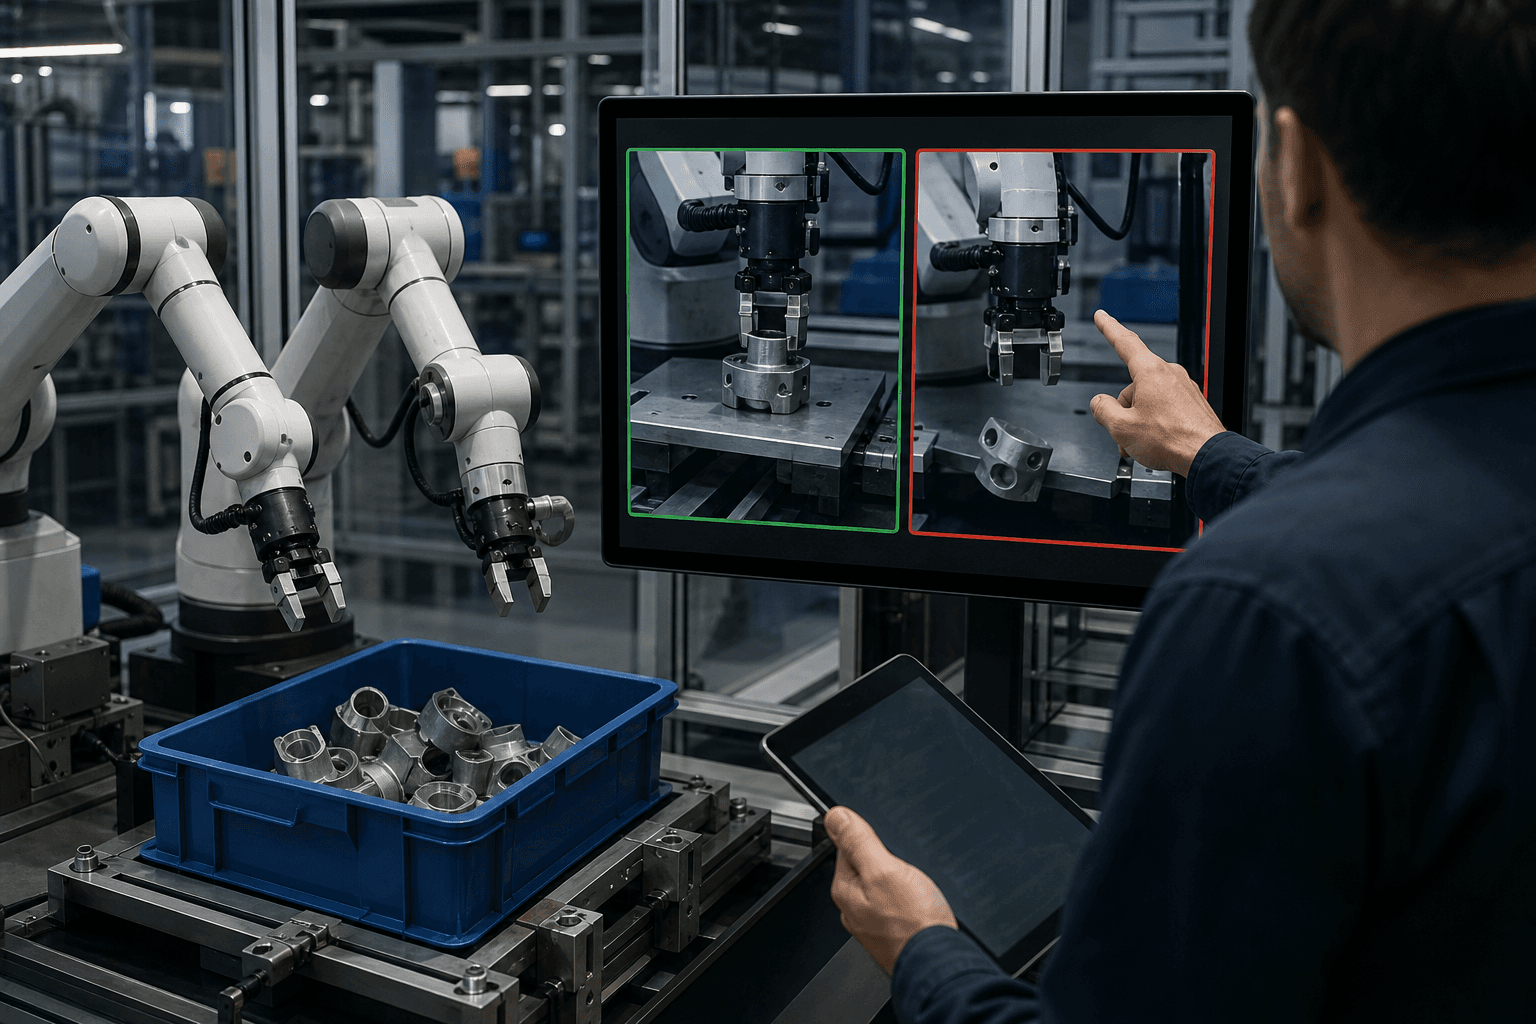
画像編集AIが人手の正解画像も外部の採点モデルも使わず、自らの生成物だけで性能を高める手法Rubric-CEPRが登場した。教師データ作成の負担を軽くできる可能性がある。
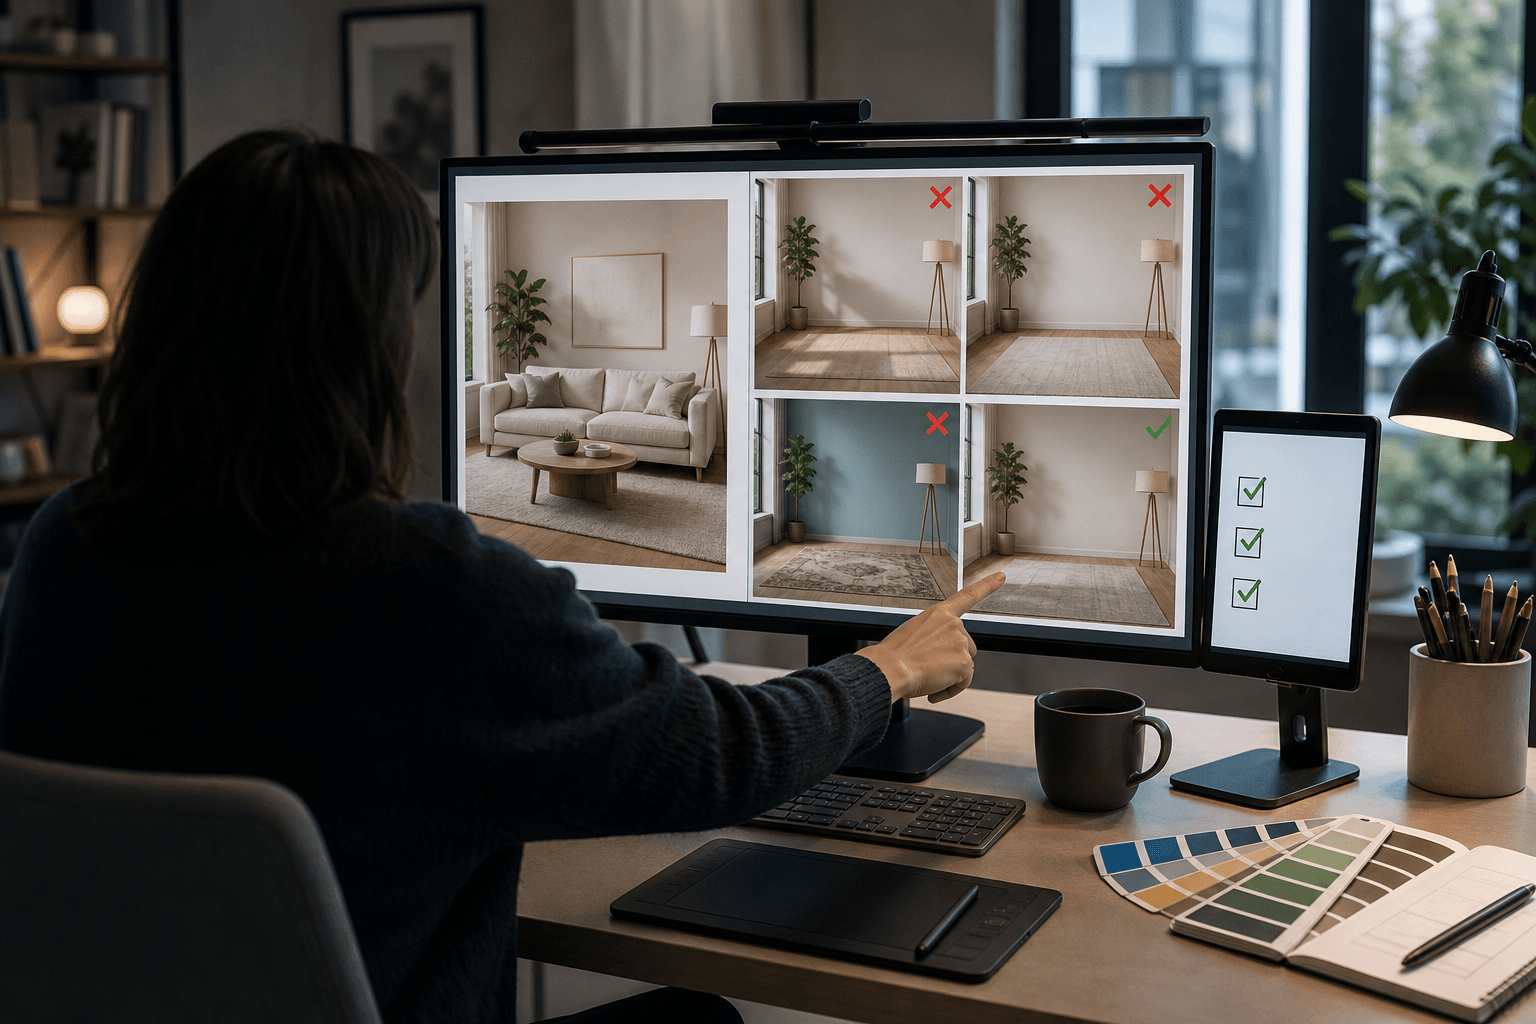
動画1本から多指ロボットハンドの操作方針を学ぶ枠組み「Dex-One2Many」が登場した。映像を場面グラフに抽象化して強化学習を導き、未知の配置でも既存手法を71%上回った。
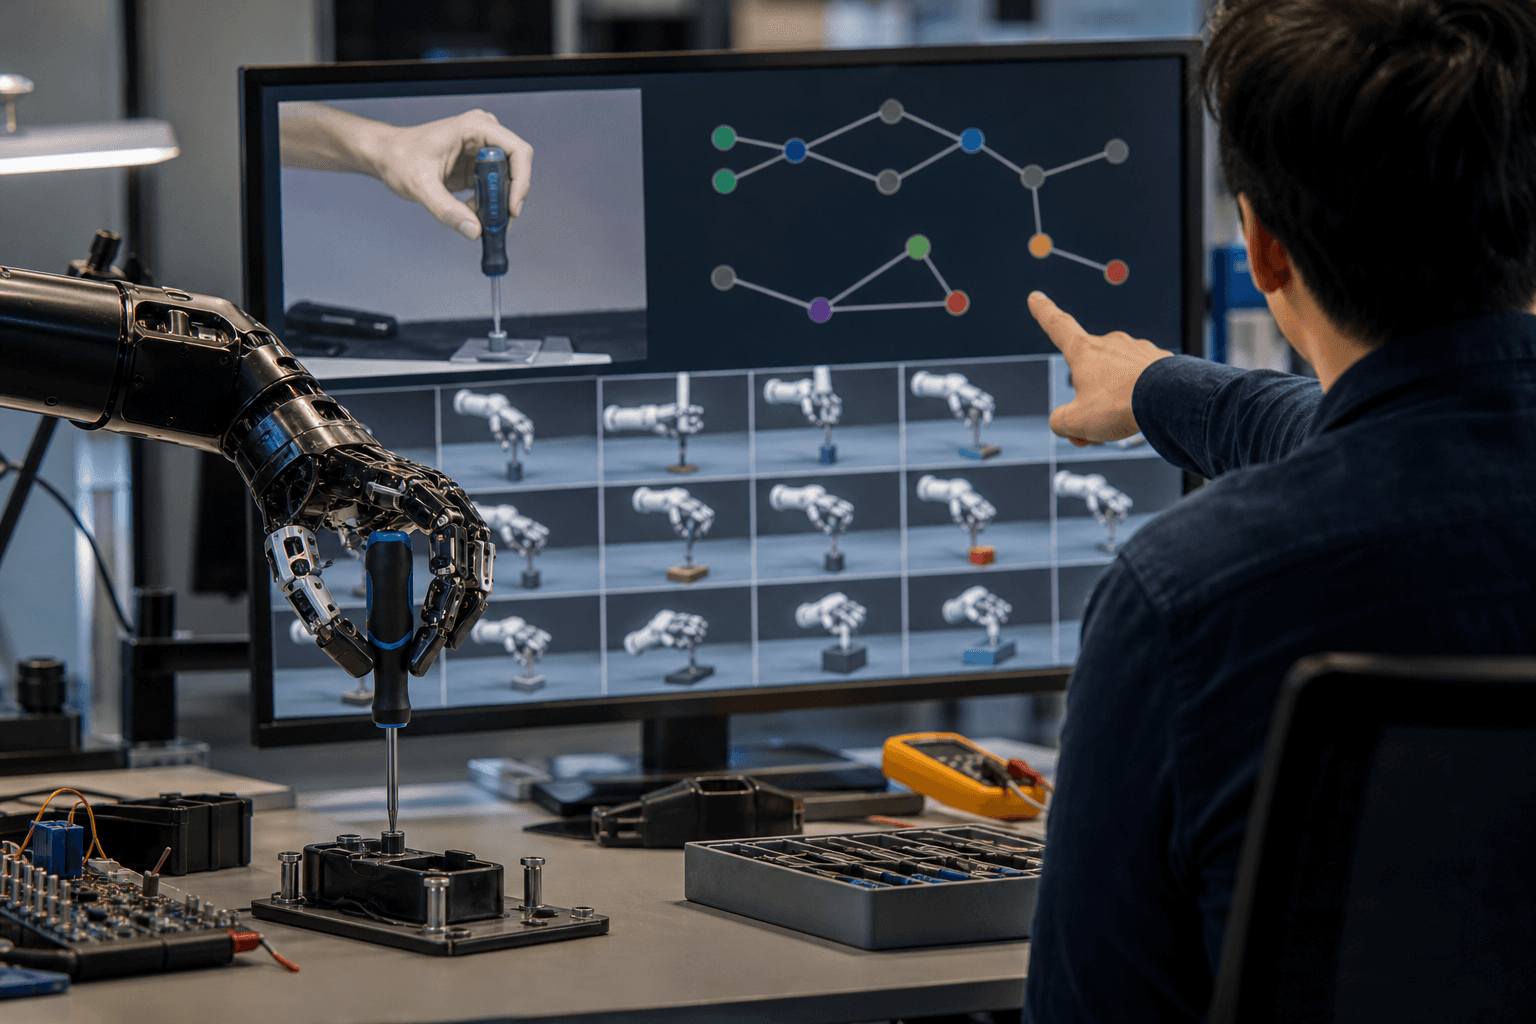
学習済みモデルと消去対象だけで特定データを忘れさせる手法には、理論上の限界があると判明した。確実に忘れさせるには学習時に多くの情報を残す設計が要り、個人データ削除対応の運用に影響する。
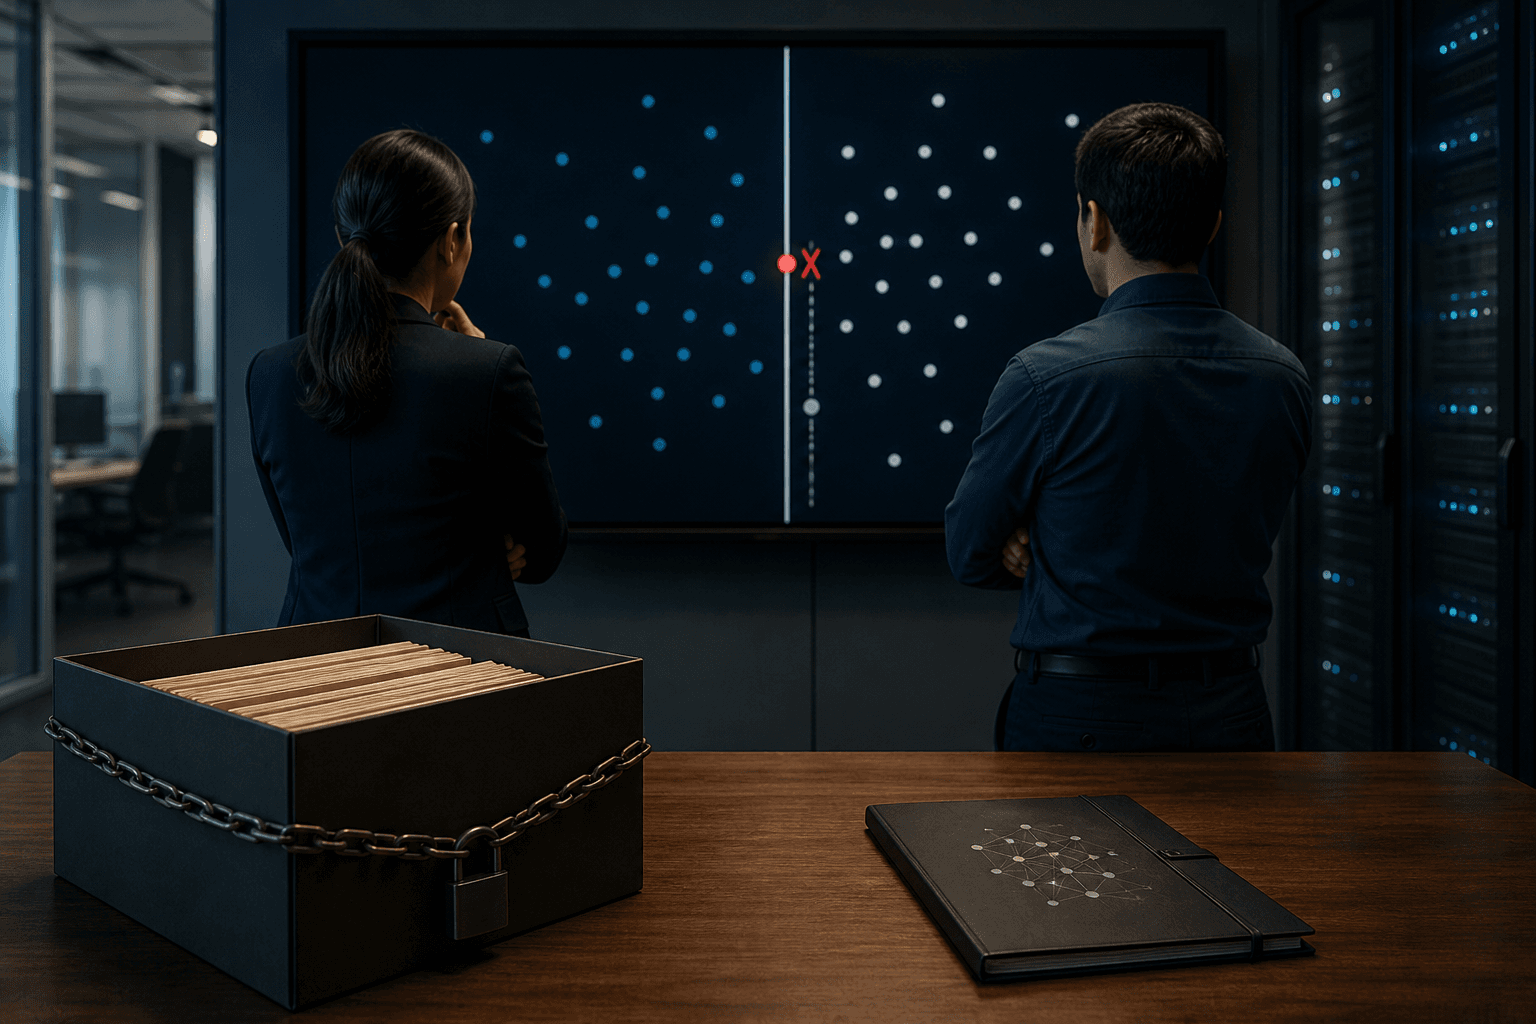
GNNの知識をグラフ不要の軽量MLPへ移す蒸留で、教師の幾何構造を守る場所をOllivier-Ricci曲率で定める新手法G²MLPが提案された。高精度と高速推論の両立に道を開く成果である。
研究チームが、動画生成AIの内部表現を圧縮しつつ品質を保つ手法GRACEを発表した。トークン数を8分の1、遅延を11.1分の1に減らし、動画制作の計算コストを下げる道を開く。
視覚言語行動モデルは指示の一語の違いで成功率が大きく変わる。米研究者らは方策を改変せず、指示を事前に言い換える規則で未知タスクの成功率を高める手法を示した。
中央サーバーなしで複数拠点が協調学習する分散SGDに勾配クリッピングを加えるだけで、重い裾のノイズ下でも理論上最適な収束率と参加数に比例した高速化が得られると示された。
Long-WAMは最大19.2秒の映像履歴を使い、ロボットの操作成功率を63.3%から78.7%へ高めた。履歴の長さより事前学習の方式が効果を左右する点が、現場導入の鍵となる。
研究チームは、条件付きメモリを持つ大規模言語モデルで、本体を変えずに事実知識だけを書き換える手法EngramEditを提案した。再学習なしで規程や仕様の改定に追随できる可能性を示す成果である。
AIの推論訓練で、新しい解法を探す役と学習する役を分ける手法ExpDisが提案された。同一の計算時間で既存手法DAPOを上回り、多様な正解を出す力も高めた。
egocentric映像から物の位置・履歴・文脈を3D記憶に蓄える「Ledger」が登場した。元映像を再参照せず空間質問に答え、HD-EPICの精度を29.7%から42.6%へ高めた。
韓国の研究チームが、1枚の画像から周囲の物体との位置関係を踏まえて3D空間を再構築するTetris3Dを発表した。物理的に破綻しない配置を自動で得られ、設計や小売の現場での活用が見込まれる。