ロボ、手本動画を階層で読み成功率向上
LLMが動かすロボットが、手本動画を階層に整理して必要な場面だけ参照する手法が登場した。1本の動画で追加学習なしに成功率を高め、現場導入の負担を下げる点で注目される。
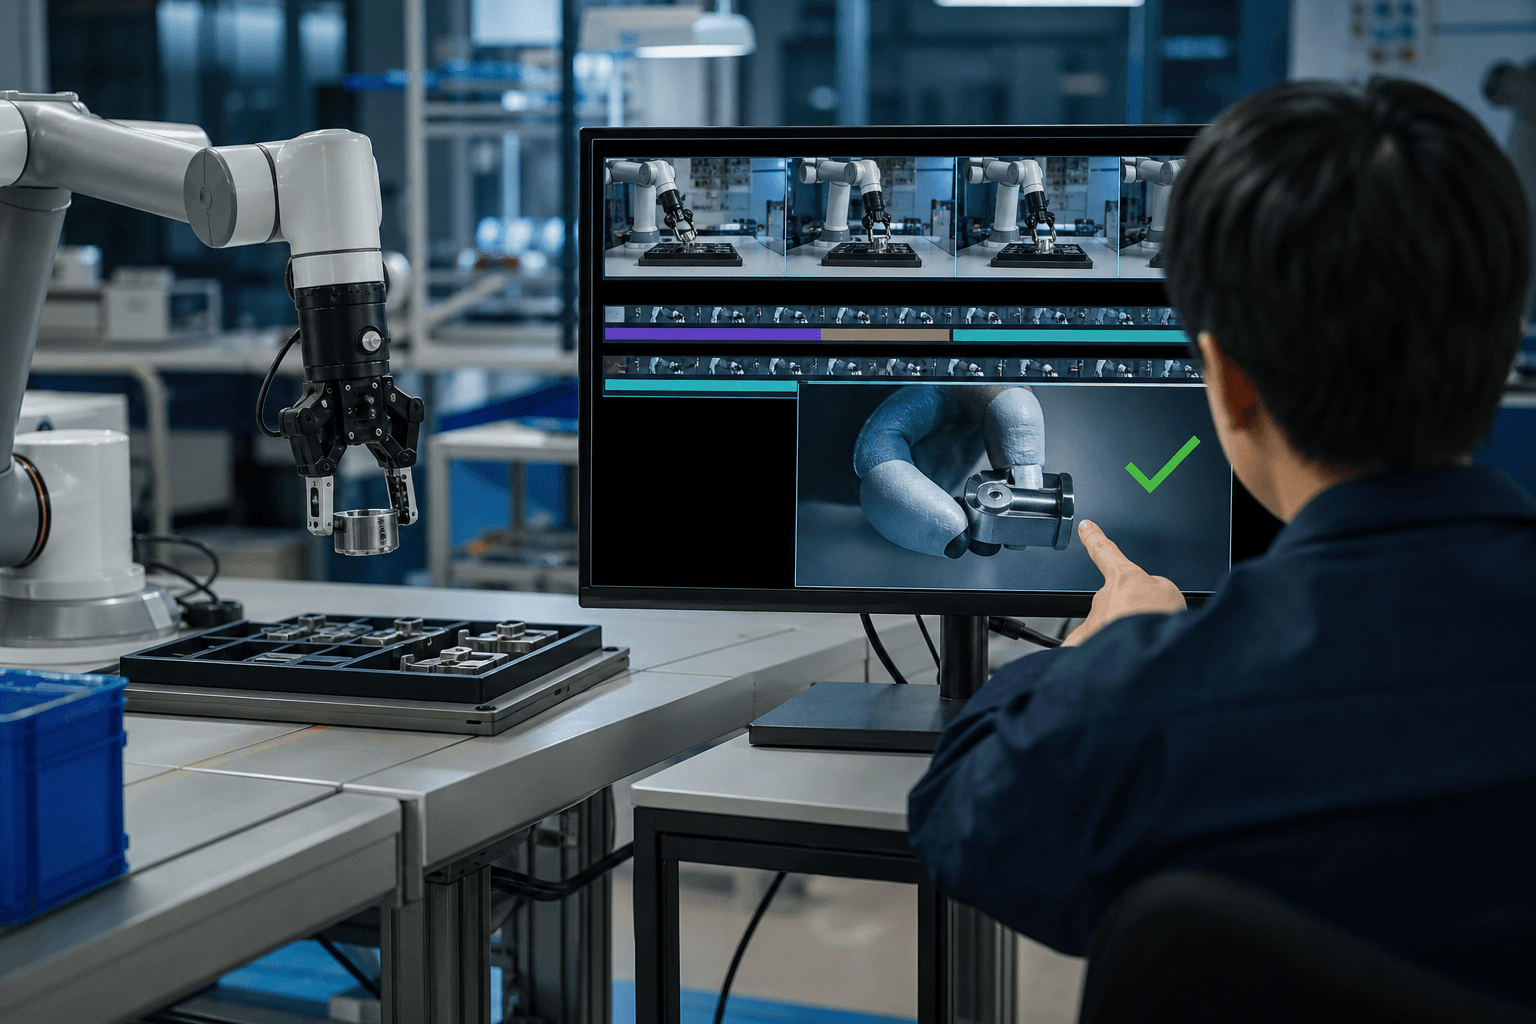
研究の概要
Wenrui Bao氏らの研究チームは、LLMエージェントが既存のロボット制御モデルを操る際に、手本動画を効率よく利用する手法「Recursive Video In-Context Learning (RV-ICL)」を発表した。特徴は追加学習を必要とせず、1つの作業につき手本動画が1本あれば実用的な改善が期待できる点である。研究はRPentを基盤とした評価を行い、ロボット操作ベンチマークLIBERO-PROで成功率が92.6%から96.5%へ、LIBERO-Plusでは86.7%から95.8%へ向上したことを報告している。
背景には、視覚と言語を同時に理解し行動を出力するVLA(視覚言語行動)モデルを固定して、LLMエージェントが計画と指示を担う「二層構成」が広がるという事情がある。こうした構成では、エージェントが試行を重ねて計画を改善しても、その記録はテキストとして残るのみであり、実際の「やり方」(接触の細部や連続する動作)は保存されにくい。動画はやり方を直接伝え得るが、そのまま文脈としてエージェントに渡すと処理負荷や文脈膨張の問題が生じる。RV-ICLはこの応用上のジレンマに対して、動画の扱い方を階層化することで対処している。
しくみをやさしく
RV-ICLの中核は、手本動画をただ「プロンプトとして添える」代わりに、エージェントが階層的に辿る参照構造に変換する点である。具体的には、動画を作業のサブイベント(つかむ、放す、位置合わせなど)に基づいて階層化し、上位から下位へと次第に粒度を細かくする。上から順に並べると、作業全体のキーフレーム、フェーズ、モーメント、短いクリップという四層に整理され、各層は読み取り専用のツールとしてエージェントに提供される。
運用面の振る舞いは二段構えである。まず計画段階では上位の粗い層(キーフレームやフェーズ)だけを読み、作業の全体構造と流れを把握する。次に実行段階では、特定のサブゴールに直面したときにのみ階層を降り、対応する短いクリップ(前後の接触を含むコマ)を読み込む。こうすることで、必要な情報だけを必要な時に取り出し、LLMの文脈容量を無駄に圧迫しない。静止画の切り出しが接触の微細さを失い、全動画を渡すと処理が遅くなるという従来の問題を両方とも回避する設計である。
評価では、RV-ICLを用いることで既存モデルの再学習を行わずに成功率が向上することが示された。これは、動画を階層的に参照するだけで、細かな把持や配置のやり方をエージェントが適切な場面で参照できるためであり、現場導入時の負担やコストを抑えられる可能性を示唆する。
ビジネスへの示唆
適用先は主に製造業の組立やピッキング工程である。具体的な定例業務としては、ライン切替え時の立ち上げ設定、現場での再教示、日常的な多品種ピッキングの取り回しが挙げられる。自部署に当てはめる問いとしては、次のように整理できる。
-
自部署で該当する業務は何か?
- 例: ライン切替え時のハンドリング設定、工程内で頻出する把持失敗が起きる作業、検品・仕分けでの個別取り扱いが多いピッキング作業。
-
いま誰がどれだけ手をかけているか?
- 例: 熟練者が毎回実演して再教示を行っているのか、立ち上げにかかる時間や人数、例外処理に動員される工数はどれほどか。
これらの問いを出発点にすれば、RV-ICLの効果を測るべきKPIは明確になる。想定される主なKPIは次の通りである。
- 生産技術部門: ライン切替え時間、立ち上げ工数、再教示の回数
- 品質管理部門: 把持ミスや落下による不良率、手直し率
- 物流倉庫: 多品種ピッキングの成功率、例外処理にかかる人手
これらのKPIに対して、「実演動画1本を与えたときにどの程度再教示が減るか」「例外処理がどれだけ頻度・時間で削減されるか」といった観点で評価計画を立てると、自分ごと化が進む。なお、研究結果はベンチマーク上の成功率改善に基づくものであり、実運用では照明や部品ばらつき、安全要件など環境差があるため、自社条件での検証が必須である。
現場での導入イメージ
仮に導入支援に入るなら、次の四段階のワークフローを推奨する。
- 棚卸し
- 何をするか: 現場の作業を洗い出し、ロボットが失敗しやすい局面、再教示に人が割かれている工程を特定する。接触や把持の問題が集中する場面をログや担当者ヒアリングで把握する。
- 目指す到達点: 効果が出やすい作業の優先順位が現場関係者間で合意され、PoC対象が明確になる状態である。
- 差し込み先の設計
- 何をするか: 既存のロボット制御モデルやLLMエージェントの構成を変更せず、動画の階層参照をどのように差し込むか設計する。既存の監視画面やオペレーションUIに新たなツールを増やさずに参照層を組み込む現実解を検討する。
- 目指す到達点: 既存設備を活かしつつ、手本動画の階層化だけを追加する実行設計(インターフェース仕様とデータ取り回し)が決定されること。
- 小さく試す(PoC)
- 何をするか: 1ラインまたは1作業に限定して、熟練者の実演動画を1本撮影し、RV-ICLによる参照を数週間運用する。成功率の変化に加え、現場担当者の再教示負担感や例外発生時の対応時間も評価する。
- 目指す到達点: 効果と限界が定量(成功率等)と定性(担当者の実感)の両面で説明可能になり、次の展開可否判断材料が揃う状態である。
- 運用と横展開
- 何をするか: 動画撮影の標準手順、更新頻度、失敗時の見直しプロセスを文書化して運用に組み込む。効果が確認された作業カテゴリへ同様の手順を横展開し、動画資産を蓄積する仕組みを定着させる。
- 目指す到達点: 新しい作業が発生した際に「実演を1本撮る」だけでロボットが現場で立ち上がる運用が定着している状態である。
全体の目標終着点は、熟練者の実演を現場の資産として蓄積し、ロボットの立ち上げや切替えに際して専門家の長時間介入を不要にする現場である。モデルの再学習が不要なため、費用は比較的小さく・短期間で始められる利点があるが、現場条件での検証と撮影の品質管理は欠かせない。
今後の展望
手本動画を細かな階層で参照する発想は、ロボット操作にとどまらず保守点検や技能伝承といった領域にも応用可能である。例えば保守点検では、部品の接触や回転操作の微妙なタイミングを動画で残し参照することで、作業のばらつきを抑えられる可能性がある。一方、実機での長期運用検証、動画撮影・注釈の標準化、誤動作時の責任分界といった実用化上の課題は残る。これらは現場と研究者の協働で段階的に解決する必要がある。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボット方策、物理時間を明示し遅延に強く
Chronos Policyは、観測の取得時刻と行動の実行時刻をロボット方策に明示的に与える手法である。センサーや推論の遅延が揺れる現場でも、動作の安定性を保てる可能性を示した。

スマホ撮影だけでロボを現場適応させる技術
スマートフォンによる室内スキャンだけで、汎用ロボット制御AIを個別の現場に適応させる手法が登場した。実機での把持成功率は63.9%に達し、現場ごとの実演収集コストを抑える道を開く。

物理を備えた3D資産をAIが自動生成
オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。
