AI×経営戦略
Agensh、1024体の自律協調で精度向上
中央の調整役を置かず、最大1,024のAIエージェントが自律的に分業する基盤「Agensh」が提案された。台数の増加が難課題の成功率を押し上げ、納期が固定された開発業務に新たな選択肢を示す。
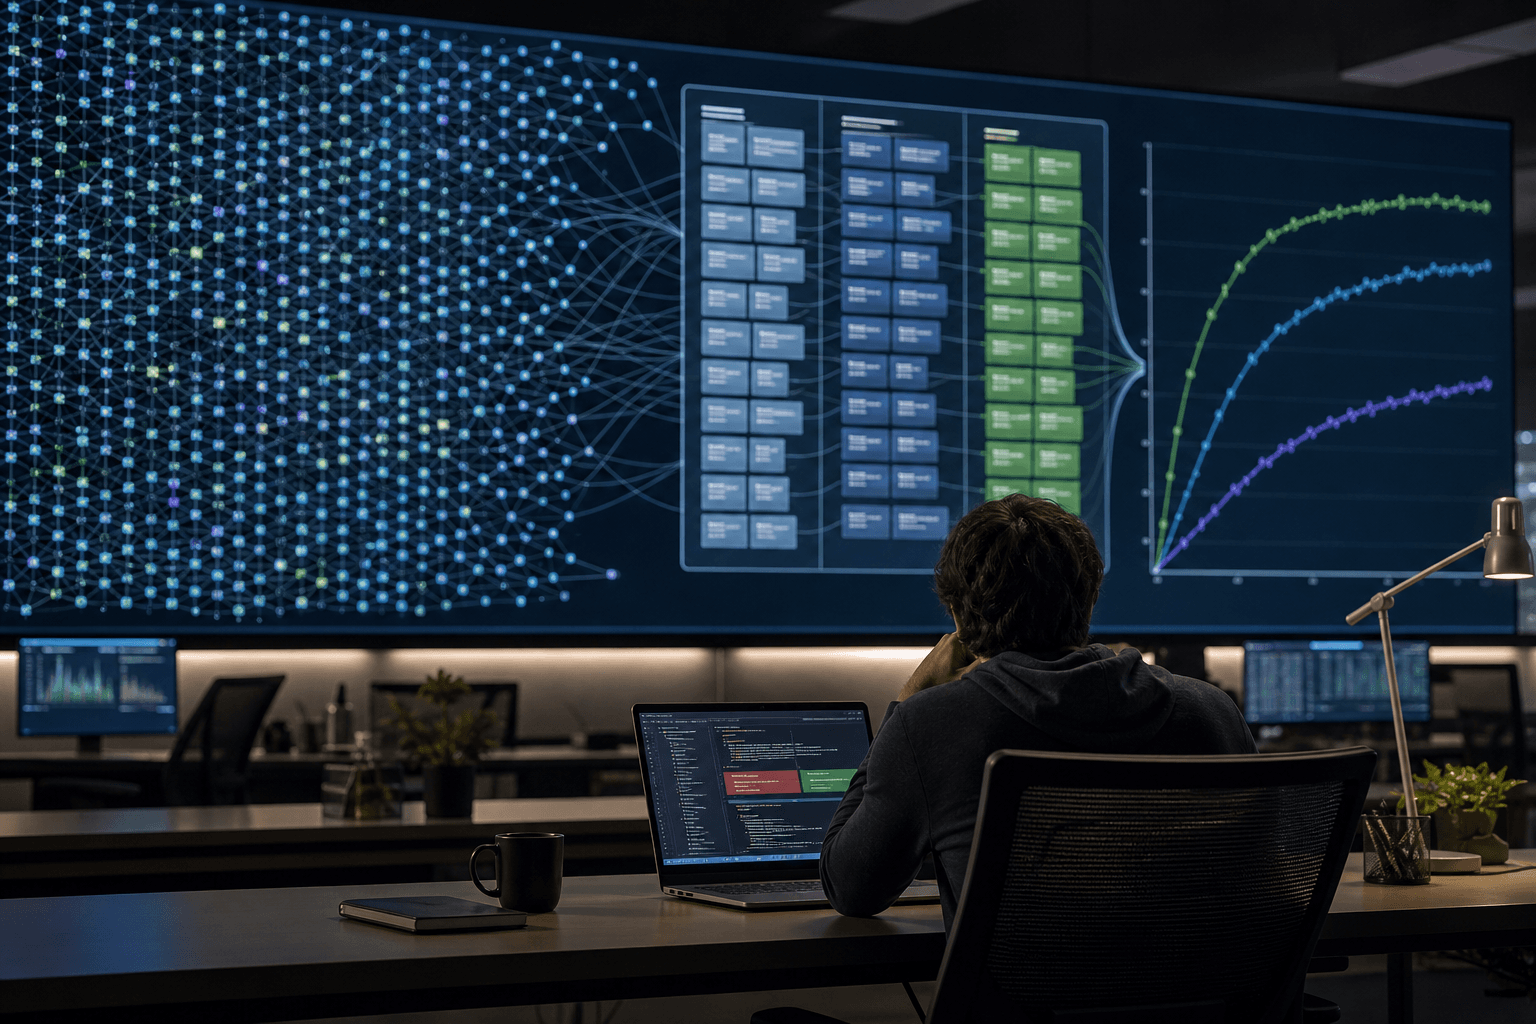
中央の調整役を置かず、最大1,024のAIエージェントが自律的に分業する基盤「Agensh」が提案された。台数の増加が難課題の成功率を押し上げ、納期が固定された開発業務に新たな選択肢を示す。
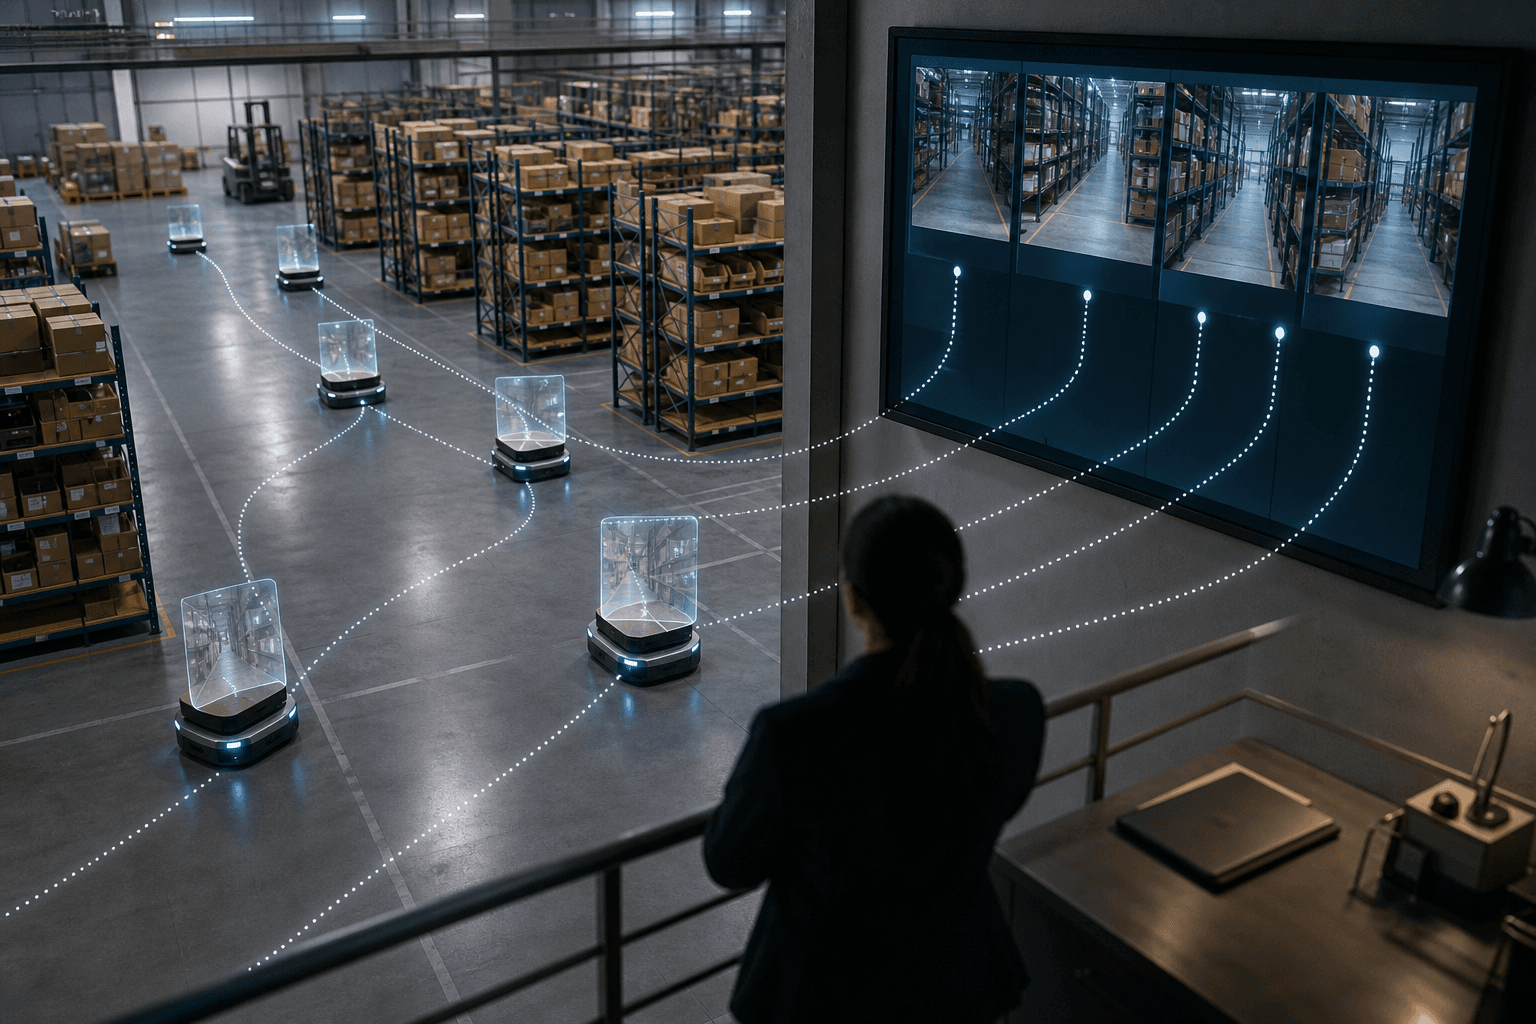
研究チームは、各担当者が部分的な情報と遅れて届く共有情報のみで判断する協調課題に対し、中央の調整役も集中学習も不要な学習・計画手法を提案した。工場や物流など分散運用の現場での自律協調に理論的な足掛かりを与える。
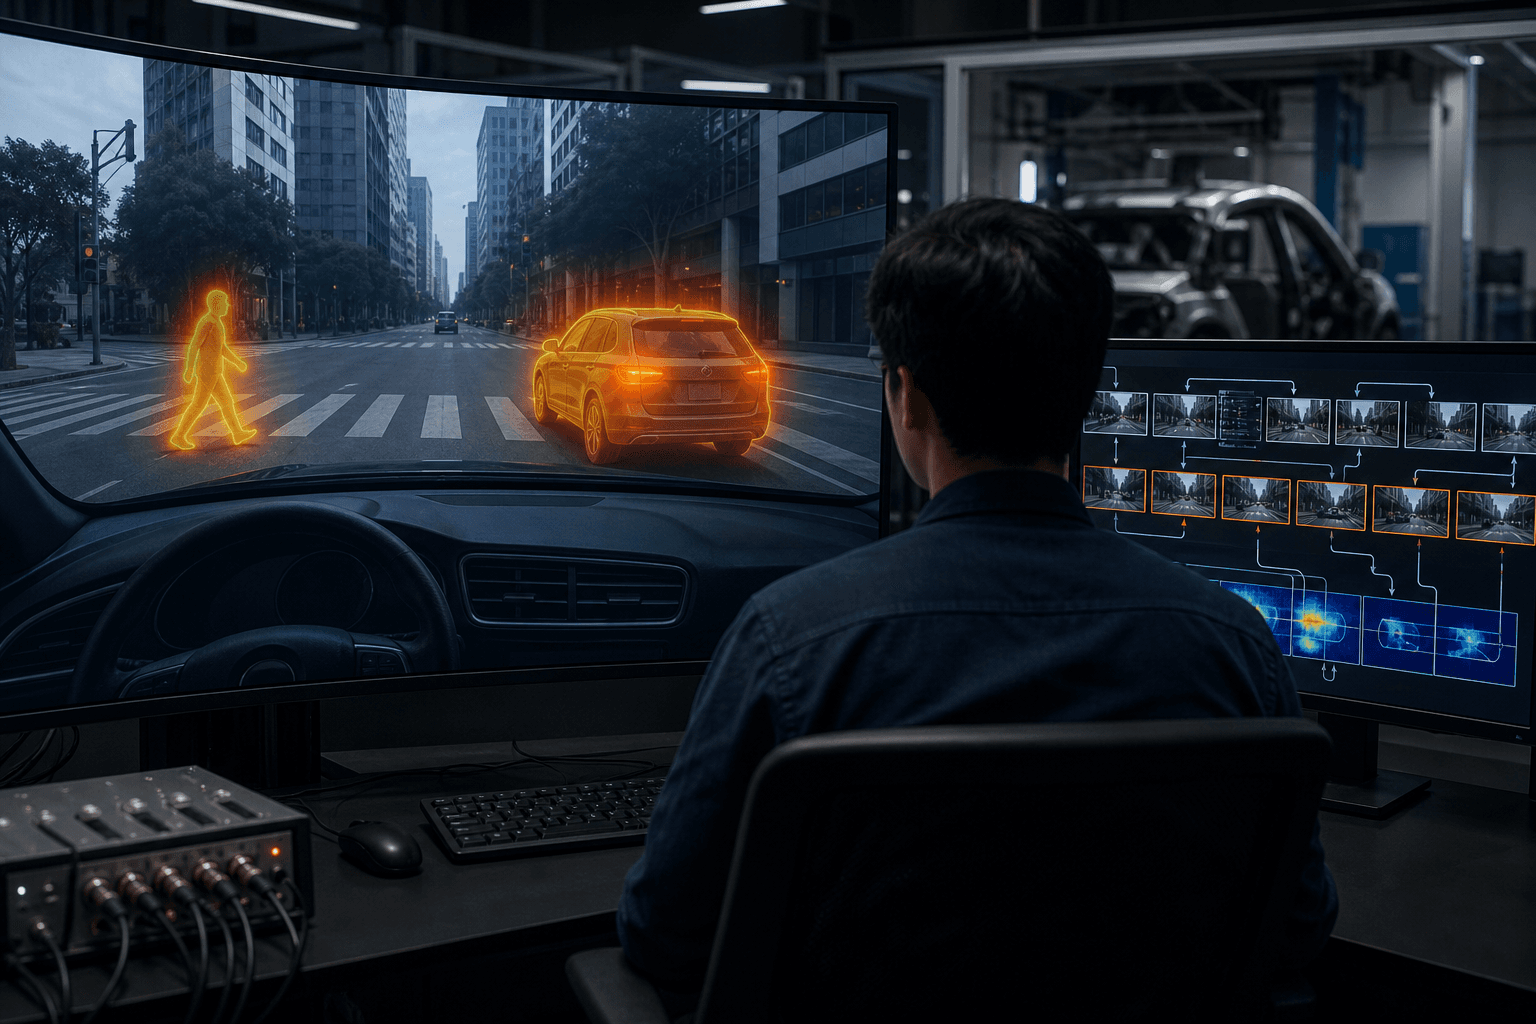
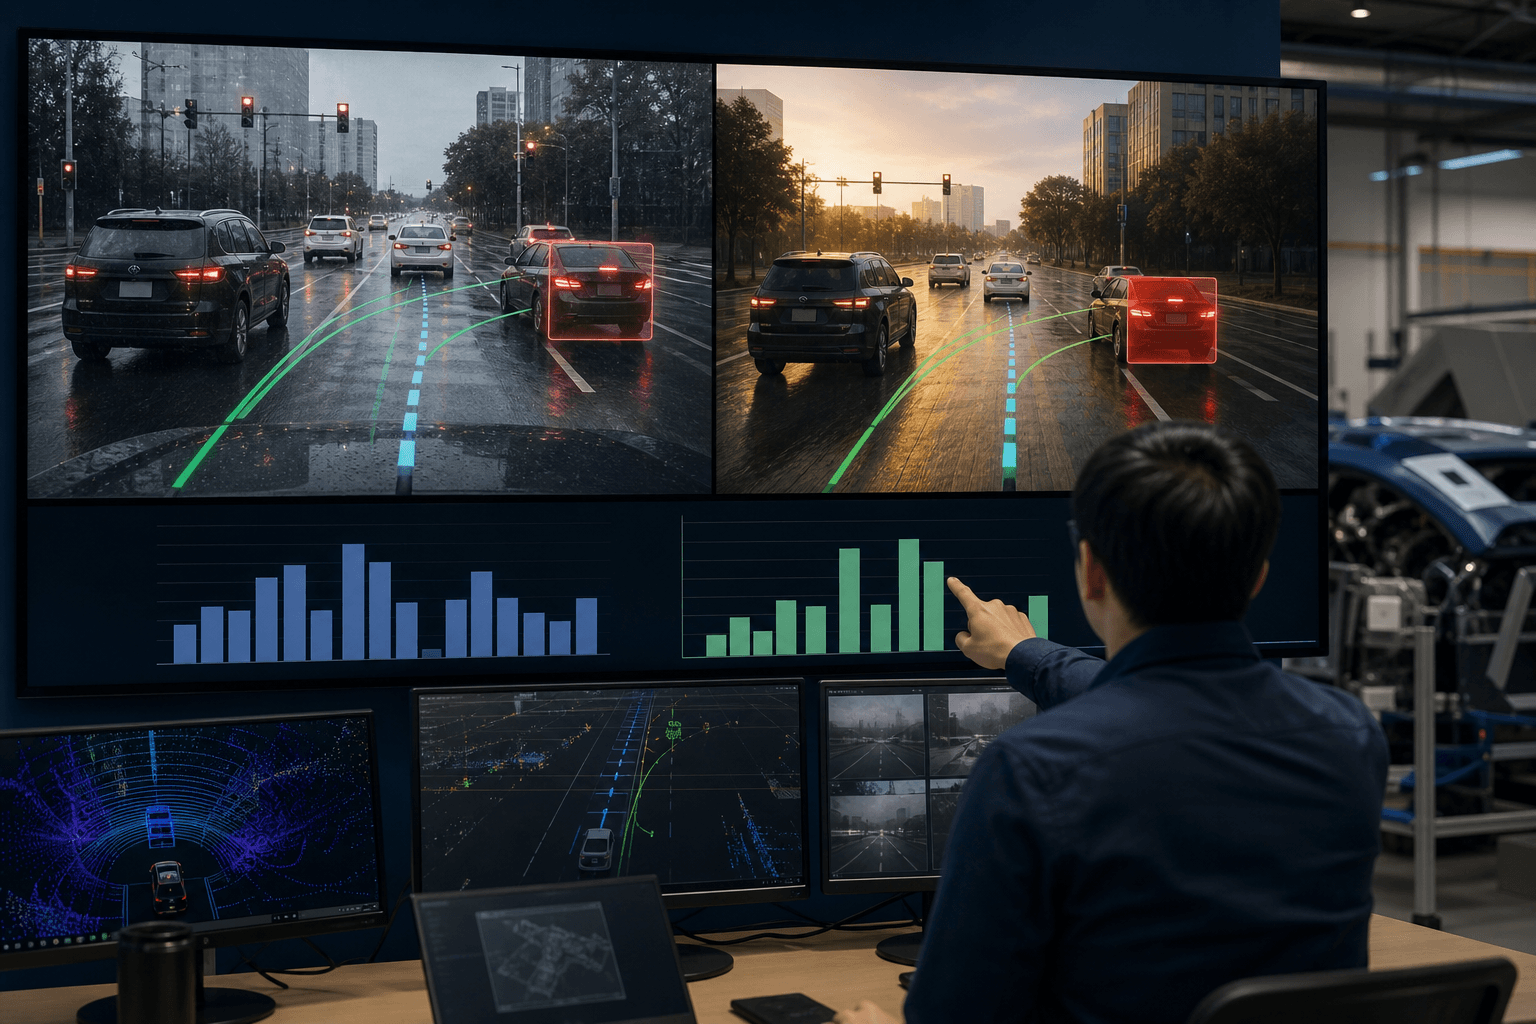
Bolei Zhou氏らは、自動運転AIの評価を実世界に近づける生成型シミュレーター「DreamStream」を開発した。新指標FDπで既存手法を最大4.7倍上回り、開発と安全検証の精度向上につながる。
Shufan Sun氏らの研究チームは、室内の1枚の画像から物体の位置関係まで整合した3Dシーンを復元する枠組み「HARMONY」を発表した。不動産や小売などで3D化の工程を簡素化する可能性がある。
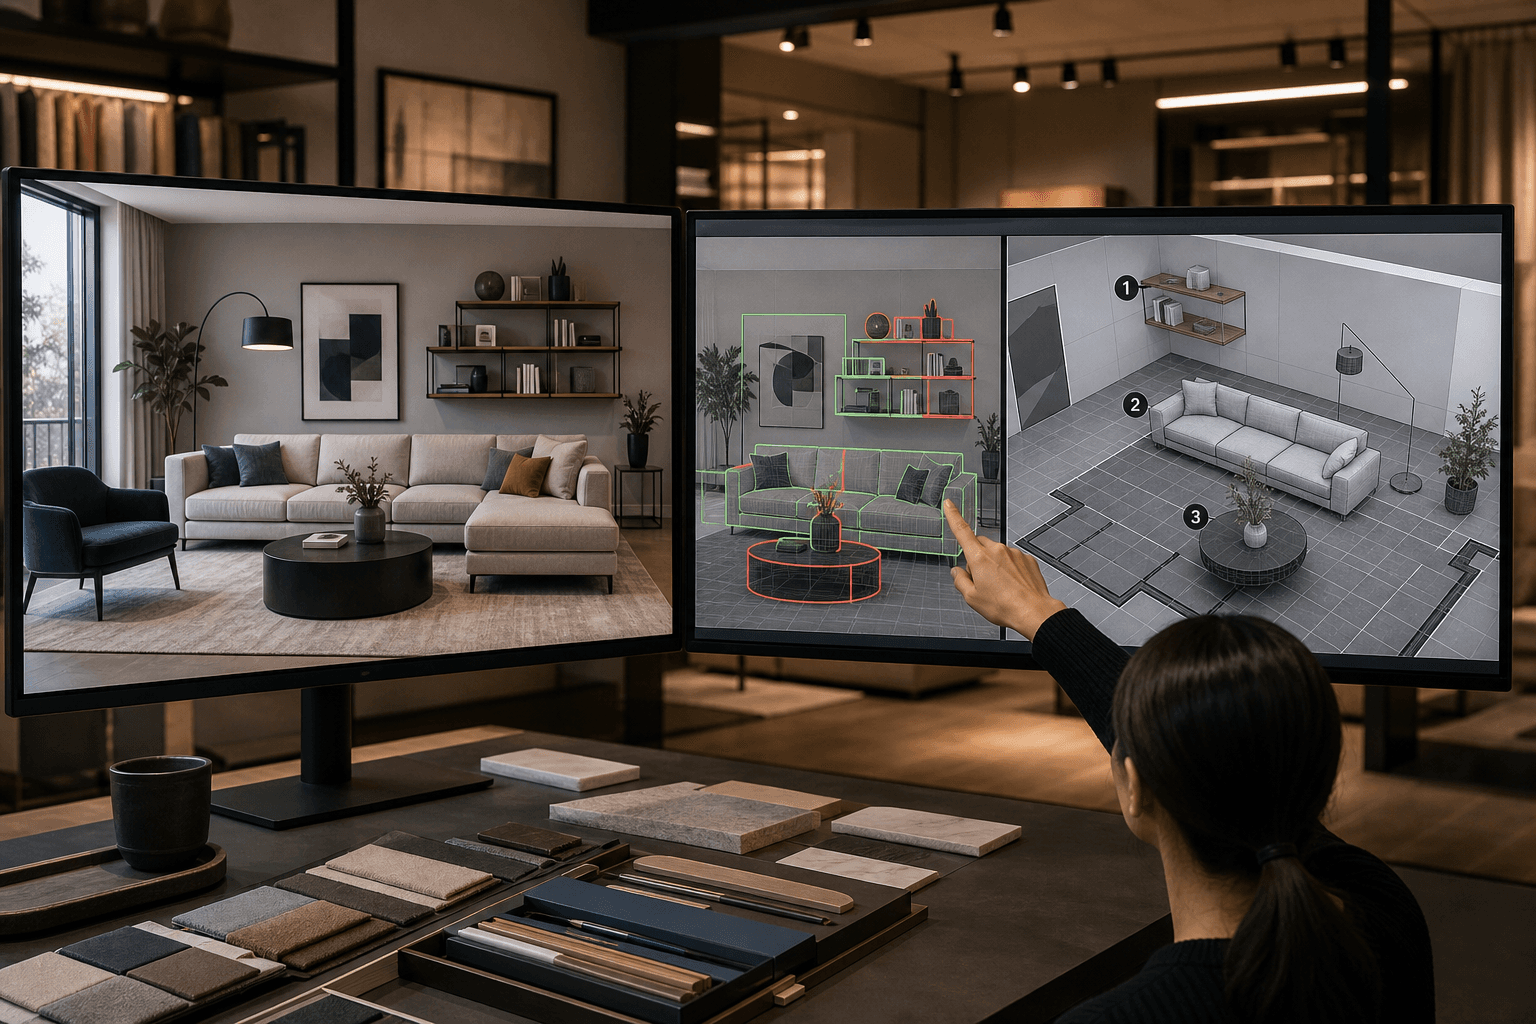
3D Gaussian Splattingで再現した実写空間から、選んだ物体だけを動かせるシミュレータ資産へ変換する手法φ-RIEが発表された。ロボット学習用の環境構築の工数削減につながる可能性がある。
拡散型大規模言語モデル(dLLM)の推論を、追加学習なしで従来最強手法比5.1〜11.0倍に高速化する枠組み「Flash-dLLM」が発表された。実用化の障壁だった推論コストの低減につながる可能性がある。
カリフォルニア大学バークレー校などの研究チームが、触覚を統合した世界モデル「DexTacWAM」を開発。22自由度双腕ロボットの6作業で平均スコア70.6と最有力手法の38.0を大きく上回り、製造・物流分野の精密自動化に応用が期待される。
米グーグル研究チームが、スマートフォン上で個人ごとの大規模言語モデルを高速生成する新手法を発表した。計算負荷を抑えつつ精度を高め、モバイルAI活用に新たな道を開く。
香港科技大学やテンセント等の研究チームが、生成AIの潜在空間に幾何情報を組み込む新手法「GAE」を発表した。映像の視覚品質と3次元的な一貫性を同時に高め、映像制作やシミュレーション分野への応用が見込まれる。
中国の研究チームが、LLM応答をトークン単位で修正しながら効率的にアノテーションできるツール「onPanda」を発表。手作業の後編集に比べ作業時間の中央値を52%削減し、AI開発現場のコスト構造に影響を与える可能性がある。
Tencent等の研究チームが、視点を跨いでも矛盾のない映像を生成する動画ワールドモデル「WorldCrafter」を発表。分単位の探索でも破綻しない映像生成は、不動産内覧やゲーム開発の実務利用に道を開く。
サレスフォースなど研究チームが、複数手順にまたがるAIエージェントの対話のうち、どの発話を訓練すべきかを診断する新手法「Critical-State RL」を発表した。誤った地点で訓練すると成果が横ばいか悪化する一方、正しい地点を選べば最大約14ポイントの精度向上を確認した。
カーネギーメロン大学などの研究チームが、AIエージェントを活用した監査手法「HAAC」を開発した。71人の監査担当者による実験で攻撃成功率と探索範囲が向上した一方、AI生成の評価・報告書への依存増大という新たな課題も判明した。
研究チームが外部ツールを自律的に使い分けて動画を生成するAIエージェント「VideoGen-Agent」を開発した。専門知識や人物同一性、物理的整合性が必要な動画生成の精度が既存モデル比19.1ポイント向上し、広告・映像制作業界のコスト構造に影響を与える可能性がある。
テンセント系列を含む研究チームがAAAゲーム21種・5000時間分の映像と指示文からなるAI評価基盤「GameHorizon」を公開した。47モデルを100万回超比較し、長期計画能力の格差を可視化。エージェントAI選定の客観指標として注目される。
ヨーク大学などの研究チームが110人規模の実験で、ビデオパススルー方式のヘッドセット使用時に頭部回転速度が4分の1に低下し、眼精疲労や認知負荷が増すことを確認した。XR機器の快適性設計に一石を投じる。
Simon L Liu氏らは、脳波センサーと視覚AIを組み合わせ、軽度認知障害(MCI)の人へ音声で先回りして支援する「PV-Care」を提案した。高齢化が進む介護・見守り市場で、受動型から能動型への転換を促す成果である。
クルアーンのアラビア語に関する言語知識を測る評価基準「QuranicMMLU」が公開された。12システムの選択式正答率は平均84%だが、自由記述の品質は平均60%にとどまり、選択式評価が実力を過大に見せることが示された。
研究チームが、対話型AIの実験を共有可能な研究資産として構成・実行できるオープンサイエンス基盤「Gricea」を発表した。CUI 2026論文の93%で設定を再現し、96%で再現に必要な情報の欠落を確認した。
自動運転向けの視覚・言語・行動(VLA)モデルに、過去の推論や目標を記憶して知覚へ反映する仕組み「PRIME」が提案された。追加は0.41%のパラメータで、閉列評価の運転スコアは従来比4.73ポイント向上した。