QuranicMMLU、選択式が生成AIの弱点を隠すと指摘
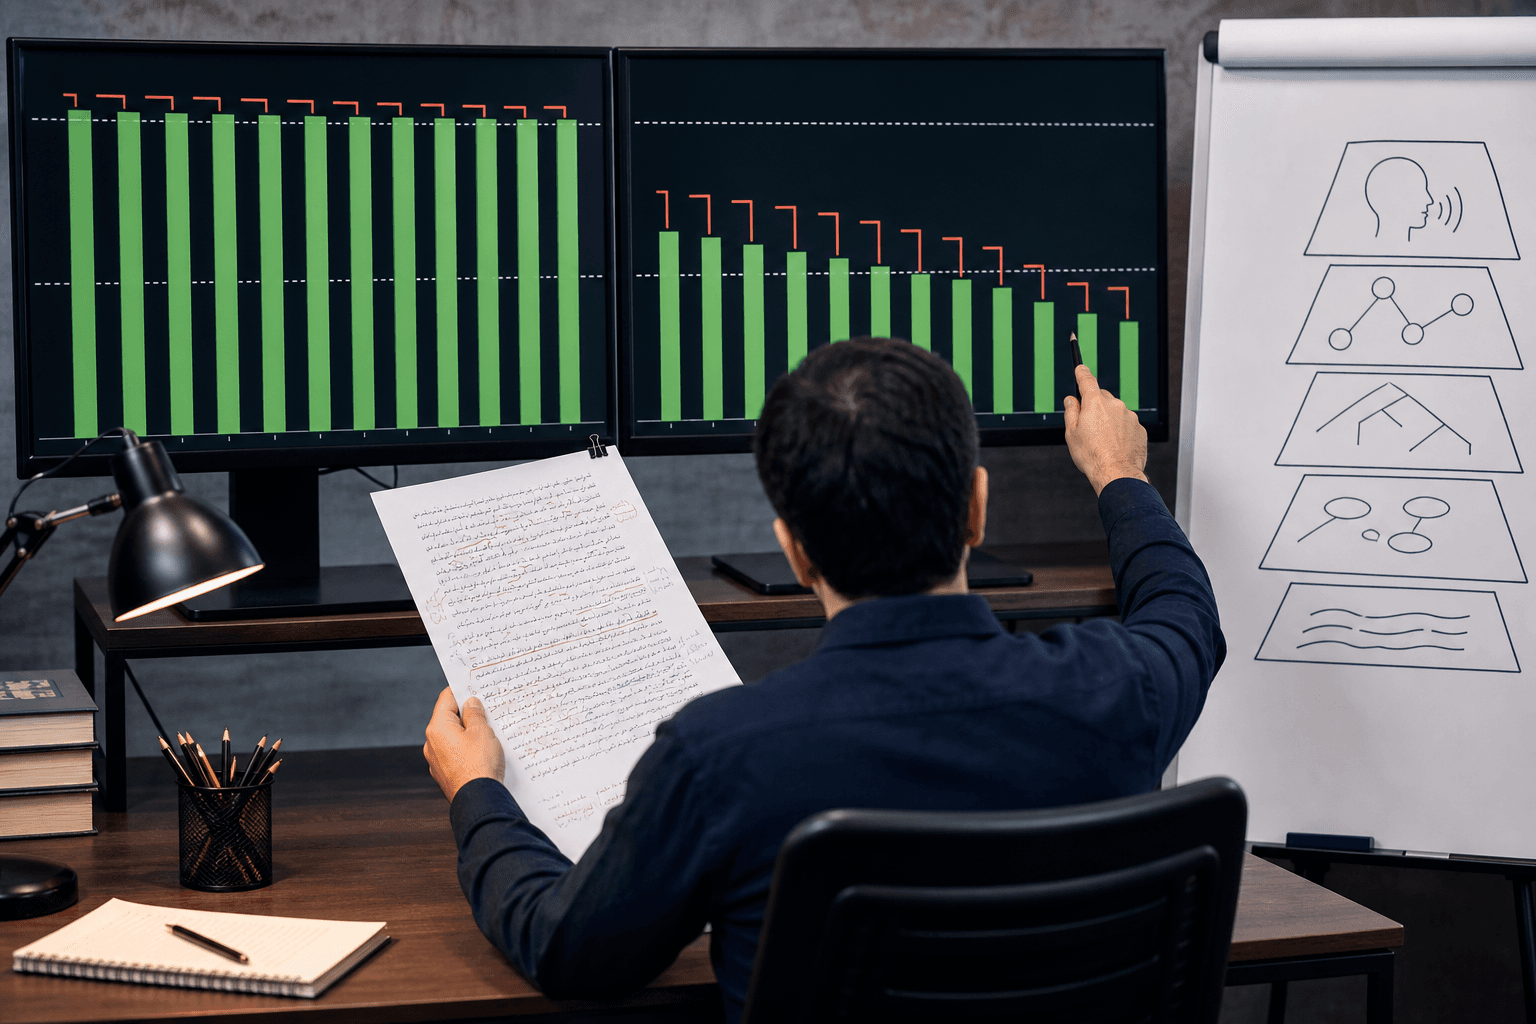
クルアーンのアラビア語に関する言語知識を測る評価基準「QuranicMMLU」が公開された。12システムの選択式正答率は平均84%だが、自由記述の品質は平均60%にとどまり、選択式評価が実力を過大に見せることが示された。
研究の概要
Ehsaneddin Asgari氏らの研究チームは、クルアーン(コーラン)のアラビア語に対する生成AIの理解度を測るベンチマーク「QuranicMMLU」を構築した。この研究は、既存のクルアーン関連の評価が一般的な質問応答や意味検索に偏っており、特定の言語能力を測定することや、認知的な難度・詩節の難度で層別化することができていなかったことを背景にしている。
この評価基準は、音韻、形態、統語、意味、語用の5本柱から成り立っており、朗誦規則のタジュウィードや語根・語型の形態論、啓示の背景、章間の一貫性まで31の下位項目を含む。各項目では、ブルームの認知レベルと詩節のパープレキシティ(言語モデルにとっての予測しにくさ)に応じて問題を生成し、LLMを審査役として独立に回答・採点させた後、注釈を人手レビューに回すという手法が採用された。最終的に980問を、自由記述と多肢選択の両形式で整備している。
12システムを評価した結果、イスラム分野に特化したモデルが首位となったが、全システムが多肢選択の正答率(平均84%)よりも自由記述の回答品質(平均60%)で低い成績を示した。両形式の順位の一致度はケンドールのτで0.73と高いものの、選択肢を取り除いて初めて表面化する失敗が、多肢選択では見えなくなることが指摘されている。
しくみをやさしく
「QuranicMMLU」は、生成AIの能力を測るために設計された評価基準である。具体的には、クルアーンのアラビア語に関する知識を、自由記述と多肢選択の形式で評価する。多肢選択では、選択肢が与えられた中から正解を選ぶ形式で、生成AIの理解度を測定するが、自由記述ではAIが自らの言葉で回答する必要があるため、より高度な理解が求められる。
この評価基準により、生成AIがどの程度の知識を持っているのか、またその知識が実際の運用にどのように影響するのかが明らかになる。特に、自由記述のスコアが低いことは、実際の業務においてAIの信頼性に疑問を投げかけるものである。
ビジネスへの示唆
「QuranicMMLU」の評価設計から得られる教訓は、特に宗教・言語教育の分野において重要である。例えば、アラビア語やイスラム教育のアプリを手がける教育サービス企業では、学習者への解説の正確性が信頼に直結する。これにより、顧客対応や教材作成において自由記述の品質が求められるため、選択式のスコアだけで生成AIの導入可否を判断することは危険である。
影響を受ける可能性のある部署とその指標は以下の通りである。
- 品質保証部門:自由記述回答の品質スコア、選択式との乖離幅
- カスタマーサポート部門:誤回答に起因する問い合わせ・苦情件数、人手エスカレーション率
- 教育・コンテンツ部門:解説の正確性、学習継続率
- 調達・IT部門:モデル選定に要するPoC期間と再選定コスト
このように、選択式評価が生成AIの実力を過大評価する可能性があるため、各部署は自部署で該当する業務にどのように影響するかを考慮し、いま誰がどれだけ手をかけているかを見極める必要がある。特に、専門特化モデルが首位となった点は、汎用モデルを一律に採用するのではなく、領域ごとに候補を比較する調達方針の妥当性を裏づけるものである。
現場での導入イメージ
仮に導入支援に入るなら、以下の4つのステップを踏むことが考えられる。
-
棚卸し:現状の業務プロセスや使用しているツールを洗い出し、どの業務が生成AIの導入に適しているかを特定する。目指す到達点は、業務の全体像を把握し、AI導入の可能性を見極めることである。
-
差し込み先の設計:既存ツールや業務のどこに生成AIを組み込むかを設計する。新ツールを増やさない現実解を考慮し、業務フローの中での最適な位置を決定する。目指す到達点は、業務の効率化を図るための具体的な導入ポイントを明確にすることである。
-
小さく試す(PoC):選定した業務に対して、小規模なパイロットプロジェクトを実施し、生成AIの効果を検証する。目指す到達点は、実際の運用における生成AIの有効性を確認し、必要な調整を行うことである。
-
運用と横展開:PoCの結果を基に、生成AIを本格的に運用し、他の業務にも横展開を図る。目指す到達点は、全社的に生成AIを活用し、業務の効率化と品質向上を実現することである。
全体の目指す到達点は、生成AIを効果的に業務に組み込み、業務プロセスの改善と顧客満足度の向上を図ることである。
今後の展望
本研究の手法は、分類体系を定め、認知レベルと難度で問題を層別化し、LLM審査と人手レビューを組み合わせるものである。このアプローチは、法務、医療、製造などの他の分野でも応用可能であり、自社の専門知識で評価基準を作る際の設計図として転用できる可能性がある。
実務では、選択式と自由記述の両スコアを併記し、乖離が大きいモデルを本番投入前に再検証する運用が現実的である。順位の一致度が高い点は、簡便な選択式を一次選抜に、自由記述を最終判定に用いる二段階評価が成立し得ることを示唆する。ただし980問という規模は限定的であり、LLMによる審査には偏りが入る余地も残る。人手レビューに要する工程コストと評価精度の兼ね合いが、企業が同様の枠組みを導入する際の焦点となるであろう。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AI家庭教師が人間と同等の学習効果を示す
米研究チームは、GRE対策でAIと人間の専門家による指導の学習効果が統計的に同等であるとの大規模実験結果を公表した。あるAIでは学習効果1ポイント当たりの費用が918分の1となり、教育・研修事業の採算構造に影響し得る。
LLMがLinux試験を自動採点、教育DXに新基軸
スペインの研究チームが大規模言語モデルによるLinux/bash試験の自動採点システムを評価し、専門家との一致率ICC=0.888を達成した。IT人材育成コストの削減と採点品質の標準化に向け、教育機関・企業研修部門への応用が期待される。
触覚グラフ自動生成、教育DXを変革
視覚障害学生向けの3Dプリント触覚統計グラフを250ミリ秒以内に自動生成するソフトウェア基盤が開発された。教育機関のインクルーシブ対応コストと制作工数を大幅に削減し、企業の障害者雇用・人材育成にも波及する可能性がある。