AI×製造
物理を備えた3D資産をAIが自動生成
オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。

全セクション横断 30 件
オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。
スタンフォード大などがレゴ設計をAIに課す評価基準BrickBenchを公開した。最新エージェントは物理的な組み立て可能性を概ね満たすが、人間の設計には及ばず、製造設計での実用性を測る物差しとなる。
音声と映像を同時に理解するAIの能力を、原子的な評価単位で精密に診断する新ベンチマークが公表された。人物の取り違えや音と映像のずれなど、実務で致命傷となる誤りの特定に道を開く。
egocentric映像から物の位置・履歴・文脈を3D記憶に蓄える「Ledger」が登場した。元映像を再参照せず空間質問に答え、HD-EPICの精度を29.7%から42.6%へ高めた。
動画に後から加えた物体が、持ち上げられるなど元映像の動作と噛み合うよう編集するAI「ALIVE」が登場した。撮り直しに頼ってきた広告・研修動画の制作工程を変える可能性がある。
動画生成AIの物理的な正しさを、光学や流体など40課題で定量測定するベンチマークが提案された。最高モデルでも100点中57.76点にとどまり、実務利用前の検証の必要性が浮かんだ。
動画から物理現象を再現するグラフィックスコードをAIに書かせる新指標「4DCodeBench」が公表された。静的再現に強い先端モデルも、変形や流体の動的再現は不安定と判明した。
米大学などの研究チームが、LLMの数学的理解を4能力で診断する新指標を提案した。正答率に隠れた弱点は「発見」にあり、補強で推論精度が向上するため、業務AIの品質改善に直結する。
スタンフォード大などの研究チームは、研究着想の源となった先行論文をAIが探せるかを測るベンチマークを公開した。最高性能のエージェントでも再現率は0.51にとどまり、R&D現場での検索支援の限界が示された。
研究チームが、プログラムで定めた世界の出来事を動画生成AIがどこまで正確に描くかを測る新評価基準PROWBenchを公開した。ゲーム開発の品質管理に影響し得る。
汎用AIエージェントに視覚操作で3D部品を組み立てさせる評価環境が公開された。最良系統でも部品単位の正答率は80.9%、完成品の成功率は59.4%にとどまり、製造現場への適用には精度面の課題が残る。
研究チームが、登場人物や伏線を構造化して追跡する学習不要の枠組みNstAgentを提案した。10万語規模でも整合性と文章品質が低下せず、出版・映像業界の制作工程に影響し得る。
研究チームは、実在するPythonリポジトリ12件から480問を作成した新ベンチマーク「SWE-Flux」を公表した。5種のLLMのうち最高の正答率は37%で、プログラム実行時の挙動の理解に課題が残ることが示された。
クルアーンのアラビア語に関する言語知識を測る評価基準「QuranicMMLU」が公開された。12システムの選択式正答率は平均84%だが、自由記述の品質は平均60%にとどまり、選択式評価が実力を過大に見せることが示された。
国際脳研究所を含む研究チームが、マウス139匹・276脳領域の記録を用いた評価基準「BrainWideBench」を公表した。事前学習の効果は確認されたが全課題で優れる手法はなく、研究投資の判断材料となる。
研究チームは、複数の参照素材から動画を生成する「オムニR2V」の評価基盤OmniVBenchと、業務用映像を主体とする学習データ34万件を公開した。既存モデルの弱点が可視化され、広告・映像制作での導入判断に資する。
ソフトウェア開発AIの性能比較に広く使われるベンチマーク3種を監査した研究が、評価スコアの信頼性に重大な問題を指摘した。AIツール導入投資の判断基準が揺らぐ可能性がある。
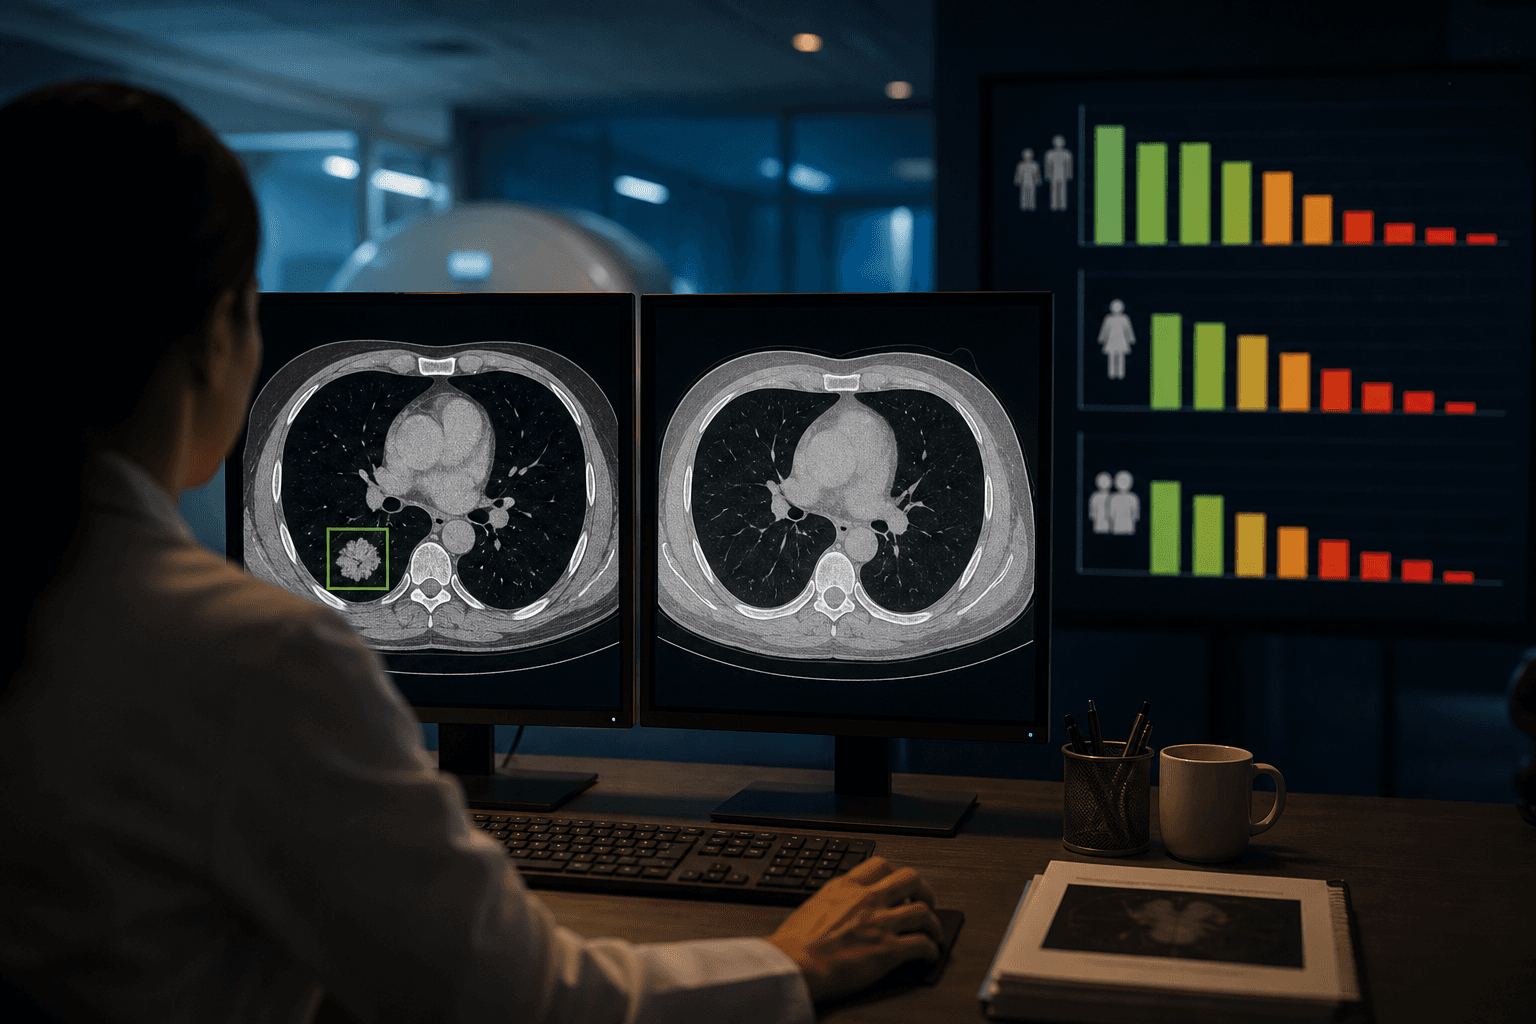
米研究チームが8万5000件超のCTスキャンを用いた大規模ベンチマーク「BenchX」を開発し、最先端のがん検出AIが若年・女性・アフリカ系患者など希少サブグループで精度が著しく低下することを実証した。医療AI導入を検討する医療機関や保険会社にとって、リスク管理の根拠となりうる知見である。
中国系スタートアップFrontisAIの研究チームが、実際の職場セッションから構築した企業AIエージェント評価基準「EnterpriseClawBench」を発表した。最先端モデルでも正答率66%止まりという結果は、業務自動化投資を検討する企業に重大な示唆を与える。
テキストから都市街路画像を生成するAIが、指定した道路区間を正確に再現できているかを測定する新ベンチマーク「GeoFidelity-Bench」が発表された。不動産・都市開発・広告業界のAI活用戦略に再考を迫る結果となっている。
ロシアの研究チームが12言語対応のAIコード評価基準「Multi-LCB」を開発し、主要LLMがPythonに過学習していることを実証した。企業のシステム開発部門におけるAIツール選定に直接影響する知見である。
中国科学技術大学らの研究チームが、LLMベースの論文検索エージェントを体系的に評価するベンチマーク「ScholarQuest」を発表した。現状の最高性能でも再現率が3割台にとどまり、企業研究開発における実用化への課題が浮き彫りになった。
オランダの研究チームが安全強化学習の新ベンチマーク「CRAX」を発表した。JAXによるハードウェア高速化で従来比最大100倍の試験速度を達成し、自律走行・産業ロボットの開発サイクルを大幅に短縮できる可能性がある。
ロシアの研究チームが12のプログラミング言語でLLMを評価できる新ベンチマーク「Multi-LCB」を公開した。Python偏重の既存評価手法の限界を突き、企業のAI開発ツール選定に根本的な再考を迫る。
米研究チームが創薬前臨床薬理領域向けAI評価基準「TxBench-PP」を公開。最高性能モデルでも正答率59.3%にとどまり、製薬企業のAI実用化判断に重大な指針を提示した。
米研究チームが発表したX+Slidesは、LLMによるスライド自動生成の精度を「聴衆の属性」で測る初の評価基準である。経営層向けと専門家向けで情報の優先度が異なるという実務課題に正面から応える。
大規模言語モデルが法的文書を中央値水準で生成できる一方、EU AI法が高リスクAIに義務付ける「適切な精度」を検証する評価基準が存在しないことが明らかになった。法務部門のAI導入戦略に直接影響を及ぼす。
カナダの研究チームが、AIエージェントによる個別最適化された業務ワークフロー予測を評価する初の体系的ベンチマーク「DRFLOW」を発表した。企業の業務自動化における精度検証の標準化に道を開く成果である。
米研究チームがAIエージェントのエピゲノム解析能力を測る評価基準「EpiBench」を公開した。最先端モデルでも正答率は45%に留まり、製薬・バイオ企業における自律型AI導入の限界が定量的に示された。
米カーネギーメロン大学らの研究チームが、AIエージェントの評価を自動化・標準化する枠組み「AgentBeats」を発表した。企業がAIシステムの導入判断に用いるベンチマークの信頼性が飛躍的に高まる可能性がある。