LLMの数学力、弱点は「発見」と判明
米大学などの研究チームが、LLMの数学的理解を4能力で診断する新指標を提案した。正答率に隠れた弱点は「発見」にあり、補強で推論精度が向上するため、業務AIの品質改善に直結する。
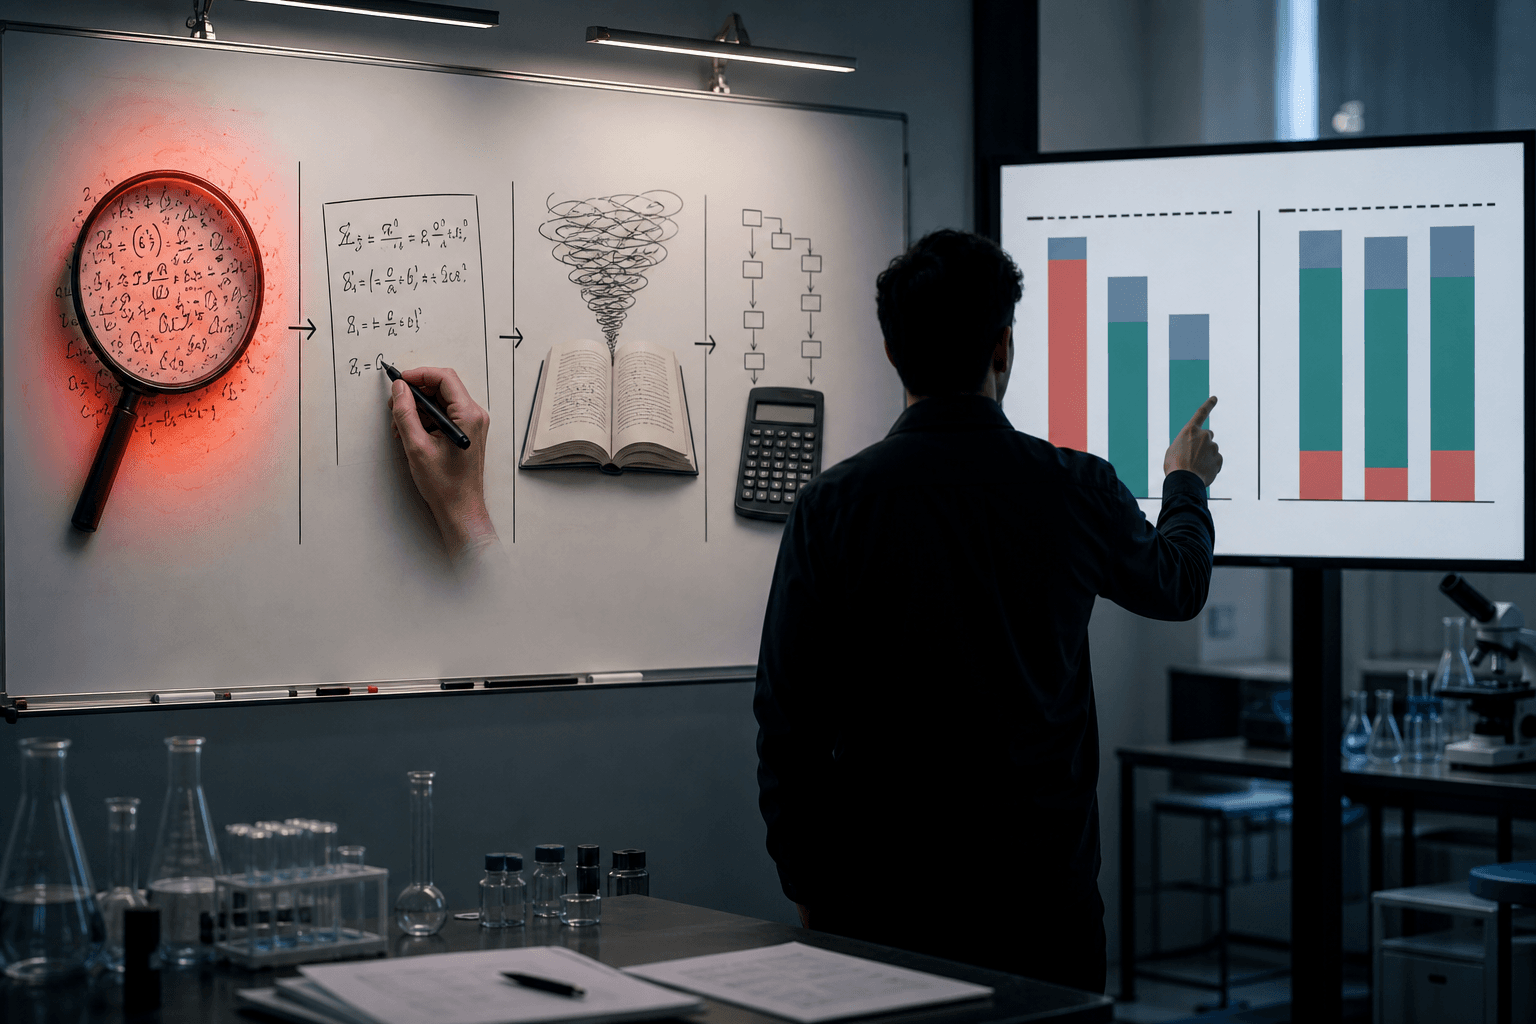
研究の概要
米国の研究チームは、大規模言語モデル(LLM)が数学の難問に対して解法の構造を実際に理解しているかを検証する研究を発表した。著者にはミラ・バンサル氏ら、AI分野で著名な研究者が名を連ねる。本研究は、単に最終解答の正否を見る従来の評価を超え、問題解決を支える最小単位としての「数学的プリミティブ」を導入した点に特徴がある。プリミティブとは、解法を構成する基本的な定理や操作の単位であり、これを基準にしてモデルの能力を細分化した。
研究チームは、数学的推論能力を発見、生成、消化、実行の四つの次元で測定する新たなベンチマークを構築した。各次元の定義は次の通りである。発見は解法の鍵となる要素や着想を見いだす力、生成は必要な補助要素や中間表現を作り出す力、消化は与えられた要素を正しく理解して取り込む力、実行は一度定まった手順を正確にたどる力である。これらを用いて複数モデルを診断したところ、三つの主要な知見が得られた。
第一に、従来の正答率が同程度のモデルであっても、四次元それぞれの能力配分は大きく異なる点である。つまり同じ総合的な正解数を示す場合でも、あるモデルは発見が得意で実行が弱い、別のモデルは発見が苦手だが実行は安定している、といった違いが存在する。第二に、もし適切なプリミティブをモデルに与えれば、潜在的に備わっている実行能力が大幅に引き出されることが分かった。第三に、数学的推論における最大の障壁は発見であるという点である。モデルはしばしば解法の鍵となる着想を見つけられず、したがって本来持つ実行力が発揮されない事例が多かった。
加えて事後学習(後学習)に関する分析では、発見の不足に起因する失敗は比較的修復が容易であることが示された。これを踏まえ研究チームは、プリミティブを特権情報として教師モデルに与え、そのより良い推論を生徒モデルへ選択的に転移する自己蒸留の枠組みを提案した。複数のモデル規模と難度の高いベンチマークにおいて、既存手法を一貫して上回る改善が報告されている。重要な点は、教師にのみ追加情報を与えて蒸留するため、推論時には追加情報を与える必要がなく、小型モデルの運用時に精度を底上げできる点である。
しくみをやさしく
本研究の核は「どの段階でモデルがつまずいているか」を見分けることである。従来の評価は完成品(解答)が正しいかだけを見るため、間違いの原因がわかりにくい。研究はそれを分解し、解法を作るために必要な最小要素=プリミティブを基準にして、モデルがそれを見つけられるか(発見)、作れるか(生成)、理解できるか(消化)、そして手順を実行できるか(実行)を個別に測る。
たとえば、ある数学問題で正しい中間式を生成できるモデルでも、最初の着想(発見)が欠けていると正解には到達しない。逆に発見が与えられれば、既に備わっている実行力で解を導ける場合が多い。このように失敗の原因を切り分ければ、補強すべき点が明確になり、学習コストを抑えた改善が可能になる。
自己蒸留のイメージも平易である。専門家(教師)には追加情報を見せて正しい推論をさせ、その過程と出力を使って軽量なモデル(生徒)を訓練する。こうすることで、生徒は推論時に追加情報を受け取らなくても、教師のような振る舞いを模倣できるようになる。結果として小型モデルの推論コストを抑えながら精度を高められる可能性がある。
ビジネスへの示唆
本研究の示唆は、AIを業務で使う際の評価基準と改善の考え方を根本的に変える点にある。特に以下のような「繰り返し発生する業務」に直接応用できる。
- 財務・会計チームが行う月次試算の再計算や監査支援。ここでは誤り検出率や再計算にかかる工数がKPIとなる。自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを問い直すべきである。
具体的に自分ごとに落とし込む問いは次の通りである。自部署で扱う定型的な数値処理や論理的手順のどの部分が“着想(発見)”を要するか、どの部分が単純な手順遂行(実行)にすぎないか。現在の担当者やモデルがどの程度の割合で手を動かしているか、たとえば月次レポートで人が介入している時間や差し戻し率を数値で把握してみるとよい。発見の比率が高い作業であれば、モデルの発見力を補強する設計が必要となる。
-
製造の設計レビューや工程最適化。設計レビューの手戻り率や不良率が主要KPIである。自部署で設計計算のどの工程が人間の着想に依存しているか、逆に手順通りに計算すれば済む部分はどこかを洗い出すことで、モデルに与える補助情報(プリミティブ)や蒸留の対象を定められる。
-
教育分野の個別指導AI。学習者のつまずき位置の特定精度や学習定着率がKPIとなる。誤答の原因が発見、消化、実行のどれに該当するかを切り分けることで、学習コンテンツやフィードバック設計を最適化できる。
これらの業務においては、単に総合正答率を追うのではなく、能力別の評価結果を用いてモデル選定や施策の優先順位を決めることが重要である。情報システム部門やデータサイエンス部門は、従来の総合得点中心の比較から、自社業務に必要な能力(例えば着想型の発見か、手順重視の実行か)を基準にした評価へと方針転換する必要がある。
また自己蒸留の枠組みは実務的な利点を提供する。教師にのみ与えた追加情報を通じて小型モデルの精度を高められるため、推論時の追加情報なしに高精度を維持できる。これによりクラウド推論費用の抑制やオンプレミスでの小型モデル運用に適した選択肢が得られる。コスト面では「小さく・安く始められる」可能性がある一方で、プリミティブ設計や教師側の追加情報準備には専門知識が必要である点を念頭に置くべきである。
現場での導入イメージ
仮に導入支援に入るなら、次の四段階のフローで進めることを提案する。
- 棚卸し(作業の現状把握と失敗モードの特定)
- 何をするか:まず対象業務の業務フロー、入力データ、現行の手戻り率や工数、担当者の作業分担を詳細に記録する。過去の誤り事例を抽出し、どの誤りが発見不足に起因するか、生成/消化/実行のどの段階の失敗かを分類する。
- 目指す到達点:誤りの原因が「発見」に多く偏っているか、「実行」だかが明確になり、改善の優先度が定まる。優先的に検証すべきユースケースのリストが得られる。
- 差し込み先の設計(既存ツールやワークフローへの組み込み方を決める)
- 何をするか:現在使っているBIツール、RAG(Retrieval-Augmented Generation)やワークフロー管理ツールのどこにモデルの出力やプリミティブを差し込むか設計する。新たなツールを無理に導入せず、既存の業務フローに付加する形で追加情報の表示や介入ポイントを定める。
- 目指す到達点:実運用時に担当者の手間を増やさず、モデルの出力が自然に参照される仕組みが設計される。運用コストを抑えつつ、発見支援や手順検証を行える配置が決まる。
- 小さく試す(PoC:プリミティブ付与と自己蒸留の実験)
- 何をするか:限定されたデータセットと少数の業務ケースでプリミティブを設計し、教師モデルでの追加情報を用いた推論を行う。その出力を用いて小型生徒モデルへ自己蒸留を行い、導入前後で誤り率や処理時間、人的介入頻度を比較する。
- 目指す到達点:発見の補強が実際に誤り削減や工数低減につながるかを検証し、効果が確認できる場合にのみスケールを検討する。初期投資を抑え、失敗リスクを限定する。
- 運用と横展開(本番運用と他業務への拡張)
- 何をするか:PoCで得たプリミティブ設計と蒸留済みモデルを本番環境に展開し、運用体制(監視・フィードバック・定期再学習)を整備する。運用中に収集した誤りログをもとにプリミティブや蒸留手順を改善し、効果が確認できた他の業務へ横展開を行う。
- 目指す到達点:継続的に誤り率や人手介入を低下させる運用が始まり、横展開によって部門横断的に品質改善が波及する状態を実現する。
最終的なエンゲージメントの到達点は、業務ごとの失敗モードが明確に診断され、発見不足に対する有効な補強策(プリミティブ設計+自己蒸留)が恒常的に運用されることである。これにより人手によるチェックや再計算の工数を大幅に減らしつつ、小型モデルでの安定運用を達成することを目指す。
今後の展望
研究が示す次の焦点は、数学以外の業務領域への適用である。会計、法務、医療など、問題の核心を見いだす「発見」の能力が精度を左右する業務は多い。もし同様の構造が確認されれば、業務別の診断指標と補強のための自己蒸留手法が新たな市場やサービスを生む可能性がある。
ただし注意点も明確である。本研究は数学ベンチマーク上での検証結果に基づくため、実業務の曖昧な指示や雑多な文書が混在する環境で同じ効果が出るかは未検証である。またプリミティブ設計や教師モデル側の追加情報準備には専門知識が必要であり、導入時のコストと効果を見極めた段階的な投資判断が不可欠である。
企業にとっての当面の実務的示唆は明快である。AIの誤りを一括りに扱うのではなく、原因別に診断して対策を打つことが品質向上の出発点となる。モデル提供事業者に対しても、能力別の評価結果の開示を求める動きが調達の現場で広がることが予想される。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AIが能力を隠せると証明、評価の限界露呈
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

ReLU網が描ける形状の規模を数学が証明
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

概念を隠して画像AIの判断根拠を探る新手法
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
