動画生成AI、ゲーム規則への忠実度を測る指標
研究チームが、プログラムで定めた世界の出来事を動画生成AIがどこまで正確に描くかを測る新評価基準PROWBenchを公開した。ゲーム開発の品質管理に影響し得る。
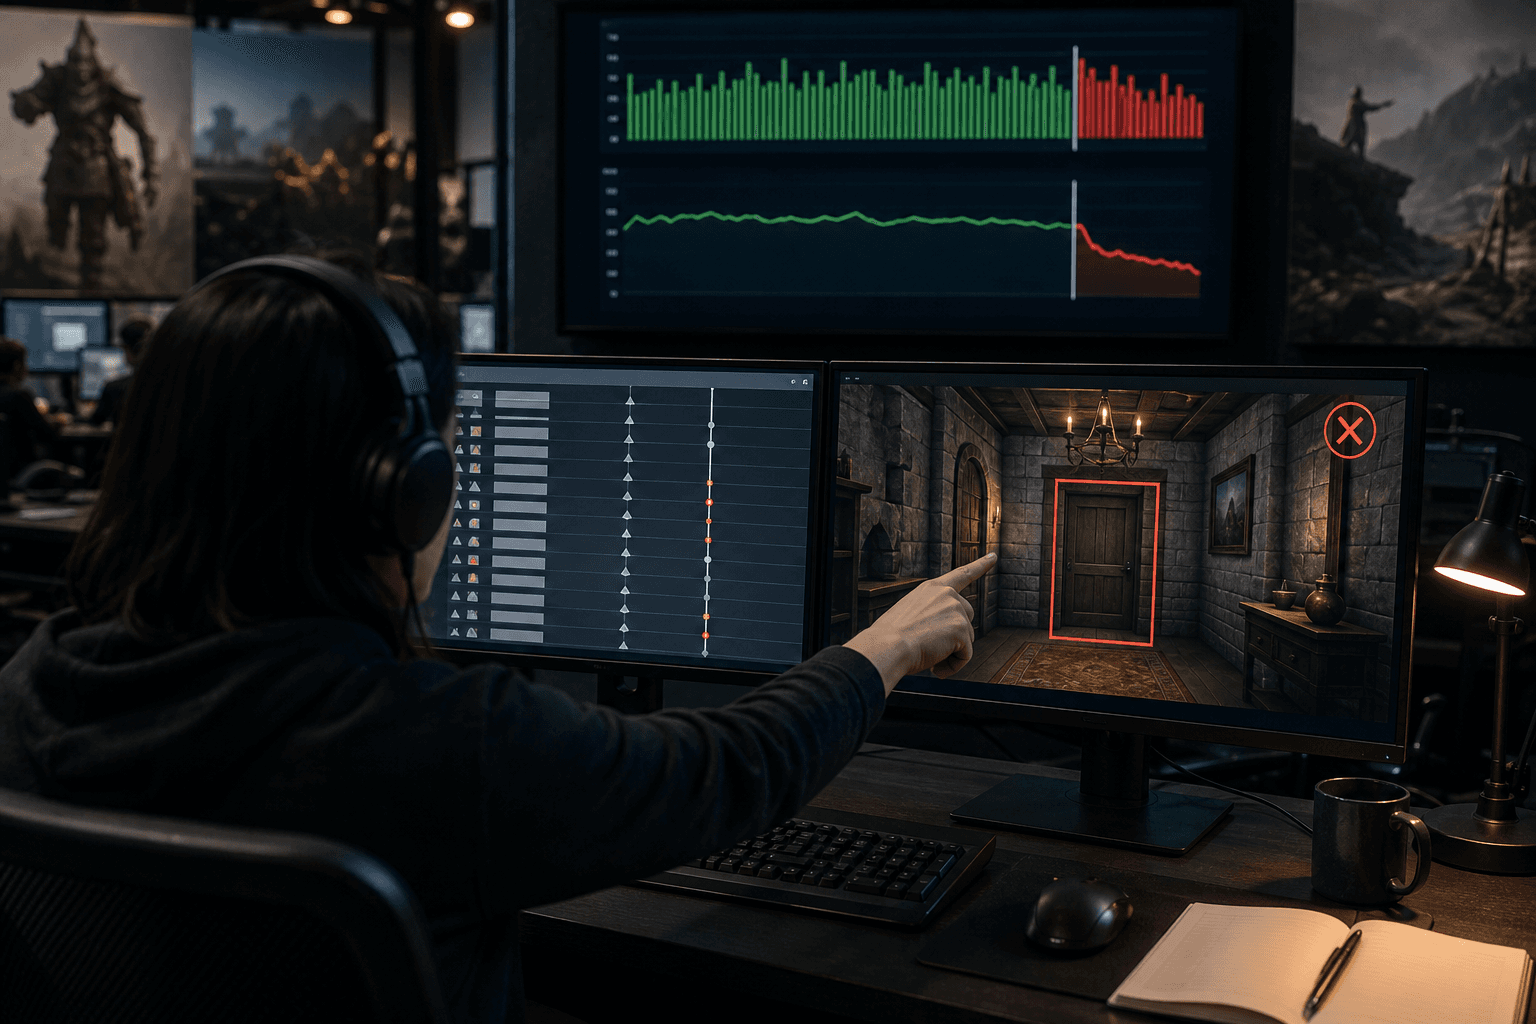
研究の概要
Zheng-Hui Huang氏らの研究チームは、プログラムで定めた世界の規則や出来事を動画生成AIがどこまで忠実に映像化できるかを検証するベンチマークPROWBenchを公開した。論文はarXivに公開されており、従来の画質や操作性中心の評価では捉えきれなかった「規則通りの出来事が映像に反映されているか」を定量的に測ることを目的としている。
PROWBenchは、プログラムで構築した170のエピソードと600の代理動画で構成される。各エピソードはエンティティの状態と時刻付きの出来事を含む「再生可能な世界記録」として保存され、カメラの視野外で起きた出来事も記録に含める点が特徴である。これらの記録から複数視点の映像を生成し、粗い3D表現や境界ボックスなど異なる出力形式にも対応するため、生成結果をプログラム実行の期待値と照合できる。
評価軸は主に三つに分かれる。エンティティの制御の正確性、長期にわたる記憶の保持、そして二種類の視覚言語モデル(VLM)ベースの指標である。Logic-Render Alignmentは規定された時系列への適合度を数値化し、Interaction Success Rateは記録された出来事が視覚的にどれほど再現されているかを測定する。視点は一人称と三人称の双方を扱い、一部エピソードでは複数視点の同期観測も提供することで、実運用に近い検証が可能となっている。
PROWBenchは単なるデータ集合ではなく、プログラム可能な世界を作り、その実行結果を映像に変換して検証するワークフローを内包する点でユニークである。評価は自動化された判定器を用いるが、VLM依存の限界やベンチマーク規模の制約についても論文で明示されている。
しくみをやさしく
PROWBenchは次の三段階で働く。まずプログラムで“世界”を定義し、そこにエンティティと出来事の時間軸を記述する。次にその実行ログを「再生可能な世界記録」として保存し、最後にその記録を基に複数の視点で映像を生成する。生成された映像は期待される出来事の時系列やエンティティの位置、相互作用と照合される。
比喩を用いれば、シナリオ(規則)を書いた台本があり、その台本に従って役者(エンティティ)が演じた舞台(世界記録)を複数のカメラで撮影し、出来上がった映像を台本と突き合わせて演出ミスがないか確認する仕組みである。ここでの新しさは、台本の段階で細かく「視野外での出来事」や長時間の因果関係まで指定できる点と、それを映像生成モデルの成果物にまで落とし込んで自動評価できる点にある。
評価の技術的な要点としては、生成映像を自然言語と結び付けるVLMを判定器として使う点と、粗い3D表現や境界ボックスなど複数の出力表現を比較対象にできる点が挙げられる。これにより、単なる画質評価では見えない「ルールどおりに動作しているか」が測られる。
ビジネスへの示唆
最も直接の適用先はゲーム開発の開発・QA部門である。具体的な繰り返し業務としては、バトルやアイテム取得、イベントトリガーの検証作業が該当する。自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを問う必要がある。例えば日次で行うリグレッションテストにおいて、どの工程で人手が発生しているか、検証に要する時間と人員、そしてリリース後の手戻り件数を洗い出すべきである。
KPIは具体的に結びつける。開発・QA部門であれば「不具合検出率」「リグレッションテストの工数」「リリース前の手戻り件数」を主要指標とし、PROWBenchによる自動評価を導入した場合にこれらの指標がどう変化するかを目標値として設定する。研究開発部門は候補モデルの比較に用いる規則忠実度スコアを採用すれば、技術選定の客観基準が得られる。運営・サポート部門は「表示不整合に起因する問い合わせ件数」と「プレイ継続率」を追い、映像の不整合がユーザー離脱に結びついているかを数値で確認する。
ゲーム以外では、工場や物流のデジタルツイン、ロボットや自動運転のシミュレーションが該当する。発生する繰り返しタスクは学習データの品質管理であり、自部署で検証しているシミュレータ出力と映像の突合作業がどの程度手作業かを把握することが出発点となる。視野外の出来事や長期記憶の評価は、監視や訓練用途での信頼性指標に直結する可能性がある。
広告・映像制作現場では、台本通りのカットや演出が再現されているかを定量化する用途が想定される。繰り返し発生するチェック業務を自動化すれば、人手のコストを小さく・安く減らせる可能性がある。
問いかけとしては、まず自部署で「台本(規則)と映像の突合検証」をどの程度行っているかを整理し、次にPROWBenchで測れる指標が現在のKPIをどのように改善し得るかを具体的に見積もることが重要である。
現場での導入イメージ
仮に導入支援に入るなら、以下の四段階のワークフローを想定する。
- 棚卸し
- やること: 現行の検証プロセス、テストケース、手作業で行っている突合業務を洗い出す。どのイベント(アイテム取得、扉の開閉など)が頻出かを分類する。目指す到達点: 自動化候補となる検証対象の優先リストと、それに紐づく現行KPIを明確化する。
- 差し込み先の設計(既存ツール優先)
- やること: 現行のCI/CDやテストフレームワーク、ログ収集基盤にPROWBenchベースのチェックをどこに組み込むか設計する。新ツールを増やさず、既存のレンダリング/ログワークフローに判定器を差し込む現実解を検討する。目指す到達点: 最小限の変更で導入可能な差し込み設計と必要なインタフェース仕様の確定。
- 小さく試す(PoC)
- やること: 優先リスト上位の5〜10のエピソードに相当する短期PoCを実施し、PROWBenchのLogic-Render AlignmentやInteraction Success Rateで初期スコアを測定する。VLM判定器の誤判定傾向を人手で確認し、評価器のチューニング方針を決める。目指す到達点: PoCで自動評価が現行の手作業と比べてどの程度の工数削減と検出精度を達成するかの定量的見積もり。
- 運用と横展開
- やること: PoC結果を踏まえ、評価エピソードの拡張、VLM判定器の補正ルール導入、人手による二重チェックの運用設計を行う。運用チームに対する運用手順書とモニタリングダッシュボードを整備し、他部門への横展開計画を策定する。目指す到達点: 日常的な品質保証工程にPROWBenchベースの自動評価が組み込まれ、定期的にKPI改善効果が確認できる運用体制の確立。
最終的な目標状態は、映像生成を含むレンダリングパイプラインにおいて、規則忠実度を定量的に監視できることにある。これにより、リリース前の手戻りを減らし、モデル選定や技術投資の意思決定をデータ駆動で行えるようにする。
今後の展望
PROWBenchは拡張可能な枠組みとして設計されており、シーンや挙動の種類を追加することで評価範囲を広げられる点が強みである。評価対象のモデルが増えれば、規則忠実度を比較する共通尺度として定着する可能性がある。
ただし現状ではVLM依存の判定精度や170エピソードのカバレッジといった制約が残るため、企業導入時には自社仕様のエピソード追加や人手による補正を併用する現実的運用が求められる。これを踏まえ、段階的に「小さく・安く」始めて効果を測定しつつ拡張していくのが現実的な道筋である。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボット方策、物理時間を明示し遅延に強く
Chronos Policyは、観測の取得時刻と行動の実行時刻をロボット方策に明示的に与える手法である。センサーや推論の遅延が揺れる現場でも、動作の安定性を保てる可能性を示した。

スマホ撮影だけでロボを現場適応させる技術
スマートフォンによる室内スキャンだけで、汎用ロボット制御AIを個別の現場に適応させる手法が登場した。実機での把持成功率は63.9%に達し、現場ごとの実演収集コストを抑える道を開く。

物理を備えた3D資産をAIが自動生成
オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。
