ヒューマノイド、再学習なしで新作業を習得
研究チームは、ヒューマノイドロボットが未学習の作業を再学習なしでこなす手法「InterEvolve」を発表した。LLMが報酬プログラムを自ら改良する仕組みで、実機での自律動作も確認した。
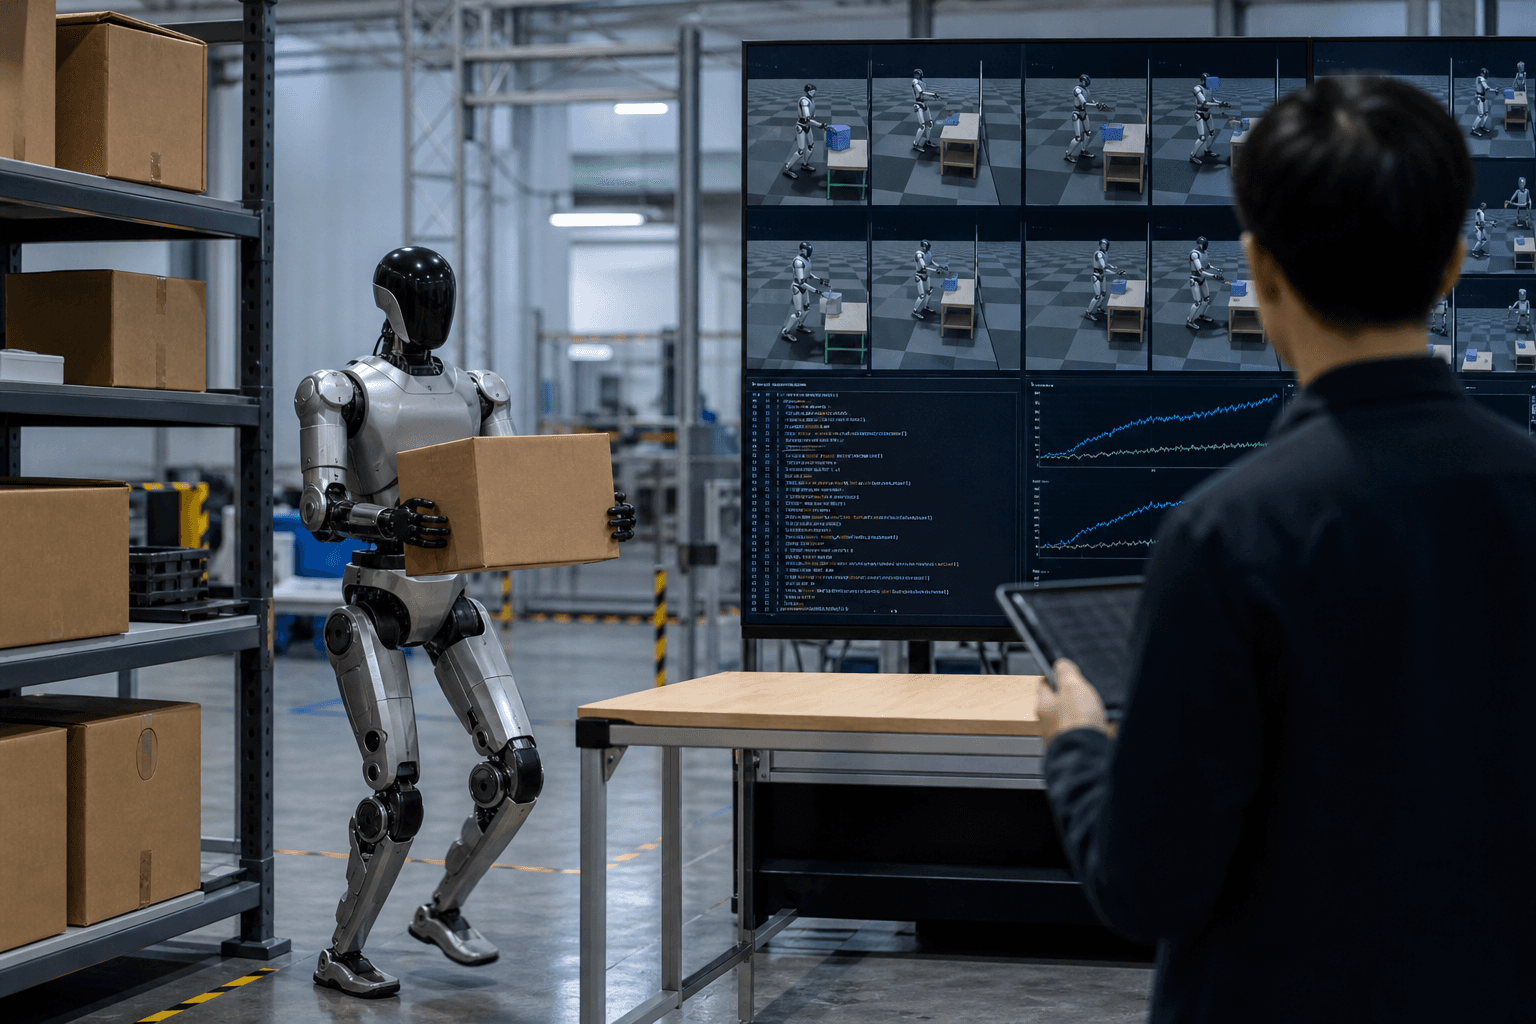
研究の概要
研究チームは、ヒューマノイドロボットが訓練時に想定されていない新しい作業を、コントローラーの再学習を行わずに実行・習得する手法「InterEvolve」を提案し、論文をarXivで公開した。特徴は、既に幅広い動作を学習した汎用コントローラーの能力をそのまま転用し、実行時の試行結果に基づいて自律的に報酬記述を改善していく点である。論文はこの過程を「テスト時進化」と呼び、得られた知識を保持して次の試行に反映させる仕組みを示している。
手法は大きく二つの要素から成る。第一は、物体を考慮した順方向・逆方向(FB)行動基盤モデルである。身体に関する事前知識は固定したまま、物体用の補正項を加えることで、身体や物体に関する新たな報酬をテスト時に物を扱う動作へ変換する。これにより、既存コントローラーの間で未利用の能力を引き出すことが可能となる。
第二は、作業を報酬プログラムとして記述する方式である。報酬プログラムは完了条件と調整可能な定数を備えた段階的な報酬の集合として表現される。大規模言語モデル(LLM)を用いたエージェントが、実行結果のフィードバックと検証済みプログラムのスキルライブラリを参照しながら、プログラム構造を書き換えていく。プログラム内の定数は数値最適化器が調整し、すべての候補は並列のシミュレーション環境で検証される。反復を重ねるごとに性能が向上する設計である。
論文中の実験では、人手で設計した報酬ではFBモデルの能力の多くが使われずに残される事例が見られた。InterEvolveが進化させたプログラムはその潜在能力を引き出し、人間が想定しない戦略に至る例も確認された。多様な作業、複雑な状況、長時間にわたる作業の連結といった条件下でも動作を生成でき、進化したスキルはUnitree G1の実機で、搭載センサーによる自己視点の知覚のみを用いて自律的に動作する実証も報告されている。
しくみをやさしく
基礎となる考え方はシンプルである。すでに多くの基本動作を持つコントローラーがあり、その中に新しい仕事を成し遂げるための「素材」はある。問題はその素材をどう組み合わせ、どう評価するかである。ここでの答えは、作業を段階的に記述した報酬プログラムを用意し、実行結果を基にプログラムを自動で書き換えながら改善するという流れである。
具体的には、ロボットが試みた結果をセンサーで計測し、それに応じてLLMが報酬プログラムの条件や構造を修正する。修正された複数候補を並列でシミュレーションし、最も良好なものを選んで実機に反映する。こうして人間が最初から完璧な報酬を設計しなくても、ロボット側で“試行錯誤しながら最適化していく”仕組みが成立する。
また、身体知識は固定しておき物体側の補正だけを加える設計にすることで、既存の運動能力を壊さずに物を扱う行為を獲得できる点が特徴である。要は、学習済みの動きの再利用と、試行結果に基づく報酬記述の自動進化の組合せによって、新しい作業を再学習なしで習得する道が開かれるのである。
ビジネスへの示唆
自社のどの業務がこの技術で効率化されるかを想像するために、具体的な繰り返し業務を挙げる。代表的なのは倉庫の「仕分け・積み替え作業」、製造ラインの「ライン切り替え時の段取り作業」、および小売現場での「棚入れ・商品陳列」のような接触を伴う多段階作業である。たとえば倉庫であれば、日々の品目差・パレット形状の変化を前にした再ティーチング頻度が重要な関心事となるはずである。
自部署で問い直すべき具体的な質問は次のようになる。自部署で該当する業務は何か、いま誰がどれだけ手をかけているか。報酬設計や模倣データ収集に何人日を割いているか、ライン切り替えの平均ダウンタイムはどれほどか、現場での人手介入はどの段階で発生しているか。これらを洗い出すことで、技術導入後に改善が見込めるKPIが明確になる。
注目すべきKPIの例は以下である。
- 新規作業の立ち上げに要するリードタイムとロボット工学者の設計工数の削減可能性
- 多品種少量生産でのライン切り替え時間と再ティーチングの頻度の短縮
- 倉庫での仕分け・積み替え作業における成功率と人手介入の回数の低減
- ロボット1台あたりの稼働率と運用コストの変化
本手法は、作業ごとに専用の学習データを用意する従来発想を、既存の基盤モデルを使い回し作業定義だけを差し替える発想に転換させる可能性がある。検証済みプログラムを蓄積するスキルライブラリは、作業ノウハウを社内資産として管理する枠組みとなり得る。また、ロボットメーカーは基盤モデルを出荷し、顧客側が現場で作業を追加していく販売モデルを検討しやすくなるだろう。
現場での導入イメージ
仮に導入支援に入るなら、以下の4段階で進めることを提案する。
-
棚卸し(現状把握) 何を対象に自動化を目指すか、具体的な業務フローと担当者・時間・頻度を細かく洗い出す。目指す到達点は、改善候補となる作業の優先順位と現状KPI(立ち上げ期間・ダウンタイム・人手介入頻度など)を明示することで、PoCの評価軸を確定することである。
-
差し込み先の設計(既存ツールとの接続設計) 既存の運用ツールやMES、倉庫管理システムに対して、報酬プログラムやスキルライブラリをどの層に差し込むかを設計する。新しいツールを増やさない現実解としては、既存のロボット管理インターフェース上に報酬定義の管理機能を組み込む案を検討する。目指す到達点は、現行運用に最小限の変更でInterEvolveの試験運用を始められる統合ポイントを確定することである。
-
小さく試す(PoC) 限定された作業・時間帯・台数でInterEvolveによる報酬進化を実施する。シミュレーションと実機の並行検証を行い、実機での自己視点センサーだけでの自律動作が確保できるかを確認する。目指す到達点は、現場での成功確率と人手介入要因を定量化し、本格導入の見込みと投資対効果の初期推定を得ることである。
-
運用と横展開 PoCで得た検証済みプログラムをスキルライブラリに蓄積し、運用ルールと安全手順を策定する。複数拠点や類似工程への横展開計画を作り、スキル共有の運用フローを整備する。目指す到達点は、現場で新作業を迅速に追加できる体制と、運用中に定期的な安全性・性能チェックが回る仕組みを確立することである。
以上の工程を通じて目指す総合的な最終状態は、現場担当者が専門的な報酬設計の知識を持たなくとも、既存の基盤モデルを用いて短期間で新作業を追加・運用できる体制である。これにより、現場のチューニング負荷を小さく・安く始められる形で低減し、スキルの社内資産化と横展開を実現することが狙いである。
今後の展望
留意点として、論文の主な検証はシミュレーションであること、実機での実証は限定的であることが挙げられる。生産性改善や工数削減の定量的効果は現時点で示されておらず、LLMによる反復生成や並列シミュレーションには計算コストが伴う。また、人と同一空間での作業における安全性の担保は別途の検証と設計が必要である。
それでも、ロボットに「何を達成すべきか」を報酬として書き、失敗から自動で改善される流れは、現場導入の障壁である個別チューニングの負担を減らす方向に働く可能性がある。今後は、長時間運用時の信頼性、複数拠点でのスキル共有、既存生産管理システムとの実運用連携が焦点になる。ヒューマノイド事業化を目指す企業は、ハード性能だけでなく「新しい作業を現場でどれだけ速く安全に追加できるか」を競争軸として評価する段階に入ったと言える。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボット方策、物理時間を明示し遅延に強く
Chronos Policyは、観測の取得時刻と行動の実行時刻をロボット方策に明示的に与える手法である。センサーや推論の遅延が揺れる現場でも、動作の安定性を保てる可能性を示した。

スマホ撮影だけでロボを現場適応させる技術
スマートフォンによる室内スキャンだけで、汎用ロボット制御AIを個別の現場に適応させる手法が登場した。実機での把持成功率は63.9%に達し、現場ごとの実演収集コストを抑える道を開く。

物理を備えた3D資産をAIが自動生成
オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。
