分子AI、環構造を文法化し創薬生成を高精度化
米スタンフォード大などの研究チームが、分子の環構造を生成規則の列として表現する新手法HGRを開発した。生成分子は常に有効で、創薬AIの基盤モデル性能も大幅に向上した。
研究の概要
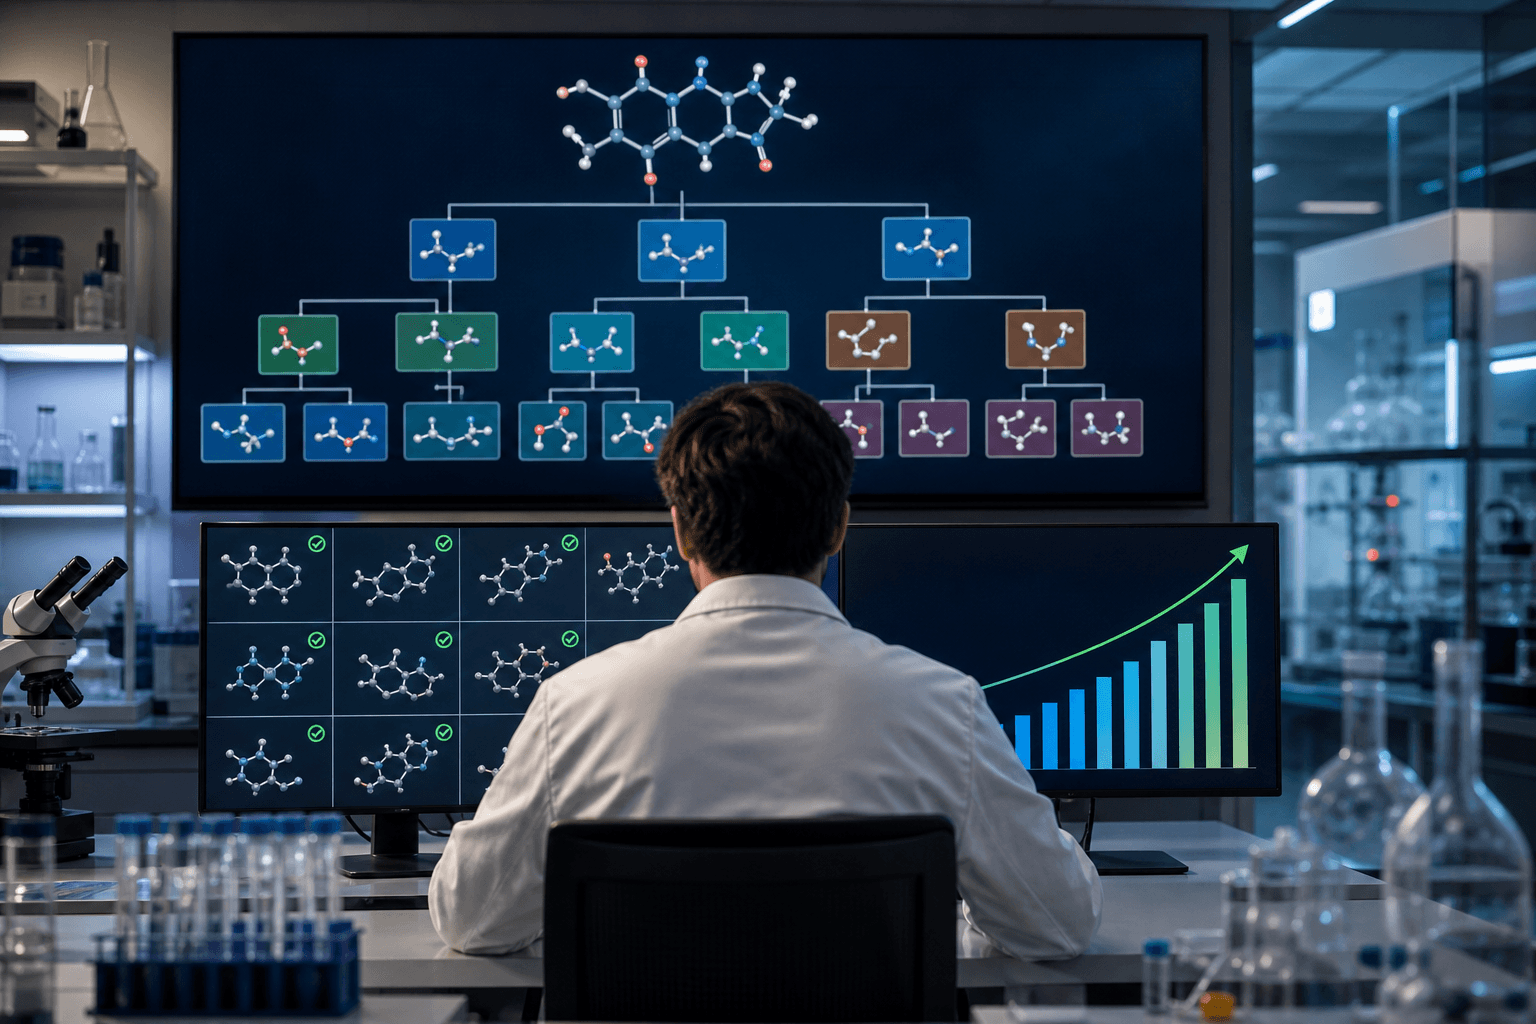
スタンフォード大学のJure Leskovec氏らが発表した「高次文法表現(HGR)」は、分子の環状構造や繰り返し現れる部分構造を文脈自由文法に基づく生成規則の系列として記述する新たな表現手法である。従来の文字列表現やグラフ表現では、縮合環系など複数の環が絡み合う高次トポロジーを明示的に扱うことが困難であったが、HGRは分子を組合せ複体として扱い、規則の系列に変換することで、標準的な系列モデルをそのまま適用できる点が特徴である。これにより計算コストを大きく増やすことなく、高次構造情報を保持できるという利点を示した。
評価用に研究チームが構築したベンチマーク「RingDiv」は、環構造を豊富に含む118万分子から成り、環系の網羅度を測る新指標である環多様性指数(RDI)も提案されている。既存ベンチマークが単純な環に偏るという問題意識に基づいた設計である。
分子生成実験では、HGRベースのモデルが生成分子の構造的有効性を100%保証すると報告された。さらに、生成分子の分布の近さを測るFCD指標では5つのベンチマークで首位となり、表現学習の面では基盤モデルHGR-FMが7種のMoleculeNetベンチマークで最高の平均AUCを記録した。比較手法に対しては、特徴量を固定するプロービングで8.3ポイント、全体再学習による完全微調整で3.3ポイント上回る改善を示した。
ただし本研究の評価は公開ベンチマーク上での結果であり、合成可能性、薬理活性、安全性といった実運用上の要件は別途検証が必要である点は留意される。
しくみをやさしく
HGRは分子をバラバラの記号列ではなく、部品の組合せ方を表す「ルールの並び」として記録する。環や頻出モチーフをあらかじめ部品(非終端記号)として扱い、それらをどうつなげるかを生成規則で記述するイメージである。これにより、複雑な環系も「ある種の文法」に従う一連の手続きとして表現できる。
言語処理で用いる系列モデル(例えばトランスフォーマーなど)にこの系列を入力すれば、従来のSMILESのような単純な文字列よりも高次構造を反映した学習が可能となる。加えて、規則に従って復元すれば常に有効な分子構造が得られるため、無効な候補を除外するための後処理コストを抑えられる点が実務上の利点である。
ビジネスへの示唆
最も直接的な恩恵を受けるのは創薬研究部門である。日々の反復作業として、候補化合物の生成→フィルタリング→スクリーニングという流れが存在するが、生成段階で無効な構造が混入すると後工程での人手・計算リソース消費が増える。ここでの自分ごと化としては次の問いが重要である。
- 自部署で該当する業務は何か。例えば創薬研究部門であれば「リード候補の探索と一次スクリーニング」や、ケモインフォマティクス部門であれば「生成モデルの学習と推論運用」が該当する。
- いま誰がどれだけ手をかけているか。生成後に無効分子を除去する作業や合成可否の確認、前臨床用の物性予測にどれだけのエンジニア・化学者の工数と計算時間が割かれているかを明確にする。
具体的なKPIの紐づけ例は既存の示唆に沿う。創薬研究なら「ヒット率」「候補化合物の有効分子率」「探索サイクル日数」、ケモインフォマティクスなら「学習・推論コスト」「予測精度(AUC)」、素材開発なら「新規骨格の探索数」「試作回数の削減率」、知財部門なら「新規性を持つ化合物クレームの出願件数」を目標に設定する。表現学習が改善する点は、社内データが少ない環境でも事前学習済み基盤モデルを転移して利用でき、小さく・安く始められる導入が現実的である。
現場での導入イメージ
仮に導入支援に入るなら、以下の4段階で進める。各ステップでの作業内容と目指す到達点を明確にする。
- 棚卸し
- 何をするか:既存の化合物ライブラリ、生成モデルの運用状況、前工程・後工程での手作業や計算コストを洗い出す。データ品質(構造表現の形式、アノテーションの有無)も確認する。
- 目指す到達点:どの業務フローで無効分子や再現性の低さがボトルネックになっているかを特定し、改善効果が見込める優先領域を決定する。
- 差し込み先の設計(既存ツール優先)
- 何をするか:現行の設計開発環境やRAG(Retrieval-Augmented Generation)を含む情報基盤に、HGRベースの生成・検証機能をどのように差し込むか設計する。新たなツールを大幅に増やさず、既存のワークベンチやLIMSに統合する現実解を検討する。
- 目指す到達点:既存運用を壊さずに、生成段階での有効性保証を挿入できる最小限のアーキテクチャ案を確定する。
- 小さく試す(PoC)
- 何をするか:選定した小規模ライブラリや代表的な化合物群でHGRベースの生成器と既存評価パイプラインを接続し、実データでの有効性率、FCDやAUCの変化を測定する。合成可能性や候補分子の多様性も評価する。
- 目指す到達点:実務上の改善余地が数値化でき、投資対効果の判断に足る定量データが得られること。
- 運用と横展開
- 何をするか:PoCの結果を基に、学習・推論インフラのスケール設計、運用ルール(モデル更新、品質管理)、他部門への横展開計画を策定する。社内データでの微調整やプロービング手法による精度改善の運用化も含める。
- 目指す到達点:日常運用で候補生成から一次フィルタまでの自動化を達成し、ヒット率や探索サイクル短縮など設定したKPIで改善を実証できる状態。
全体の目標としては、生成段階で構造的に有効な候補を出すことで後工程の無駄を削減し、探索サイクルの短縮とR&Dコストの低減を実現することを掲げる。
今後の展望
HGRの形式は言語モデル基盤との親和性が高く、大規模化合物データで事前学習した基盤モデルを自社データで微調整する運用が組みやすい。RingDiv上の優位性が自社ライブラリでも再現されるか、合成可能性や薬理・安全性評価を含めたトータルな有用性を実務で検証することが次の一手となる。企業はまず小規模な実証実験を通じて候補分子の有効率や予測精度の改善幅を実測し、導入の費用対効果を判断することが求められる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
生成・検証・改善で視覚推論を実現
英国の研究チームが、候補の生成、検証、反復改善を一体化した推論枠組みGenVerOptを提案した。IQパズルや前立腺がん領域の抽出で人間や臨床医に並ぶ成果を示し、画像判断業務の自動化に道を開く。
臓器グラフでCTと所見を融合し病期予測
CT画像と読影レポートを臓器単位のグラフで結び付け、喉頭咽頭がんのT分類を予測する枠組みが提案された。腫瘍の手作業での切り出しを要さず、生検に頼る診断の補完を狙う。
RNA動態をAIが生成・理解する基盤が登場
RNADynBenchとRNADynNetが公開された。2585本の全原子MD軌道を整備し、軌道生成と動態理解を単一モデルで扱う。RNA創薬の探索工程を効率化する基盤として注目される。