人間視点動画の拡大、物体理解に限界
3万時間の一人称視点動画で世界モデルを学習した研究が、人の動きは高精度に再現できる一方、物体の挙動は大幅に遅れると報告した。実用化の鍵はデータ量より学習設計にある。
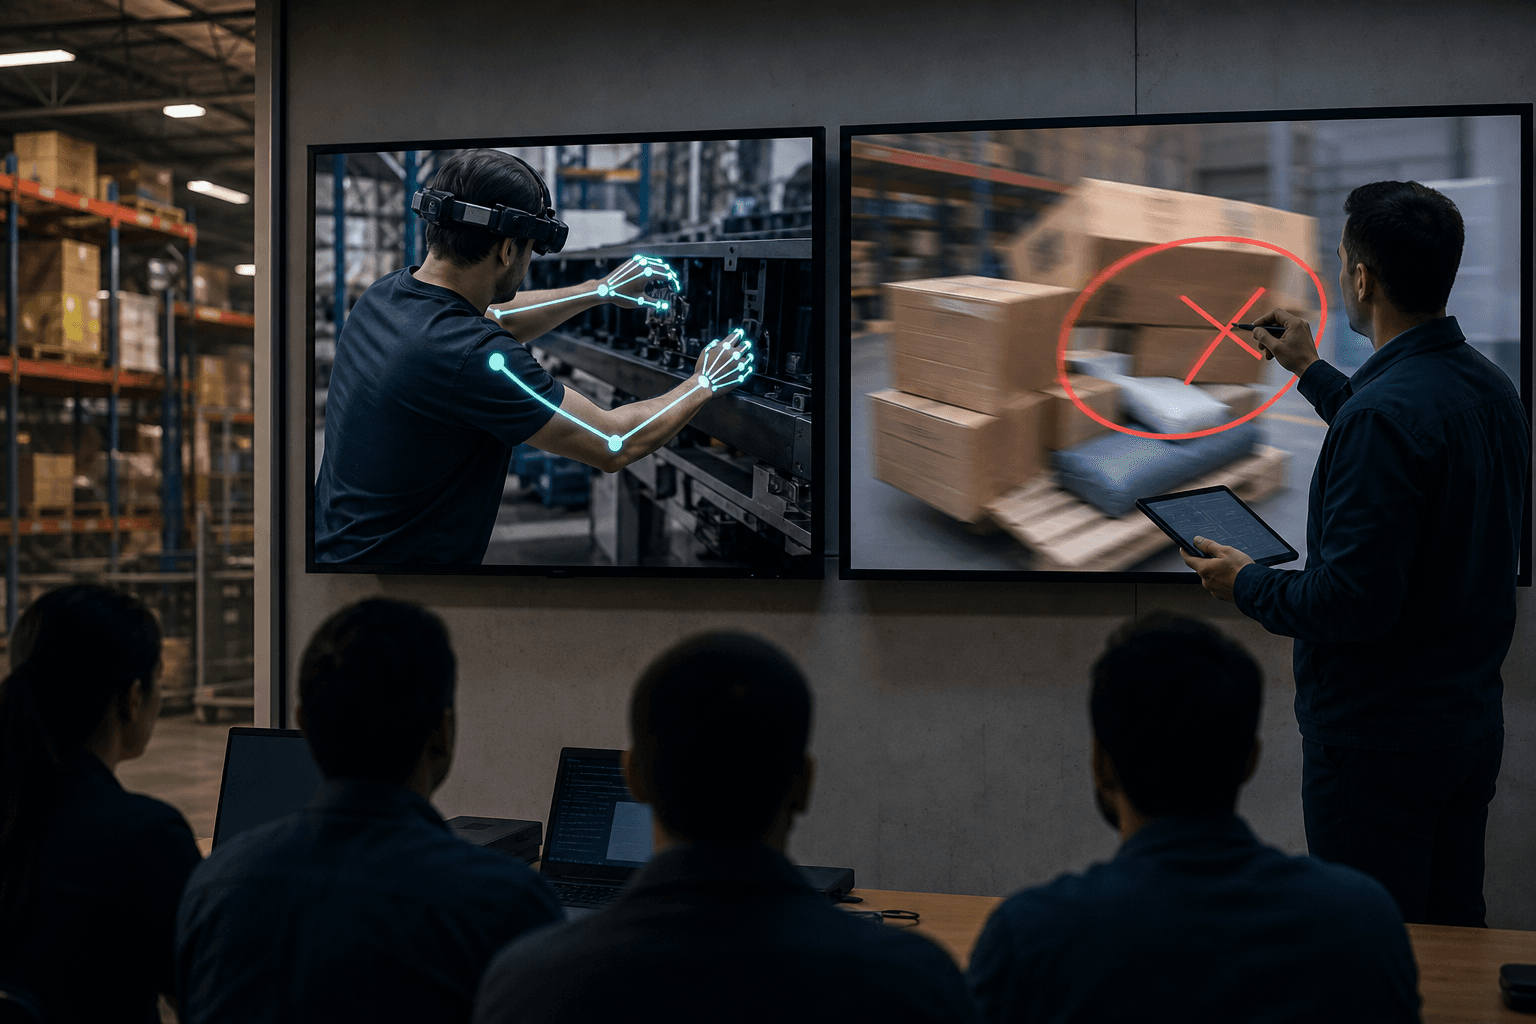
研究の概要
カーネギーメロン大学など複数機関の研究チームは、人間の一人称視点で撮影した動画を3万時間集めた大規模データセットを用い、世界モデルがどこまで賢くなるかを検証した。データは1000以上の場面類型、1万4000人の撮影者に及ぶ。世界モデルとは、現在の映像と行動から将来の映像を予測し、現実世界の振る舞いを模擬する人工知能である。物理シミュレーターに代わる手段として期待されている。
従来の評価は、下流タスクの成績という間接的な指標に頼ることが多かった。本研究は、学習に使わなかった難しい場面での「エージェント(人や手)の再現度」と「物体との相互作用の再現度」を直接測定した点に特徴がある。
結果は非対称であった。学習データを100倍に増やすと両方とも向上したが、エージェントの再現は良好な水準に達する一方、物体の再現度は低いままで改善も緩やかであった。
しくみをやさしく
世界モデルは、映像の続きを予測する訓練を通じて世界の規則を学ぶ。人間の動きは、どの動画にも写り、パターンが似ているため学びやすい。これに対し、物が倒れる、容器から中身が出る、布が変形するといった物体の挙動は、写る頻度が低く、しかも画面の大部分を占める背景や見た目の再現に学習の力が割かれてしまう。
研究チームはまず、視覚的な条件付けの設計を工夫すれば、エージェントの再現度は膨大なデータがなくても飽和することを示した。これにより、エージェントの影響を切り分けて物体の再現度だけを測定でき、物体側の飽和点も把握できた。
次に、場面の見た目の再現から物体の動きの再現へ、モデルの容量を振り向ける教師信号の与え方を提案した。これで物体の再現度は改善したが、実世界との差は依然として大きい。さらに、これらの結論は人型ロボットの動作モデル化にも当てはまると確認された。
ビジネスへの示唆
最大の含意は、動画データを大量に集めれば何でも解決するわけではないという点である。人の動作の把握と、物の状態変化の予測は別の難題と捉える必要がある。
具体的な業務で考えたい。物流倉庫の現場改善担当者が、作業者の動画から動線や手順を分析する場面では、人の動きの理解は有望である。一方、箱の積み崩れや柔らかい荷物の変形を予測して梱包手順を自動で決める用途は、現段階では精度に不安が残る。自部署で、人の動きの把握で足りる業務と、物の挙動の予測が不可欠な業務は何か。いま誰がどれだけの手間をかけているか。まずこれを区別することが出発点になる。
影響が見込まれる部門と指標は次のとおりである。
- 製造業の生産技術部門:作業標準書の作成工数、新人の習熟期間
- 物流・小売の現場改善部門:ピッキング動線の改善、事故・ヒヤリハット件数
- ロボット開発部門:実機試験の回数、シミュレーション構築の工数
- 人事・教育部門:技能伝承の研修時間、教育の均質性
現場での導入イメージ
仮に導入支援に入るなら、次の流れで進める。
-
棚卸し:動画を撮れる業務を洗い出し、人の動作の分析が中心の業務と、物の状態変化の予測が必要な業務に分類する。目指す到達点は、世界モデルに任せてよい領域と、人が判断すべき領域の線引きが共有された状態である。
-
差し込み先の設計:新しい大型システムを導入せず、既存の作業手順書、教育動画、品質記録の仕組みに、動作の自動記述や比較の機能を載せる。目指す到達点は、現場が使い慣れた道具の延長で成果を確認できる状態である。
-
小さく試す:一つの工程、一つの部署で数週間、ヘルメットやスマートグラスなどで撮影した動画を使い、担当者が結果の妥当性を実感で評価する。物体の挙動に関わる出力は参考扱いにとどめる。目指す到達点は、効果と限界の双方を担当者が自分の言葉で説明できる状態である。
-
運用と横展開:精度の確認基準と、人が最終確認する場面のルールを整備し、他の拠点や部署へ広げる。目指す到達点は、モデルの得意不得意を前提にした運用が定着した状態である。
全体として目指すのは、人の動作理解を生かして教育や標準化の手間を減らしつつ、物体の挙動は過信しない、現実的な活用体制である。
今後の展望
本研究は、物体の再現度を高めるには学習データの量だけでなく、何を学ばせるかという学習設計が重要であると示した。教師信号の工夫で改善が見られたものの、実世界との差は大きく、実用水準に達するには時間を要する見通しである。企業は、世界モデルを万能の予測装置としてではなく、得意分野が明確な道具として位置づけ、導入範囲を見極めることが求められる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AIが能力を隠せると証明、評価の限界露呈
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

ReLU網が描ける形状の規模を数学が証明
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

概念を隠して画像AIの判断根拠を探る新手法
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
