AI×製造
画像AI、1ブロック反復で精度維持し軽量化
単一のTransformerブロックを繰り返し使う画像認識モデル「reViT」が、全層モデルと同等の精度を保ちつつ保存パラメータを約70%減らした。端末搭載や配布のコストを下げる道を開く成果である。
全セクション横断 5 件
単一のTransformerブロックを繰り返し使う画像認識モデル「reViT」が、全層モデルと同等の精度を保ちつつ保存パラメータを約70%減らした。端末搭載や配布のコストを下げる道を開く成果である。
インド工科大学らの研究チームがビジョントランスフォーマーの学習過程における表現幾何学を体系的に解析するフレームワーク「TGO-II」を発表した。AIモデルのブラックボックス問題に切り込み、開発コスト削減と信頼性向上に寄与する可能性がある。
ViTベースの動画モデルに追加学習なしで組み込める表情認識フレームワーク「MiRA」が発表された。小売・金融・医療など感情データを業績指標に連動させる企業に直接影響を与える技術革新である。
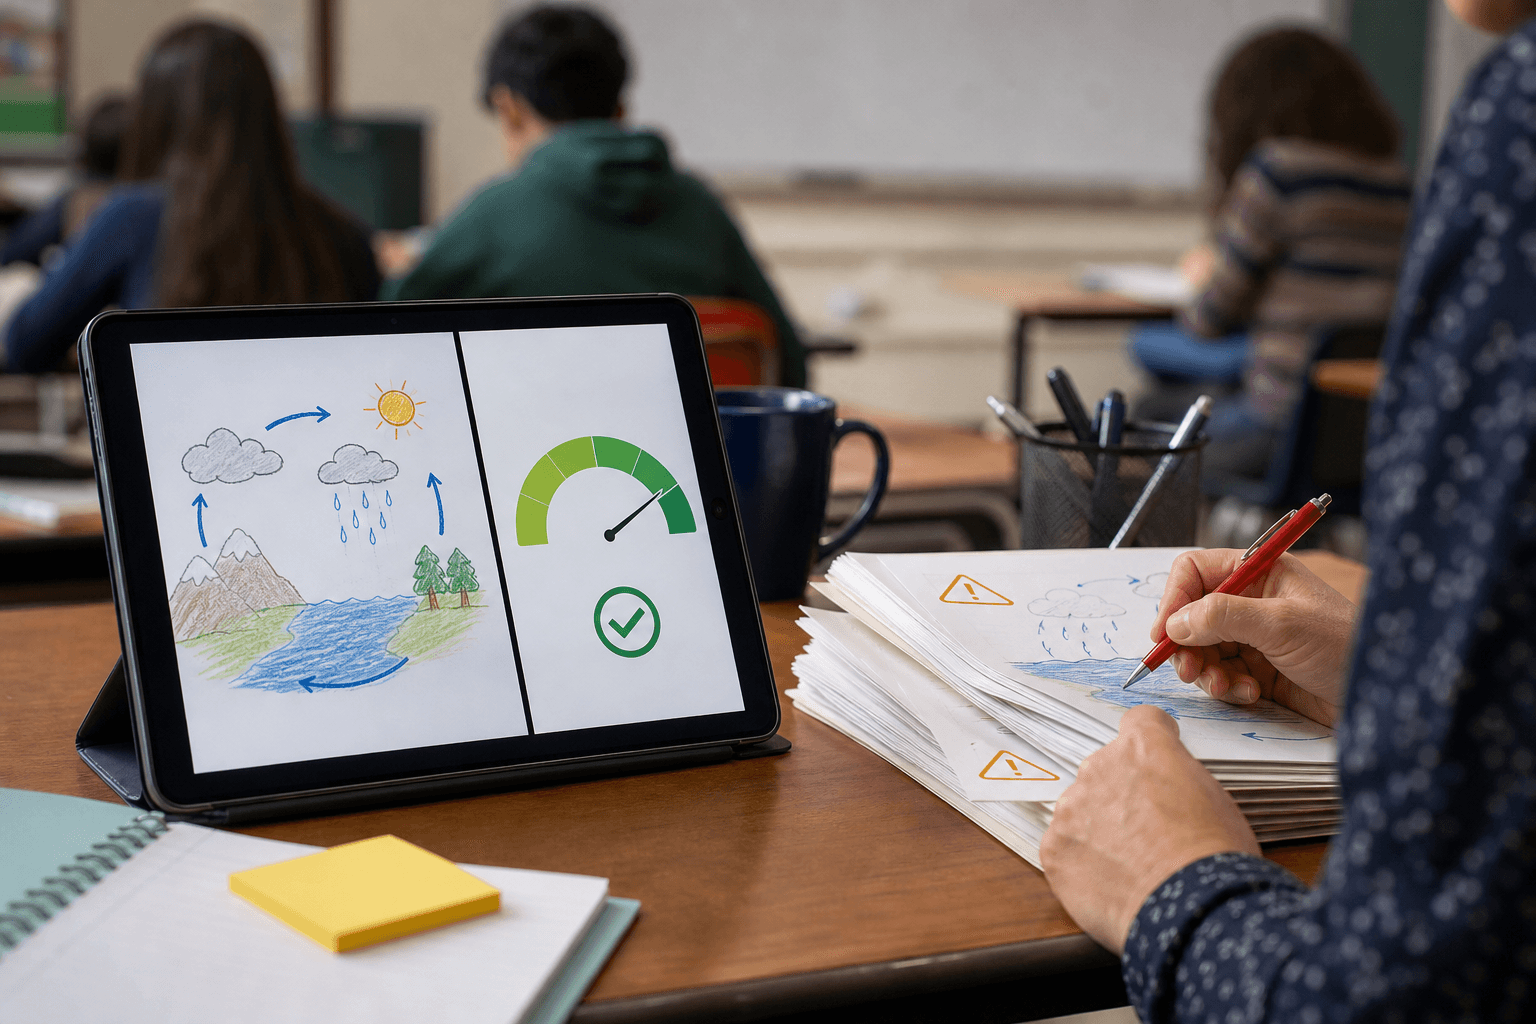
米研究チームが、生徒の手描き科学モデル図を自動採点するAIシステムを開発した。採点の信頼度を定量化し、不確実な答案のみ人間が審査する仕組みにより、教育現場の採点コスト削減と品質維持の両立が可能になる。
視覚AIモデルの「思考過程」を数学的に可視化する分析フレームワーク「TGO」が発表された。ブラックボックス批判を受けてきた深層学習の説明可能性向上に向け、製造・医療・金融業界のAI導入加速が期待される。