AI×マーケティング
動画生成AI、遅延を約11分の1に短縮
研究チームが、動画生成AIの内部表現を圧縮しつつ品質を保つ手法GRACEを発表した。トークン数を8分の1、遅延を11.1分の1に減らし、動画制作の計算コストを下げる道を開く。
全セクション横断 11 件
研究チームが、動画生成AIの内部表現を圧縮しつつ品質を保つ手法GRACEを発表した。トークン数を8分の1、遅延を11.1分の1に減らし、動画制作の計算コストを下げる道を開く。
米研究チームは、3D形状を重なり合う断面の潜在表現で捉える生成手法SILSAを発表した。トークン数を大幅に減らし、推論時間を58.5%短縮する。3D資産制作のコスト構造を変え得る成果である。
LLMエージェントの実行中にトークン消費量を予測する手法TokenCastが提案された。追加のLLM呼び出しなしで予測を更新し、予算制御でトークンを21.3%削減。運用コストの管理手段として注目される。
推論モデルに自らの回答の確信度を予測させる自己教師あり微調整で、精度を保ったまま生成トークンが最大25%減ることが判明した。停止の学習を伴わず推論コストを下げる手法として注目される。
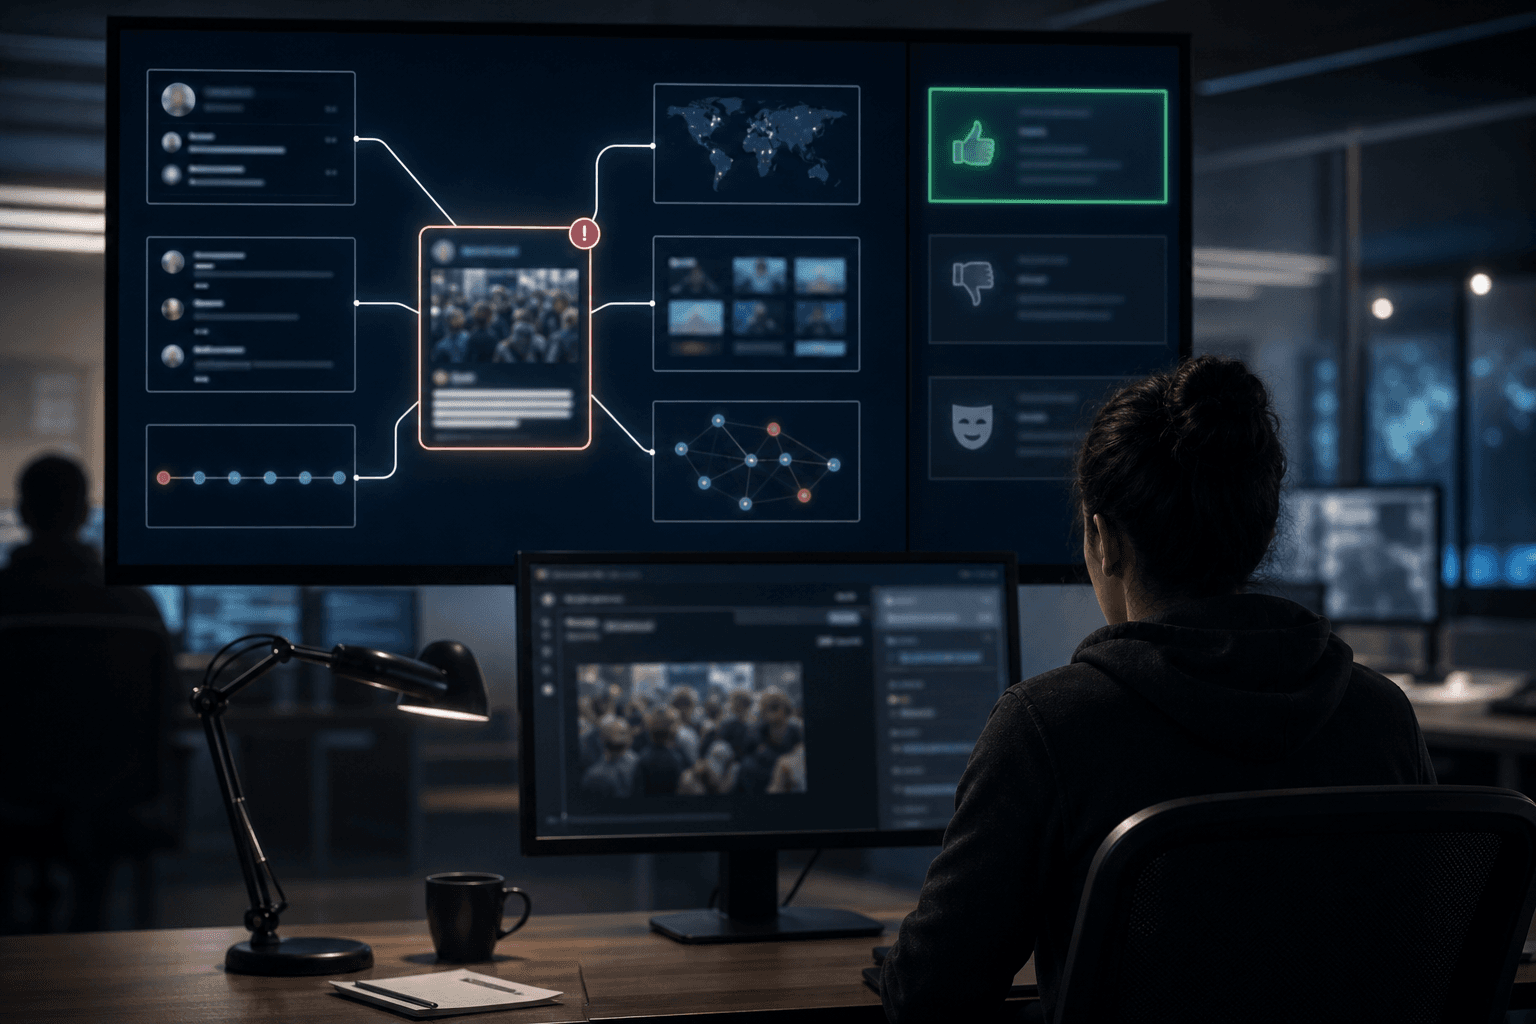
ヘブライ語ツイートを用いた研究チームが、社会的文脈をツールで調べながら陰謀論的投稿の意図を判定するエージェント型AIを提案した。文面のみの分類を上回り、SNS運営や広告業界の監視業務の効率化につながる可能性がある。
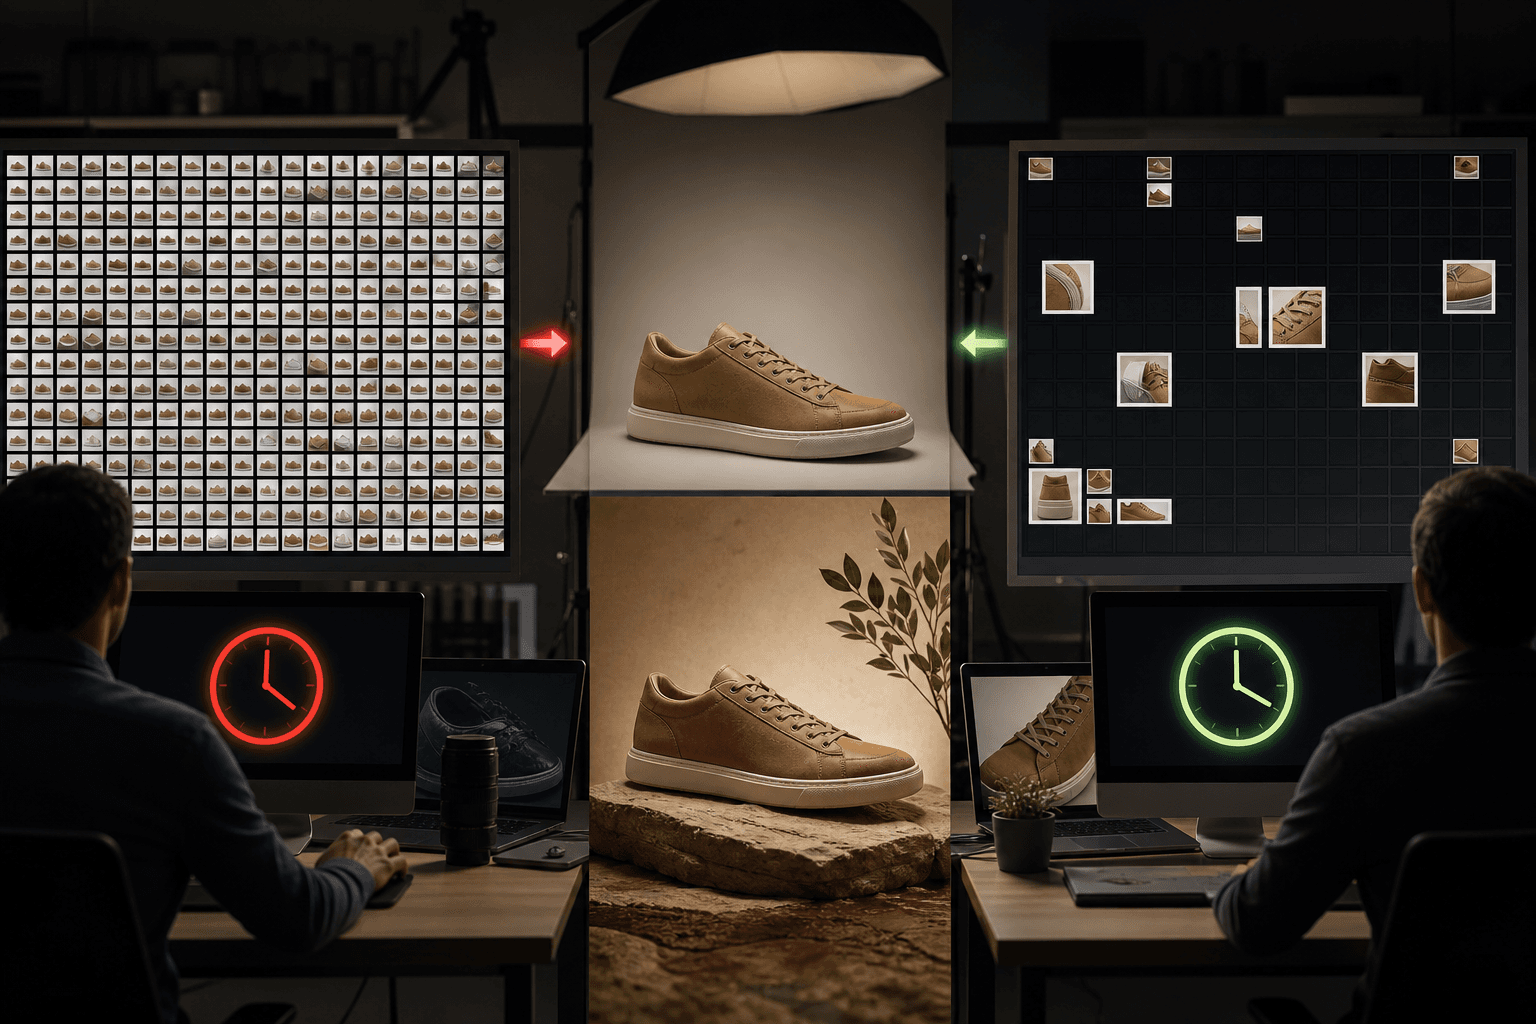
インド科学院などの研究チームが、参照画像を用いた拡散モデルの推論速度を最大4倍に高める手法「Sparse Context」を発表した。商用画像生成サービスのコスト構造を根本から変える可能性がある。
大規模言語モデルの推論処理を「トークン操作」として体系化した新技術アーキテクチャが発表された。サービス運用コストの抑制と安定供給を同時に実現する実用的な指針として、AI活用を本格拡大する企業の事業戦略に直結する内容である。
米研究チームが自己回帰型画像生成モデルの推論速度を最大13.3倍に高速化する技術「空間投機的デコーディング(SSD)」を発表した。リアルタイム生成の実用化により、広告・ゲーム・医療など多分野の業務効率とコスト構造が大きく変わる可能性がある。
スタンフォード大学がSEC提出書類1850万件をLLM学習用データセットに再構築した。金融機関や監査法人が財務分析・コンプライアンス業務に活用できるAI開発基盤として注目される。
浙江大学などの研究チームが、LLMエージェントの長期セッションにおける文脈管理を最適化する「TokenPilot」を発表した。推論コストを最大87%削減しつつ性能を維持し、企業のAI運用コスト構造を根本から変える可能性がある。
米研究チームが開発した「再帰型エージェントハーネス」が、AIの長文脈推論精度を従来比10ポイント近く向上させた。大量文書を扱う金融・法務・製造業の業務自動化に直結する成果として注目される。