画像AIの転用で動画学習を大幅効率化
画像用ViTを転用し、ラベルなし動画から特徴を学ぶ手法VideoMSNが登場した。事前学習の回数を最大160分の1に抑えつつ主要ベンチマークで最高性能を達成し、動画AIの開発コストを下げる可能性がある。
研究の概要
Owais Iqbal氏らの研究チームは、ラベルのない動画から時空間の特徴を学ぶ自己教師あり学習の枠組み「VideoMSN」を発表した。この手法は、重い3次元アーキテクチャーや画像を再構成するオートエンコーダーに依存せず、標準的な画像用Vision Transformer(ViT)をそのまま活用する点が特徴である。
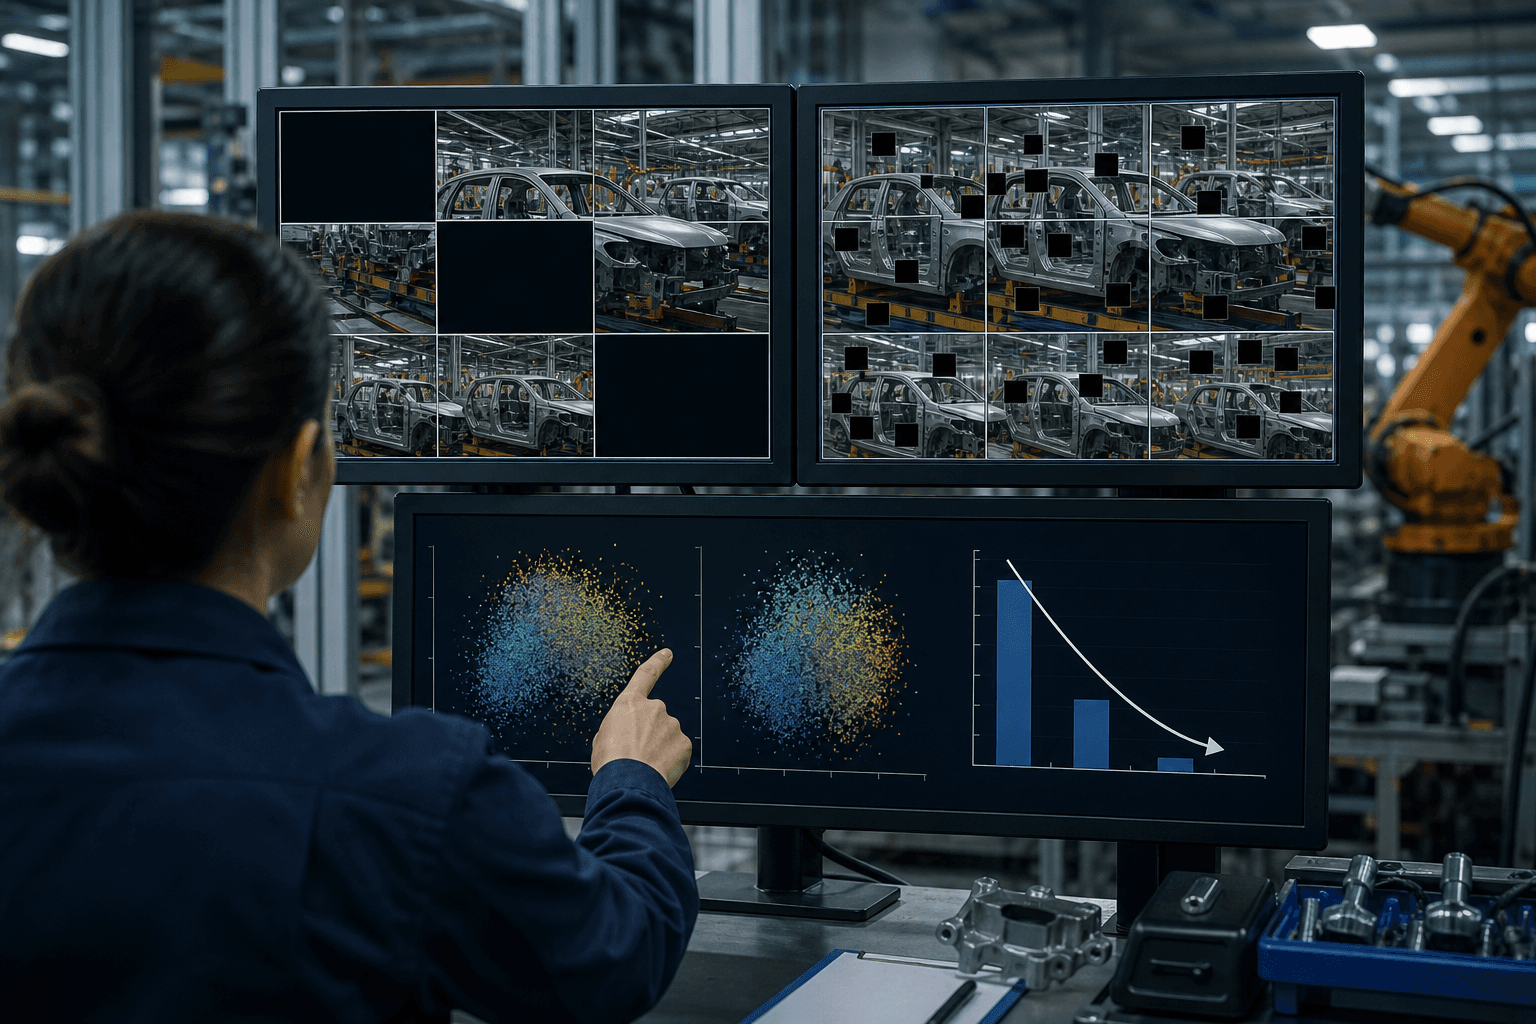
VideoMSNの核となるのは、動画から抽出した複数のフレームを格子状に並べて1枚の画像として扱う「スーパー画像」である。このスーパー画像から2種類の見方を生成する。一方は空間方向のパッチを隠し、他方は時間方向のフレームを隠す。両者は共通のViTエンコーダーに通され、埋め込み表現が一致するようにMasked Siamese損失で学習される。この設計により、フレーム間で情報が漏れず、動きと見た目の両方の手がかりを再構成なしで獲得できる。
デコーダーを持たない構成で、既存の画像基盤モデルであるDINO-v3とDeiT-v3を出発点とする。この結果、行動認識の代表的指標であるKinetics-400、UCF101、HMDB51で最高水準の性能を達成した。従来の動画自己教師あり学習と比較して、動画での事前学習エポック数は最大32分の1から160分の1で済むことが示されており、ラベルが乏しい低ショット分類でも高い性能を示している。
しくみをやさしく
VideoMSNの仕組みは、動画のフレームを一つの画像として扱うことにより、時空間の特徴を効率的に学習するものである。具体的には、動画の複数のフレームを一つの「スーパー画像」に統合し、異なる視点から情報を隠すことで、モデルがその情報を学習する。これにより、従来の方法に比べて計算資源を大幅に削減しつつ、高い精度を維持することが可能となる。
ビジネスへの示唆
VideoMSNの導入により、動画AIの学習にかかる計算資源と時間を大幅に削減できる可能性がある。特に影響が見込まれる領域は以下の通りである。
- 製造業の品質管理・設備保全部門: ラインの映像から作業の異常や不良の兆候を検知する際、正解ラベルの付与工数を減らすことができる。自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを見直すことが重要である。KPIとしては、検査の見逃し率、ラベリング費用、モデル立ち上げ期間が考えられる。
- 小売・物流の現場運営部門: 店舗や倉庫のカメラ映像から、顧客動線や作業手順の逸脱を把握することが可能となる。自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを確認し、作業時間、棚前滞留の分析精度、事故件数をKPIとして設定することが求められる。
- 医療・介護: 歩行や動作の映像から転倒リスクを評価する用途が考えられる。専門家によるラベル付けが高コストな領域において、低ショットでの性能が特に効果を発揮する。
- メディア・マーケティング部門: 動画コンテンツの分類やタグ付け、推薦に利用し、運用工数と検索精度を改善できる。自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを見直し、効果的なKPIを設定することが重要である。
既存の画像モデルの資産を活用できる点も大きな利点である。画像用ViTを運用している企業は、モデル構造を大きく変えずに動画対応へ拡張できる可能性がある。新規に専用の3次元モデルを導入する場合に比べ、推論基盤や開発体制の見直しが少なくて済み、導入までの期間短縮が期待される。
現場での導入イメージ
仮に導入支援に入るなら、以下の4つのステップを踏むことが考えられる。
-
棚卸し: 現在の動画データの蓄積状況や活用方法を確認する。このステップの目指す到達点は、自社の未ラベル動画の量や質を把握し、どの業務に適用可能かを明確にすることである。
-
差し込み先の設計: 既存のツールや業務プロセスにVideoMSNをどのように組み込むかを設計する。このステップの目指す到達点は、新たなツールを増やさずに、既存のシステムとの統合を実現することである。
-
小さく試す(PoC): 限定的な範囲でPoC(概念実証)を実施し、効果を測定する。このステップの目指す到達点は、実際の業務における効果を確認し、必要な調整を行うことである。
-
運用と横展開: 成功したPoCを基に、全社的に運用を開始し、他部門への展開を図る。このステップの目指す到達点は、全社的な導入を通じて、動画AIの活用を最大化することである。
全体の目指す到達点は、企業全体での動画AIの導入を通じて、業務の効率化とコスト削減を実現することである。
今後の展望
留意すべき点も存在する。評価は公開ベンチマークでの行動認識が中心であり、工場や店舗といった実環境の映像、長時間の動画、固定カメラ特有の偏りへの適合は、個別の検証が必要である。また、スーパー画像は抽出できるフレーム数に限りがあり、長い工程の把握には工夫を要する可能性がある。基盤となるDINO-v3などのライセンス条件は、商用利用の前に確認すべきである。
一方で、画像基盤モデルを動画へ低コストで広げる方向性は、今後の競争軸となると考えられる。企業にとっては、まず自社の未ラベル動画の蓄積状況を点検し、少量のラベルで効果を測る小規模な検証から着手することが現実的である。ラベリング費用と立ち上げ期間の削減幅を指標とした費用対効果の把握が、本格導入の判断材料となる。プロジェクトページも公開されており、実装の入手可否が普及の速度を左右する要因となると考えられる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボット方策、物理時間を明示し遅延に強く
Chronos Policyは、観測の取得時刻と行動の実行時刻をロボット方策に明示的に与える手法である。センサーや推論の遅延が揺れる現場でも、動作の安定性を保てる可能性を示した。

スマホ撮影だけでロボを現場適応させる技術
スマートフォンによる室内スキャンだけで、汎用ロボット制御AIを個別の現場に適応させる手法が登場した。実機での把持成功率は63.9%に達し、現場ごとの実演収集コストを抑える道を開く。

物理を備えた3D資産をAIが自動生成
オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。
