SNAP、軽量デコーダーで3D理解力を向上
新規視点合成を用いた自己教師あり手法SNAPが、デコーダーの表現力を抑える設計で幾何学的特徴を獲得した。少ない計算資源で教師あり手法に迫り、ロボットや測位分野の導入コストを下げる可能性がある。
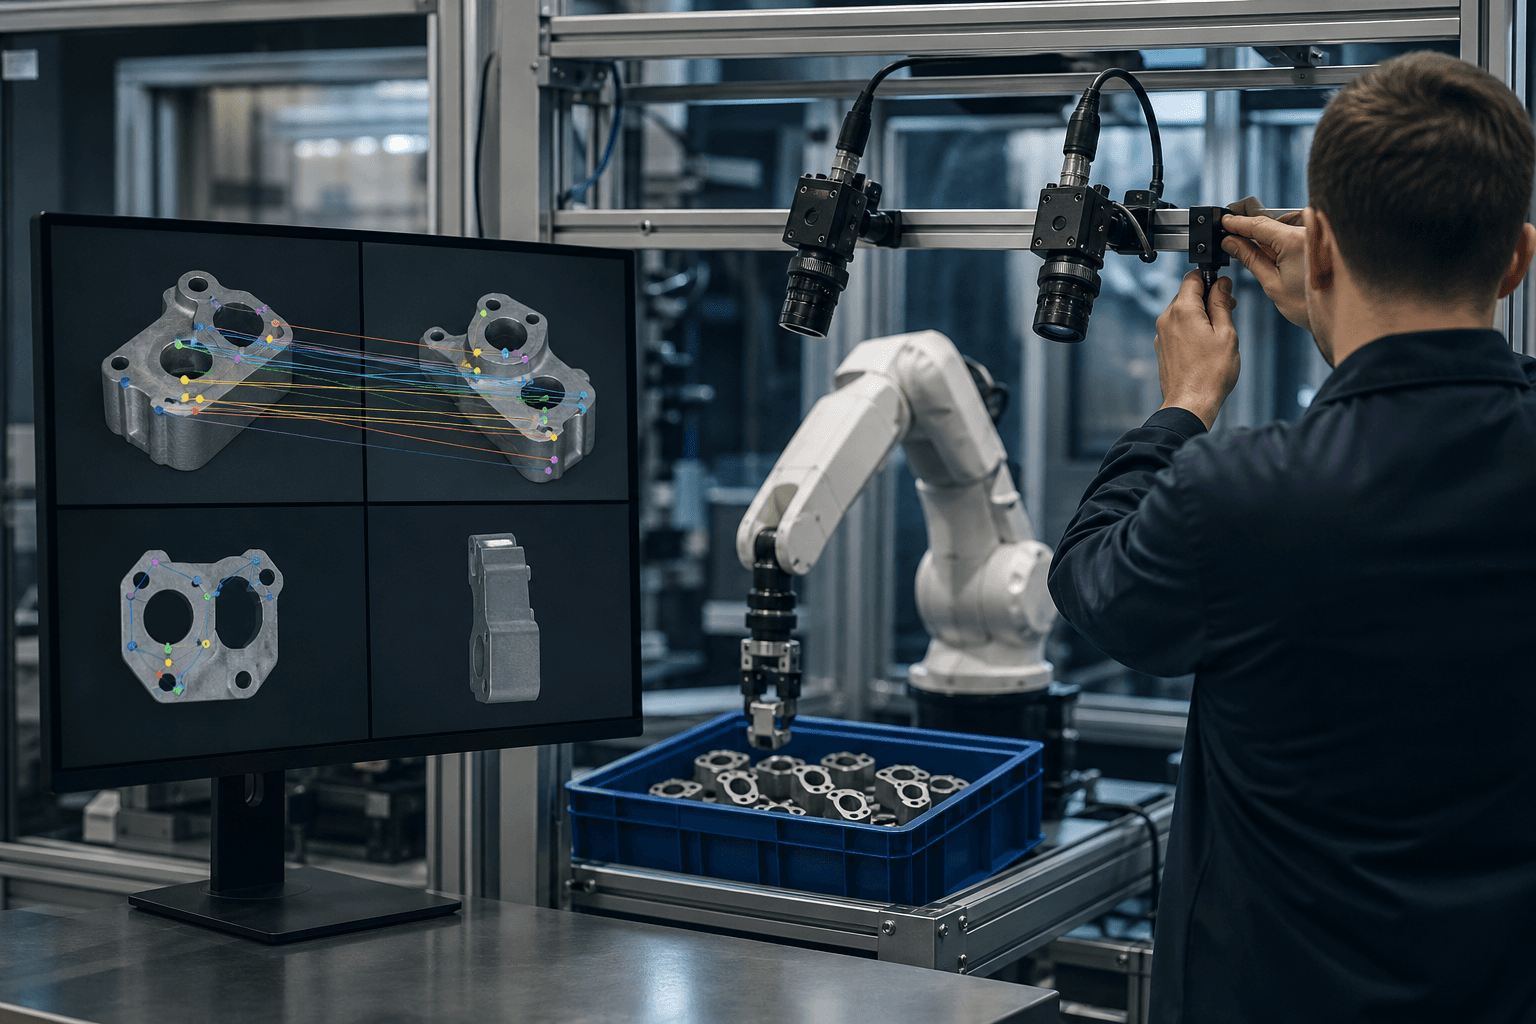
研究の概要
Keerthi Kaashyap氏、Animesh Garg氏らの研究チームは、新規視点合成(NVS: Novel View Synthesis)を基盤とする自己教師あり画像表現学習手法「SNAP」を提案した。NVSは複数の撮影画像から別の視点の画像を生成する技術であり、理論的には場面の3次元構造を推論する必要があるため、幾何学的に転用可能な表現が得られることが期待されてきた。しかし従来のエンコーダー型NVS手法では得られる表現の質が十分でなかったという課題があった。
研究チームは表現質が低かった原因を教師信号の不足ではなく設計上の二つの選択に求めた。一点目はデコーダーの空間的表現力が高すぎると、場面の幾何学的情報を本来担うべきエンコーダーがその役割を奪われ、意味のある中間表現を学べなくなる点である。二点目は、画素レベルの低次元な再構成目標が特徴学習を妨げる点である。
SNAPはこれらに対処するため、エンコーダー・デコーダー型のトランスフォーマー構造を採用する。具体的にはカメラ姿勢を条件とする局所的なデコーダーによりデコーダー側の表現力を意図的に制限し、学習目標を画素単位ではなく潜在空間での再構成に置き換えた。これによりエンコーダーに幾何学的特徴を保持させやすくしている。
評価は視覚的自己位置推定、姿勢推定、点の対応付け、深度推定、ロボット操作の5課題で実施された。結果としてSNAPは幾何学的教師データを用いる専用手法と競合し得る性能を示し、他の自己教師あり表現とも同等のパフォーマンスを達成した。特徴には視点変化に対する不変性が自然に現れ、計算量とデータ量が少ない条件でも教師付きモデルに迫る結果となった。特にカメラ位置がずれた条件下では標準的な2D表現が性能を大きく落とす一方、SNAPの性能劣化は緩やかであった。
しくみをやさしく
SNAPの肝は「デコーダーを抑えることでエンコーダーに役割を残す」ことにある。従来は強力なデコーダーがあれば画素再構成が簡単になるため、エンコーダーは細かな幾何学的情報を学ぶ必要が薄れてしまう。SNAPでは局所的で姿勢条件付きのデコーダーにすることで、再構成に必要最小限の情報しかデコーダーが扱えないように設計されている。
また学習目標を画素の直接比較から潜在空間での再構成に変えた点も重要である。画素同士の単純な一致を目標にすると色や照明の差に引きずられるが、潜在空間での再構成はより抽象的な幾何学的特徴を残しやすい。その結果、視点が変わっても有用な位置・姿勢・深度情報を含んだ表現がエンコーダーに蓄えられるようになる。
技術的にはトランスフォーマーの注意機構を利用して複数視点の情報を統合し、カメラ姿勢を条件として局所的に再合成する。計算資源やデータが限られた環境でも有効に機能する設計になっているため、実運用に近い設定での汎用性が期待される。
ビジネスへの示唆
最も直接的な意義は、高価な3D注釈データや深度・姿勢ラベルに依存せずに幾何学的理解を獲得できることである。産業現場では深度・姿勢データの正解ラベル付けがコスト高となるため、自己教師ありで近似できればデータ整備費用の圧縮効果が見込まれる。
自分ごとに落とし込むため、まず想定する適用先業務を一つ挙げる。例として「製造ラインのロボット把持・位置合わせ業務」を想定する。現状、現場ではカメラの取り付け位置や光学軸の微小ずれ、装置の物理的な経年変化により再キャリブレーションが頻発し、把持失敗やライン停止の原因になっている。
読者は次の問いを自部署へ投げかけるべきである。自部署で該当する業務は何か。特にカメラ依存で再調整が必要になる工程はどれか。いま誰がどれだけ手をかけているか(人時・回数)を把握しているか。これらを明確にすることでSNAPの効果を定量評価しやすくなる。
測るべきKPIは業務性質に直結させることが重要である。前述の製造ラインであれば「把持成功率」「再キャリブレーションに要する工数」「ライン停止時間」などが直接的な指標となる。倉庫の巡回ロボットであれば「測位誤差」「巡回あたりの運用コスト」、点検業務であれば「写真からの出来高判定精度」「点検工数の削減量」が適切なKPIとなる。
さらにSNAPの示す利点は特定タスクに依存しない汎用表現である点にある。部署横断で一つの事前学習済みモデルを共有できれば、部門ごとの個別モデル構築コストと学習に要する計算資源・データ費用の双方を抑えられる可能性がある。導入は小さく、安く始められる段階から段階的に拡大することが現実的である。
現場での導入イメージ
仮に導入支援に入るなら、以下の4段階で進めることを提案する。
-
棚卸し 実施内容: まず現状のカメラ配置、撮影頻度、既存の再キャリブレーション手順、対象業務を詳細に記録する。どの工程で視点変化が頻発するか、誰がどれだけ手作業で補正しているかを定量化する。 目指す到達点: 再キャリブレーションの頻度と所要工数、把持失敗やライン停止の発生源となるカメラ依存工程が特定され、適用候補となる現場が確定する。
-
差し込み先の設計(既存ツールとの整合) 実施内容: SNAPで得た表現をどこに組み込むかを設計する。既存の画像処理パイプラインやロボット制御系、あるいはRAG(Retrieval-Augmented Generation)的な検索コンポーネントの前段として差し込む現実解を検討し、新たなツール導入を最小限に抑える。 目指す到達点: 再学習やシステム改修を大幅に伴わずにSNAP由来の表現を活用できる差し込みポイントが決まり、導入コストと運用負荷の概算が得られる。
-
小さく試す(PoC) 実施内容: 選定した工程で限定的なPoCを実施する。少量の既存運用データを用い、SNAPで学習した表現を用いた推定(測位・姿勢・深度・把持支援)を試験的に行い、KPIの変化を観測する。照明変化や実機の動作を想定したテストケースを用意する。 目指す到達点: 把持成功率や測位精度など主要KPIに対するSNAP適用の影響が数値として確認され、期待効果とリスクが実証される。
-
運用と横展開 実施内容: PoC結果を踏まえ、本番環境への段階的展開を行う。運用中のモニタリング指標と再学習やモデル更新の運用プロセスを整備し、他工程や他部署への横展開計画を立てる。運用負荷低減のための自動化ルール(例えば再キャリブレーションが必要と判定された際のアラートと手順)を導入する。 目指す到達点: 現場で安定的に幾何学的表現を活用でき、再キャリブレーション頻度や手動補正工数が低減され、横展開に向けた運用体制が確立する。
この一連の支援で目指す最終的な到達点は、「撮像条件やカメラ取り付けの変動に耐えうる汎用的な視覚表現を現場運用に組み込み、再学習や手作業による補正コストを継続的に減らすこと」である。
今後の展望
本研究はモデルの表現力をむやみに高めるのが常に最善ではないという設計指針を示した。デコーダーの表現力を意図的に制限することでエンコーダー側に有用な幾何学的構造が残り、それが下流タスクでの頑健性向上につながる可能性がある。この知見は他の自己教師あり学習設計にも応用される余地がある。
ただし現時点の評価は研究用ベンチマーク中心であり、実環境での照明変化、動く物体、長期運用での耐久性など未検証の点が残る。企業にとってはまずカメラ配置が変動しやすい工程で小規模実証を行い、既存手法と比較した再キャリブレーション頻度や精度劣化幅を評価することが現実的な第一歩である。プロジェクトページが公開されているため、実装の入手性次第で現場導入の速度が左右される点にも注意が必要である。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボット方策、物理時間を明示し遅延に強く
Chronos Policyは、観測の取得時刻と行動の実行時刻をロボット方策に明示的に与える手法である。センサーや推論の遅延が揺れる現場でも、動作の安定性を保てる可能性を示した。

スマホ撮影だけでロボを現場適応させる技術
スマートフォンによる室内スキャンだけで、汎用ロボット制御AIを個別の現場に適応させる手法が登場した。実機での把持成功率は63.9%に達し、現場ごとの実演収集コストを抑える道を開く。

物理を備えた3D資産をAIが自動生成
オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。
