ロボット、重み更新なしで成功率95%に自己改善
Yen-Jen Wang氏らは、モデルの重みを更新せず、シミュレーション上の練習でロボットの作業スキルを自律的に改善する枠組みRPGを発表した。22タスクの成功率は28.6%から95.0%に向上した。
研究の概要
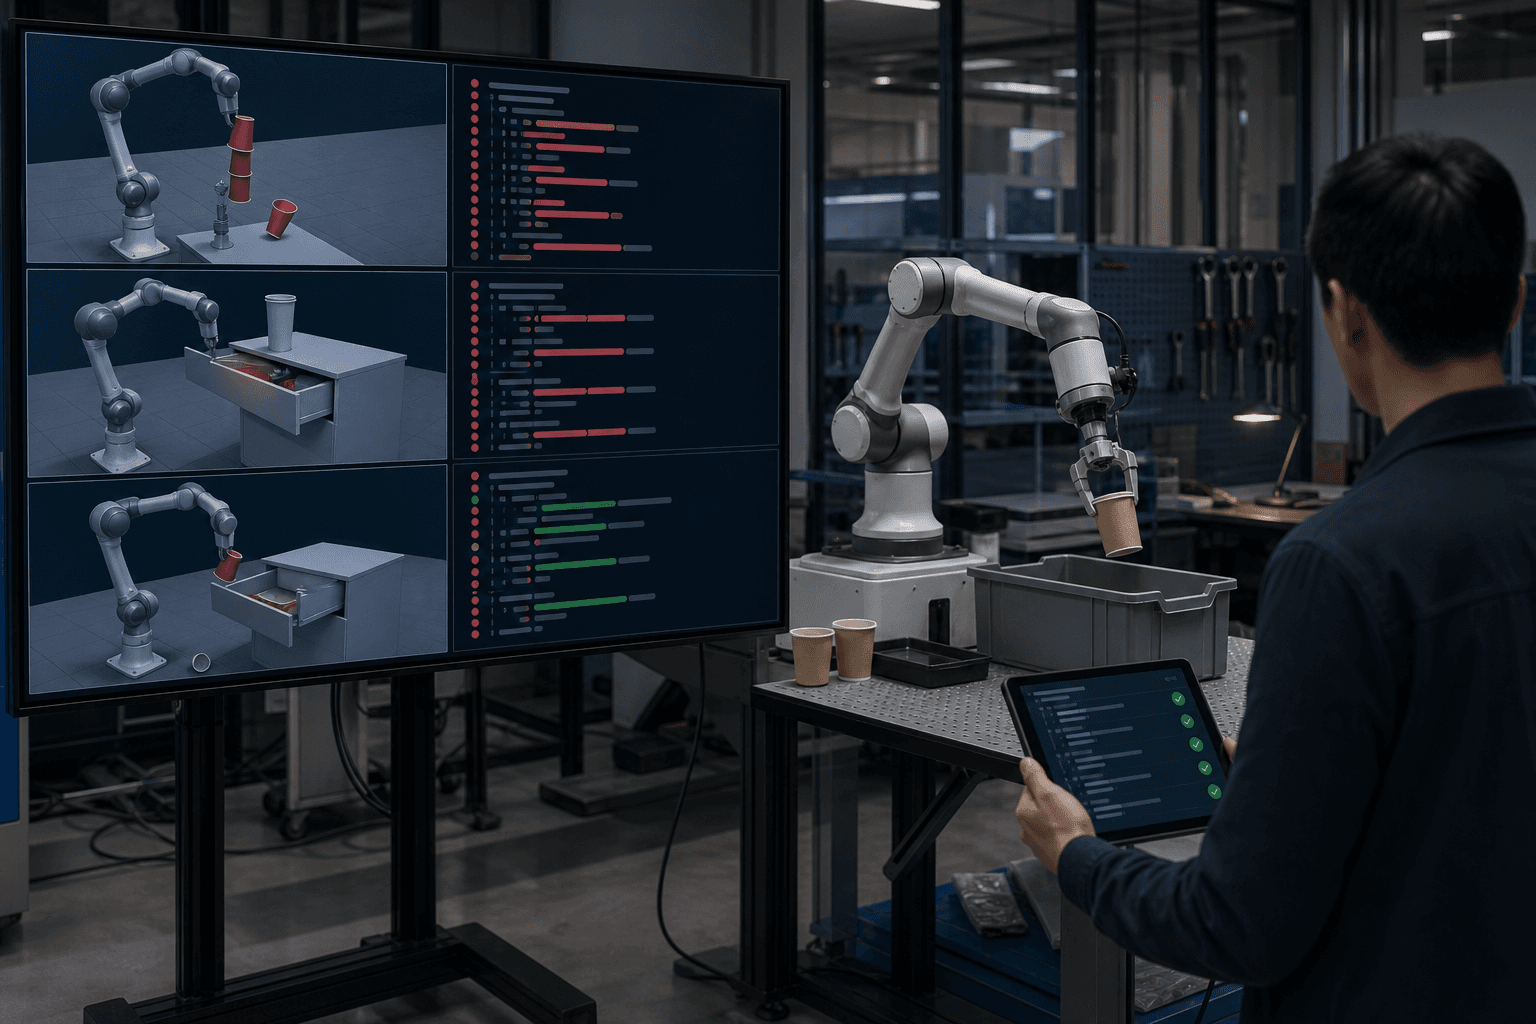
Yen-Jen Wang氏らは、ロボットの実行システムを人手を介さずに自律的に改善する枠組み「RPG(Reconstruct, Practice, Go Real)」をarXivで発表した。RPGは既存の操作データセットを起点に、ロボットが実行可能な操作の種類を抽出し、関連する練習課題をシミュレーション上に自動構築する仕組みである。練習中は、実行時のフィードバック、シミュレータが保持する内部状態、データセット中の動画を使って失敗の原因を診断し、そこから具体的な改良案を生成する点が特徴である。
診断に基づいて行われる改良は大きく三種である。再利用可能な記号的スキルの新規作成、既存スキルの改良、そしてシステムプロンプトの改訂である。改良案は単純に適用されるわけではなく、個別候補と統合後の改訂を複数タスクにまたがって評価し、有効であることが確認されたものだけを採用するという保守的な検証プロセスを採っている。実運用時にはマルチモーダルLLMがこのプロンプトとスキルライブラリを用いて知覚とロボット制御を統括する点も重要である。論文が強調するポイントは、モデルの重みは一切更新しないことであり、重みの凍結を前提とした改善を実現している。
評価結果は有望である。未知の初期配置での22の操作タスクに関する評価では、1回目の練習後の成功率が28.6%であったのに対し、15回の練習後には95.0%へ上昇した。比較対象手法では、ASPIREが75.5%、GPT-6 Astra Pro搭載のCaP-Agent0が60.0%にとどまり、RPGは評価したすべての基準手法を上回った。実機検証では、共通の校正とハードウェア適応を行ったうえで、凍結したシステムが3タスク各10回、計30回の試行をすべて成功させたことが報告されている。
しくみをやさしく
RPGの動きは大きく三段階で理解できる。まず既存の運用動画やログから「どんな動きができるか」を読み取り、シミュレーション上に練習シナリオを自動的に組み立てる。次に、その練習シナリオでロボットが失敗する原因を、実行時のフィードバックやシミュレータ内部の状態、参照動画を照らし合わせながら診断する。最後に診断に基づいて人が読み取り可能な形(記号的スキル、プロンプト改訂)で改善案を出し、複数タスクで試して有効性を確かめたうえで本番環境に反映するという流れである。
ここでの要点は二つある。一つは改善が「読める形」で残ること、すなわちスキル記述やプロンプトの改訂という形で成果が記録されるため、監査や差し戻しがしやすい点である。もう一つは重みを更新しないため大規模再学習に伴う計算資源や長期の検証コストが不要である点である。要するに、既存のデータを活用して短期間・低コストに改善のサイクルを回せるように設計されている。
ビジネスへの示唆
RPGの導入効果が最も期待できるのは製造業と物流業である。具体的な適用先としては、以下のような反復的で設定変更が頻発する業務が該当する。
- 組み立てラインの段取り替え業務(治具や品目が変わるたびに調整が発生する工程)
- 部品供給やフィーダー設定の初期調整作業
- 倉庫でのピッキングや配置作業など、物体の種類・配置が変化する作業
自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを問い直すことが出発点である。例えば生産技術部門がライン立ち上げごとに行っている教示作業があるなら、次のようなKPIを設定して検証することが現実的である。
- ライン立ち上げ・段取り替えに要するリードタイム(時間)
- ロボット教示とプログラミングにかかるエンジニア工数(人時)
- 新規品目投入時の初期不良率(件数/率)
これらのKPIはRPGの特性と直接結びつく。練習の大半をシミュレーションで済ませられれば、立ち上げリードタイムや教示工数の削減、初期不良率の低下が期待できる。また重み更新を行わない方式ゆえに、品質保証部門が変更内容を人手でレビューした上で本番反映する運用を組みやすい。結果として、ロボットを単なる購入物品から、運用データを溜めて価値を発揮する資産へと転換できる可能性がある。
既存の作業動画や操作ログをどれだけ整備しているかが、効果の度合いを左右する点も重要である。データが整理されている企業ほど練習課題生成の素材が豊富であり、改善サイクルを短く回しやすい。設備保全部門や品質保証部門、そして生産技術が連携してデータ整備とレビュー体制を構築することが導入成功の要件になる。
現場での導入イメージ
仮に導入支援に入るなら、以下の4段階のワークフローで進める。各ステップで「何をするか」と「目指す到達点」を明確にする。
- 棚卸し
- 何をするか: 現行のロボット運用に関するデータ(作業動画、操作ログ、教示記録)、対応が頻繁な工程・品目、関係部門の役割を洗い出す。ハードウェアの校正手順や既存のシミュレータ有無も確認する。
- 目指す到達点: 練習課題生成に使えるデータ資産の一覧と、優先適用候補となる業務(KPIで比較した上位数件)を確定する。導入の効果試算に必要な入力が揃う状態を目指す。
- 差し込み先の設計(既存ツール優先)
- 何をするか: 既存の運用フロー、VMSやPLCなどの制御系、現場で使っている教示ツールにどうRPG由来のスキル・プロンプトを組み込むか設計する。新ツールを増やさず、既存の監査・承認フローに沿う形で差し込む現実解を検討する。
- 目指す到達点: スキルライブラリとプロンプト改訂が既存の運用管理フローでレビュー・承認できる配置を決定し、品質保証部門のレビュー項目を定義することを目標とする。
- 小さく試す(PoC)
- 何をするか: 優先候補のうち1〜2工程に限定してシミュレーション練習を実施し、診断→改訂→再評価のサイクルを数回回す。実機に移す際は共通の校正とハードウェア適応を行い、凍結したシステムで数十回単位の試行を行う。
- 目指す到達点: シミュレーション上で成功率の改善が確認され、実機での再現性が得られること。PoCのKPIで有意な改善(リードタイム短縮や工数削減、初期不良率の低下)が確認できることを目標とする。
- 運用と横展開
- 何をするか: PoCの結果を踏まえてスキルライブラリとプロンプト改訂手順を標準化し、運用ルール(誰がレビューし誰が反映するか)を確立する。横展開の優先順位に従い他工程へ順次適用し、効果を定期的にモニタリングする。
- 目指す到達点: 改善サイクルが現場内で自律的に回り、データ蓄積により新たな練習課題を継続的に生成できる体制を作ること。最終的にはロボット運用が「買って終わり」ではなく、運用データで価値を増す資産になる状態を目指す。
この導入支援の総合的な目標は、短期間・低コストで運用改善を実現し、ライン立ち上げリードタイムや教示工数を削減しつつ、品質管理の整合性を保ったままロボットの自律改善サイクルを確立することである。現場のデータ整備が進んでいるほど効果が出やすく、小さく・安く始められる点が実務上の利点である。
今後の展望
留意点も明確である。22タスク全体の95.0%という高い成功率はシミュレーション上の結果であり、実機での検証は3タスク30回にとどまる。実機で同等の水準を出すためには、校正とハードウェア適応が前提であることを忘れてはならない。工場や倉庫の照明や物体の外観変動、現場ごとの物理的差異がどの程度シミュレータで再現できるかが、実際の適用範囲を左右する重要課題である。
それでもRPGは、人手で行ってきたスキル開発と保守の一部をシミュレーション上の自律的練習に置き換えられる可能性を示した点で意義が大きい。ロボットメーカーやインテグレーターは、現場調整を単発の人手仕事として提供する従来モデルを見直し、継続的な改善サービスへのビジネスモデル転換を検討する契機となるだろう。導入を検討する企業は、自社データの整備状況とシミュレーション環境の構築体制を早期に点検しておく必要がある。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボット方策、物理時間を明示し遅延に強く
Chronos Policyは、観測の取得時刻と行動の実行時刻をロボット方策に明示的に与える手法である。センサーや推論の遅延が揺れる現場でも、動作の安定性を保てる可能性を示した。

スマホ撮影だけでロボを現場適応させる技術
スマートフォンによる室内スキャンだけで、汎用ロボット制御AIを個別の現場に適応させる手法が登場した。実機での把持成功率は63.9%に達し、現場ごとの実演収集コストを抑える道を開く。

物理を備えた3D資産をAIが自動生成
オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。
