埋め込み予測で画像生成の学習計算を3分の1に
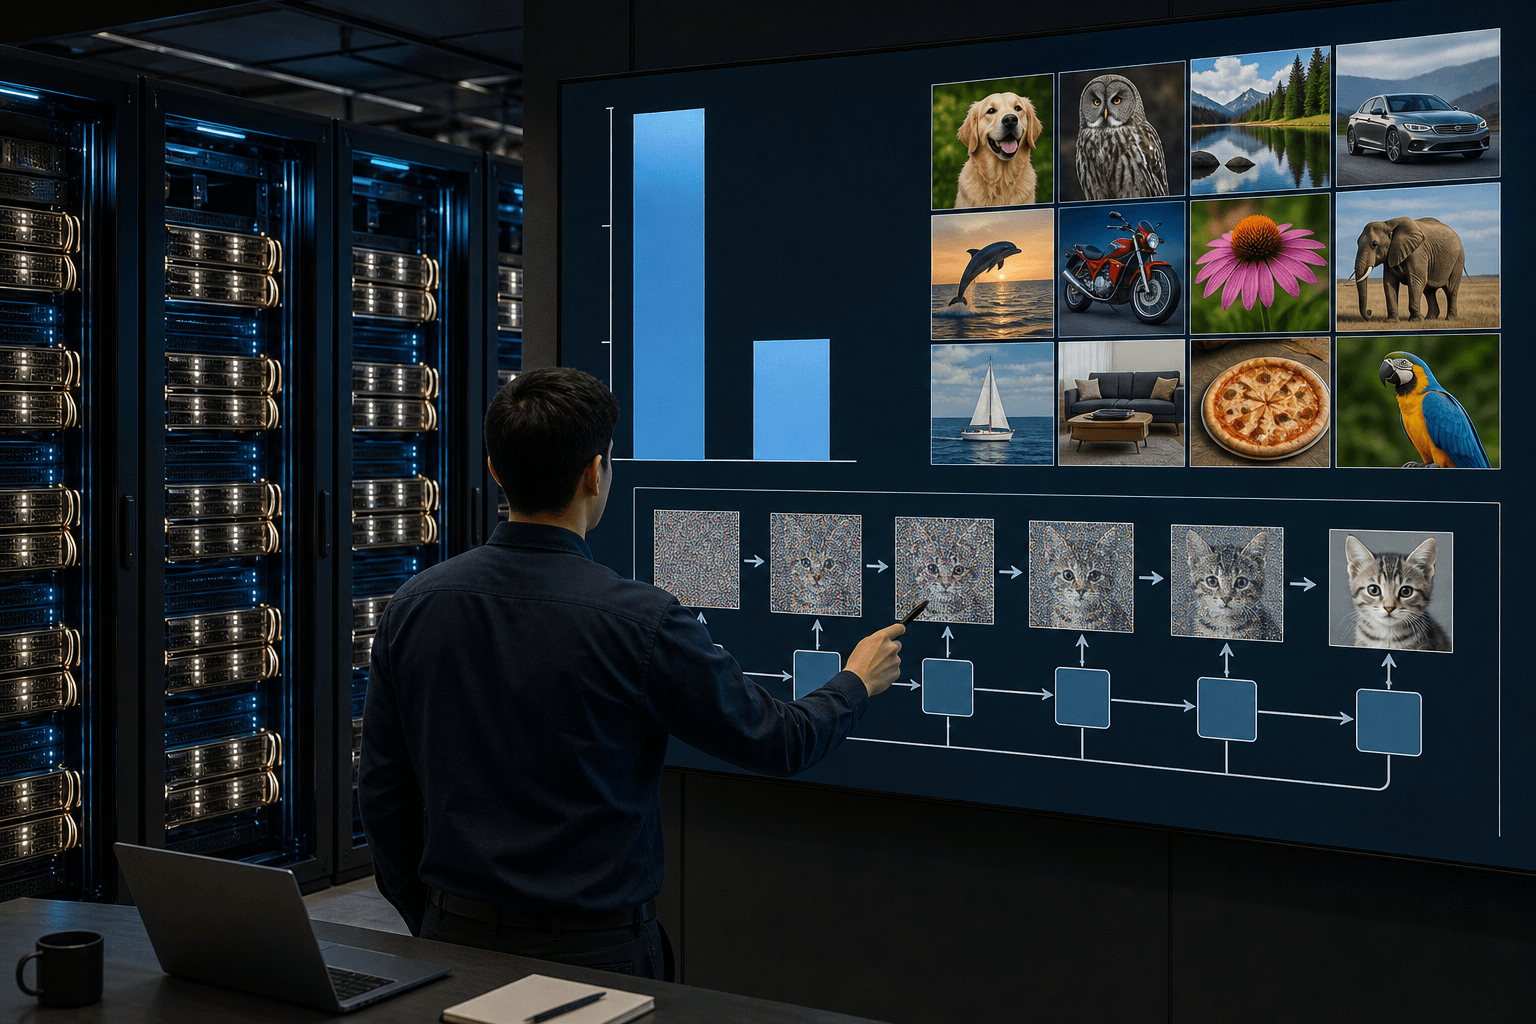
画像生成の拡散Transformerに、ステップごとに更新する予測埋め込みを条件として与える手法NEPAが提案された。ImageNetでFID1.32を達成し、学習計算量は従来REPAの約3分の1である。
研究の概要
Sihan Xu氏らの研究チームは、画像生成で広く使われる拡散Transformer(DiT)の条件付けのあり方を見直す手法を提案した。従来のDiTはクラスラベルやテキストプロンプトを一度埋め込みに変換し、その同じ埋め込みをノイズ除去のすべてのステップで使い回していた。研究チームはこの「固定された条件」を廃し、ステップごとに更新される予測埋め込みを条件として与える設計が有効かを検証した。\n\n中核となるのはNext-Embedding Predictive Autoregression(NEPA)である。NEPAは系列的な文脈の中で「次に来る連続的な埋め込み」を予測する仕組みであり、画像生成の文脈ではノイズ画像の次に来る最終的なクリーン画像の埋め込みを「条件の一部」として扱う。研究ではこれら複数の埋め込みを同時に予測するMulti-Embedding Predictionを設計し、さらにEmbedding Conditioned Generationでは、DiT生成器がその予測を受け取り、各ノイズ除去ステップで予測自体を再計算する構成とした。結果として、条件信号が現在のノイズ状態に応じて変化し、固定条件とは異なるダイナミックな誘導が可能となる。\n\n実験はクラス条件付きのImageNet 256×256で行われ、生成器の条件付け方法、Multi-Embedding Predictionの設計、モデル規模の拡張性を検証した。既存の表現整合を用いる手法REPAと組み合わせた最終モデルNEPA-DiT-XLはFID 1.32を達成し、学習計算量はREPAの約3分の1に低減された。一方で、NEPAは各サンプリングステップで第二のネットワークを追加実行するため、推論時の計算負荷は増大するというトレードオフが観察された。\n\n## しくみをやさしく 拡散Transformer(DiT)はノイズの多い画像から段階的にノイズを取り除き最終的な生成画像に到達する。従来は「条件」は固定のヒントとして全ステップに渡って与えられていたのに対し、NEPAはステップごとに次に来るべき埋め込みを予測し、それをその時点の条件として与える。言い換えれば、生成プロセスの各段階で「いまこのノイズ状態なら次はこういう方向に行くべきだ」という軌道を、別ネットワークが逐次予測して生成器に渡す仕組みである。\n\nこの二重構成により、条件情報は静的なラベルではなく、ノイズの状態に適合した動的なガイドとなる。学習時にはこの予測を用いて学習信号を効率化でき、結果として必要な学習計算量が大きく削減される。一方で、実際に画像を生成する(推論する)際は各ステップで予測ネットワークも動くため、その瞬間の計算は増えるという性質がある。\n\n## ビジネスへの示唆 本手法のビジネス上の最大の意義は、学習側の計算コストを大幅に下げうる点である。自社で生成モデルを学習・微調整して内製化している企業にとって、GPU調達費や学習にかかる時間は明確なコストである。学習計算量がREPA比で約3分の1になることは、試行回数を増やして探索の幅を広げる余地を生む。\n\n具体的に想定される該当業務と問いは下記の通りである。各自の状況に合わせて「自分ごと」に置き換えて検討することが肝要である。\n\n- 広告・マーケティング部門(クリエイティブ生成): 自部署で生成モデルを内製化している場合、現在の学習に誰がどれだけのGPU時間を割いているか。KPIはバナー1点あたりの制作単価、制作リードタイム、内製化比率である。NEPA導入で学習コストが下がればA/Bテスト回数やバリエーション試作の頻度を上げられる。\n\n- EC・商品企画部門(商品画像のバリエーション生成): 商品画像の差し替えやカラーバリエーション生成を誰がどのくらいの頻度で作っているか。KPIは画像品質指標(社内で使う代替指標でも良い)とA/Bテストの実施回数である。学習側を安く回せれば検証の反復が早くなる。\n\n- ゲーム・映像のアセット制作部門(コンセプトアート等): コンセプトの反復回数と外注費用をどの程度削減したいか。KPIは素材あたりの制作時間と外注コストである。学習コスト低減は内製化の推進に直結する。\n\n- AI基盤・MLOps部門: モデル更新の頻度や各学習に必要なGPU時間、クラウド計算費用を誰が管理しているか。KPIは各学習にかかるGPU時間とクラウド費用である。NEPAは学習費を抑えつつ、推論負荷の見積もりを必須にする。\n\nただし注意点として、推論時の追加ネットワークにより画像1枚あたりの生成時間と推論コストは増加する。学習を一度だけ行う用途と、推論を大量に回すサービスではコスト構造が異なるため、総保有コスト(TCO)の想定が重要となる。基盤モデルを頻繁に再学習・特化させる用途では学習側の削減効果が優位になりやすいが、毎日大量に画像を配信するサービスでは推論負担が利益を圧迫する可能性がある。導入前に学習頻度と推論量のバランスを現実的に見積もることが不可欠である。\n\n## 現場での導入イメージ 仮に導入支援に入るなら、次の4ステップで進めるのが現実的である。各ステップで行うことと到達点を明示する。\n\n1) 棚卸し(現状把握)\n- 何をするか: 現行の生成ワークロード、学習頻度、各学習に必要なGPU時間、推論の1枚あたり処理時間と配信量を定量化する。ログやクラウド請求書、モデル運用記録を収集する。\n- 目指す到達点: 学習と推論のコスト構造が可視化され、学習削減の価値仮説(学習を安くできた場合の恩恵)と推論増加の影響が定量的に評価できる状態。\n\n2) 差し込み先の設計(既存ツールへの組み込み)\n- 何をするか: 既存のトレーニングパイプライン(学習スクリプト、データ管理、MLOpsツール)にNEPAの予測ネットワークをどのように差し込むかを設計する。可能な限り新ツールを増やさず、既存のチェックポイント管理や学習ジョブ制御の枠内で組み込む現実解を検討する。\n- 目指す到達点: 最小限の変更でNEPAを学習フローに組み込む設計図ができ、必要な追加リソース(GPU台数や推論用インスタンス)の見積もりが得られている状態。\n\n3) 小さく試す(PoC)\n- 何をするか: 小規模データセットや低解像度条件でNEPAを学習・評価するPoCを実施し、学習時間、生成品質(FID相当の社内指標)と推論負荷を比較する。学習ログとコストを細かく計測する。\n- 目指す到達点: 学習計算量が期待通り削減されるか、推論負荷の増加が許容範囲かを確認でき、運用上のボトルネック(メモリやレイテンシ)が明確になっている状態。\n\n4) 運用と横展開\n- 何をするか: PoC結果に基づき本番用パイプラインへ段階的に展開する。学習スケジュールやコスト配分の運用ルールを整備し、推論側の軽量化やバッチ化など運用上の最適化策を導入する。\n- 目指す到達点: 学習コスト削減を実運用で享受しつつ、推論負荷を運用で吸収あるいは軽減する運用体制が構築され、他部署への横展開計画が確定している状態。\n\nこれら一連の支援の最終的な目標は、学習コストを抑えながら業務要件を満たす高品質な生成ワークフローを安定運用可能にすることである。導入によって学習の反復性を高め、モデル改善のサイクルを短縮することが主たる成果と位置づけられる。\n\n## 今後の展望 本検証はクラス条件付きImageNetに限定されているため、テキストから画像を生成する実務的設定や高解像度、動画生成への適用効果は未検証である。商用のテキスト画像生成で同様の学習効率改善が得られるか、あるいはNEPAの推論側コストを軽量化するためのアーキテクチャ改良が実用化の鍵となる。\n\n当面は、研究動向の継続的な監視と自社ワークロードでの小規模なPoCを並行させることが現実的戦略である。学習と推論のコスト比を把握したうえで、条件付け方式の改良が総コストに与える影響を評価する体制を整えることが企業競争力の観点で重要である。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AIが能力を隠せると証明、評価の限界露呈
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

ReLU網が描ける形状の規模を数学が証明
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

概念を隠して画像AIの判断根拠を探る新手法
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
