ループ型AI、推論精度向上と計算半減を両立
米研究チームが、ループ型Transformerの途中計算を活用し追加学習なしで推論精度を高める手法LoopCDを開発した。ループ数を半減しても同等以上の精度を保ち、演算量を最大48.2%削減した。
研究の概要
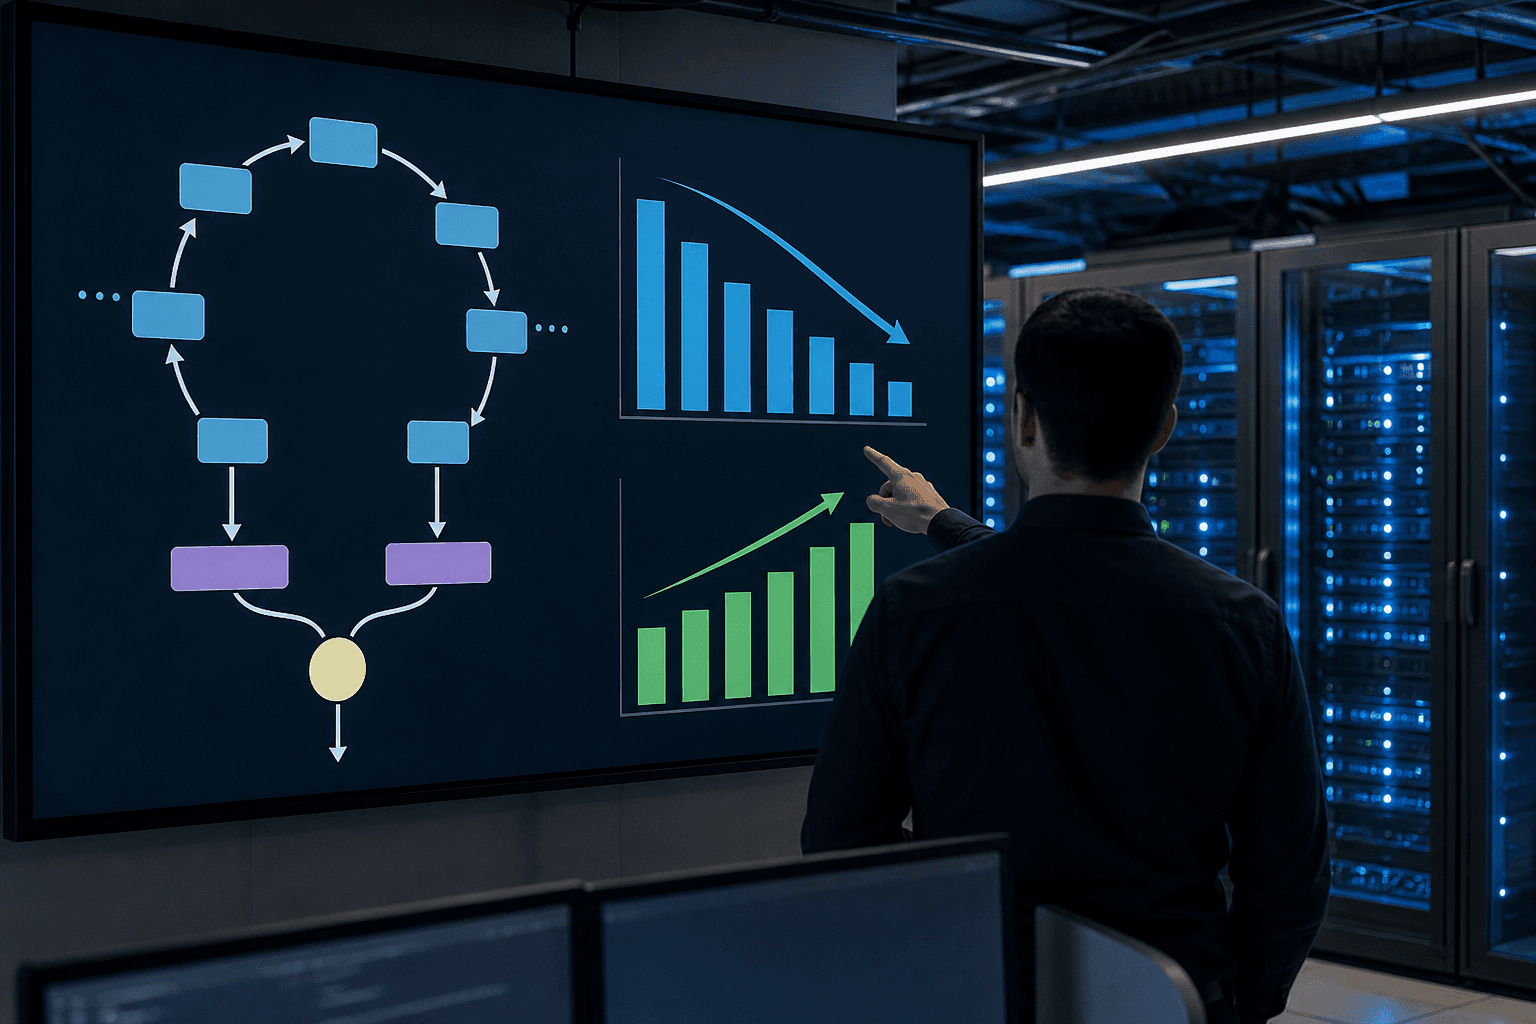
米研究チームは、同一の計算ブロックを繰り返し実行することで少ないパラメータで高性能を狙うループ型Transformerに着目した。この種のモデルは各ループが同一トークンに対する中間表現を生成するが、従来の復号(デコーディング)では最終ループの出力だけを採用し、途中の状態は捨てられてきた。
研究チームは、ループの浅い段階では計算量が小さく予測が弱い一方、深い段階では予測が強いという性質に注目した。この「強い予測と弱い予測の組」が、補助モデルや追加学習を用いずに内部から自然に得られる点を利用し、早期と最終の予測を対比して最終トークンの選択を導くコントラスティブデコーディングの枠組みを提案した。これをLoopCDと名付けた。
LoopCDは二つの方式を含む。LoopCD-Logitsは出力の確率分布(ロジット)空間で対比を行い、出力計算を1回追加する実装である。一方、LoopCD-Hiddenは内部の隠れ状態空間で対比し、出力側の追加計算負荷を発生させない。いずれの方式もモデルの再学習(追加のファインチューニング等)を必要としない点が特徴である。
研究では四種類のループ型モデル群で評価を行い、全ループ実行時に安定した性能向上を確認した。具体例として、Ouro-2.6B-Thinkingの数学試験問題AIME 2024におけるpass@1は61.88%から73.33%へ上昇し、HuginnのコーディングベンチマークHumanEvalのpass@1は22.56%から31.71%へ向上した。
さらに、得られた精度向上を計算削減に転用する可能性が示された。ループ回数を半分に短縮しても、ガイドなしの全ループ基準と同等以上の精度を維持でき、順伝播の演算量(FLOPs)を22.5%から48.2%削減したという報告がある。追加学習が不要であるため、既存のループ型実装に対する適用障壁は低い。
しくみをやさしく
ループ型Transformerは同じブロックを繰り返し用いるため、深い回数ほど出力が確実になるがコストが増す。逆に浅い回数は計算が安く弱い予測を返すが、そこにも有益な情報が含まれているという取扱いである。LoopCDは「早めの弱い予測」と「遅めの強い予測」を比べ、どちらがより信頼できるかを判断して最終選択を助ける仕組みである。
イメージとしては、最終回答だけを見るのではなく、途中経過のスナップショットも参照して決定することである。LoopCD-Logitsは最終出力の確率スコアの差を直接比較する方法で追加の出力計算が1回発生する。LoopCD-Hiddenは内部表現そのものに着目し、確率計算を増やさずに判断材料を増やす点が異なる。どちらもモデルを再訓練せずに運用側の復号処理を変えるだけで運用できる点が導入の現実味を高める。
ビジネスへの示唆
LoopCDの示すインパクトは、推論コストと精度の同時改善が可能になる点にある。自社で生成AIをサービス提供するクラウド事業者やSaaS企業のインフラ部門は、推論単価が売上原価に直結するため注目すべきである。演算量を22.5%から48.2%削減できる可能性は、1リクエスト当たりの原価、GPU稼働率、応答遅延といったKPI改善に直接結びつく。
自部門ごとに当てはめると分かりやすい。例えばソフトウェア開発部門でのコード生成支援を想定する。HumanEvalでのpass@1向上は約9ポイントであり、これが実運用でもコードの自動生成品質改善として反映されれば、コードレビューの手戻りやテストの再実行回数低減といった運用コスト削減が期待できる。
また、金融のリスク分析や製造業の設計検証のように段階的に推論を進めるワークフローでは、同等の精度を保ちながら応答時間を短縮できれば、単位時間あたりの処理件数増加や、外注・クラウド利用の最適化によるコスト低減が見込める。導入に際しての利点は、追加学習が不要なため、データ整備や再学習に伴う費用や時間を削減できる点である。
対象となる社内部門は主にAI基盤・MLOps、プロダクト開発、クラウド調達であり、注目すべきKPIは推論単価、応答遅延、GPU稼働率、タスク正答率である。まずは自部署で定期的に発生している「高頻度で推論を回す業務」を洗い出し、そこでの現在の平均レイテンシー、GPU使用時間、正答率を基準に比較することが実務的である。自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを現場で数値化する質問が出発点となる。
現場での導入イメージ
仮に導入支援に入るなら、次の四段階のワークフローを提案する。
- 棚卸し
- 何をするか: 現行の推論パイプラインを洗い出し、ループ型モデルを利用している箇所、推論回数(ループ回数)、1リクエスト当たりのFLOPsやGPU使用時間、現在の正答率を計測する。業務単位での頻度とコストを可視化する。
- 目指す到達点: どの業務がLoopCD適用で効果を出しやすいかを数値的に特定し、優先適用候補リストを作成する。
- 差し込み先の設計(既存ツールへの組み込み)
- 何をするか: 復号処理のどの段階にLoopCD-LogitsまたはLoopCD-Hiddenを差し込むかを設計する。既存の推論サーバやAPI、デコーダ実装に変更を加える現実解を検討し、新ツール追加を最小化する構成を選ぶ。
- 目指す到達点: 最小限の変更でLoopCDを組み込める実装案と、それに伴う運用手順(エラー時のフォールバック等)を確定する。
- 小さく試す(PoC)
- 何をするか: 優先候補の一つを選び、ループ回数を半分にした設定とLoopCDを適用したベンチマーク実験を実運用データのサンプルで実施する。Logits方式とHidden方式を比較し、精度・遅延・FLOPsのトレードオフを評価する。
- 目指す到達点: 本番投入の可否を判断するための定量結果(推論単価、応答遅延、タスク正答率の差)を取得し、運用上のリスクと期待値を明確にする。
- 運用と横展開
- 何をするか: PoCで得た成果を受けて、本番環境へ段階的に導入する。モニタリング項目を設定し、推論単価やGPU稼働率、エラー率を継続的に観測する。効果が確認できた部門へ横展開を行う。
- 目指す到達点: 本番運用でのコスト削減と同等以上の精度維持を実現し、社内の標準推論プロセスとしてLoopCD適用を定着させる。
最終的な目標は、既存のループ型実装に最小の改修で導入し、推論コストを小さく・安く抑えつつタスク正答率を維持または向上させる運用体制を確立することである。
今後の展望
留意点として、今回の検証は研究用のループ型モデルに対する評価に限られている。市場で主流の非ループ型大規模モデルにはそのまま適用できない点、公開ベンチマークの結果が必ずしも企業固有の業務データで再現されるとは限らない点には注意が必要である。
一方で、少ない記憶容量で高い推論性能を狙う設計としてループ型への関心は高まっている。復号側の工夫で精度と効率を同時に改善できるという示唆は、推論時の計算配分を見直す流れを後押しする可能性がある。企業はモデルの学習済み規模だけでなく、推論時の運用設計を含めた総コストでの比較を行う視点を持つことが求められる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AIが能力を隠せると証明、評価の限界露呈
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

ReLU網が描ける形状の規模を数学が証明
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

概念を隠して画像AIの判断根拠を探る新手法
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
