AI画像生成、学習効率10倍に向上
日米の研究チームが画像生成AIの学習プロセスを抜本的に刷新する手法「GEAR」を発表した。従来比最大10倍の収束速度を実現し、広告・ゲーム・医療画像など画像生成を活用する産業のコスト構造を大きく変える可能性がある。
研究の概要
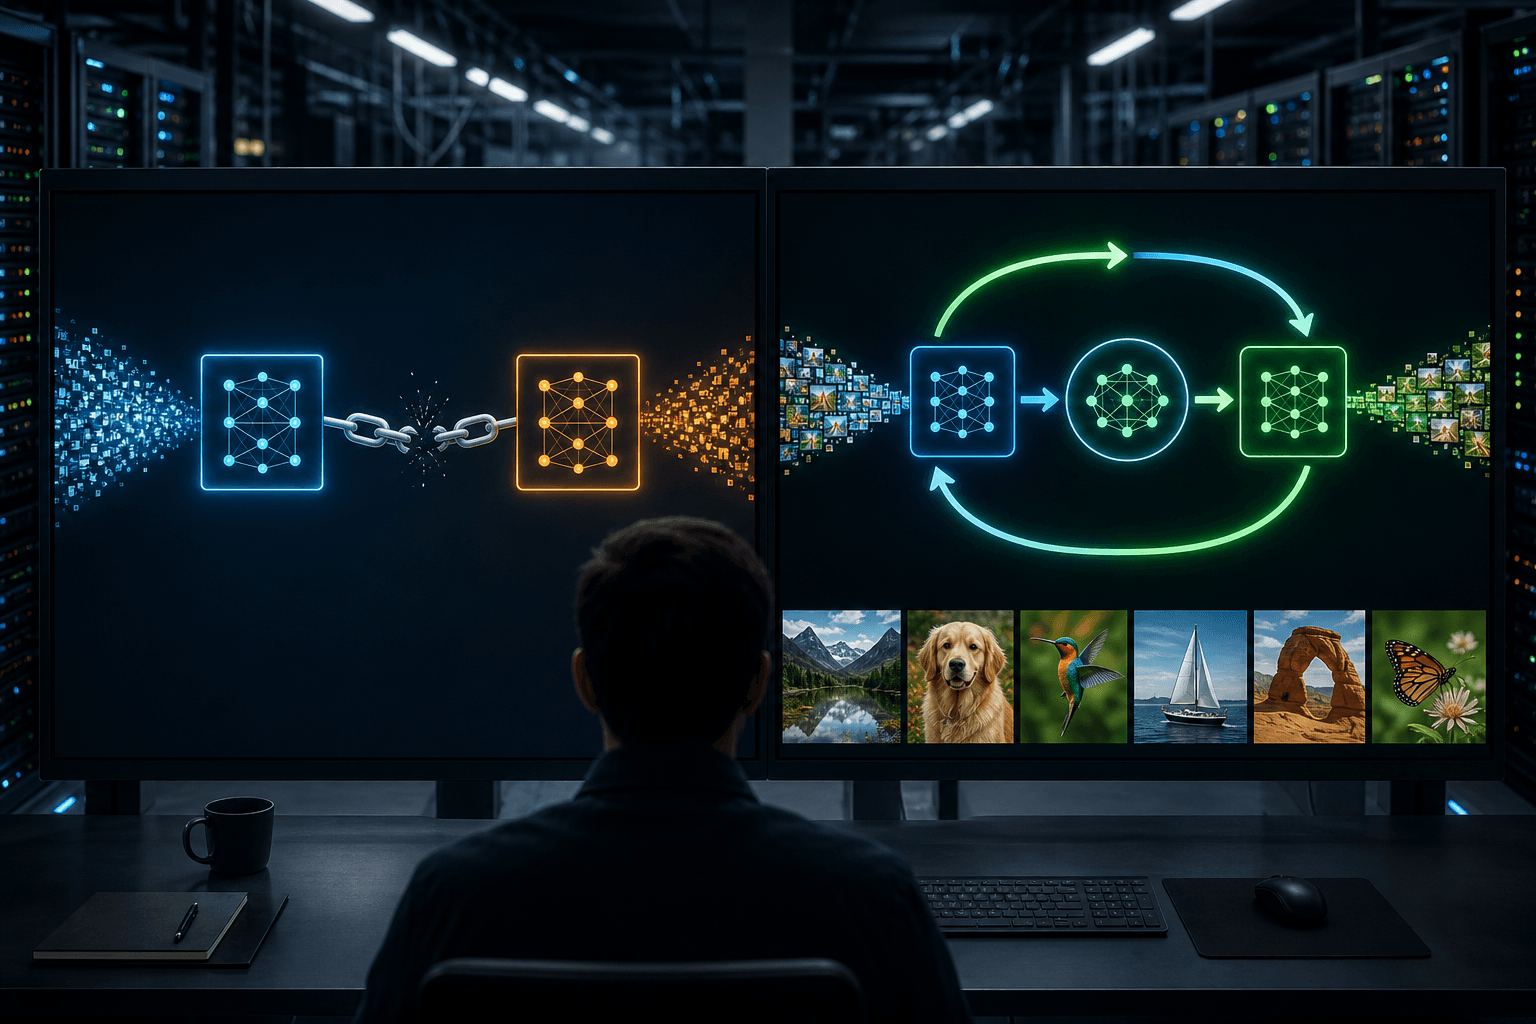
画像生成AIは従来、「トークナイザー」と「生成器」の2段階に分けて個別に学習させる構造が主流であった。この分離型アーキテクチャでは、トークナイザーが生成器の学習しやすさを考慮できず、モデル全体の最適化に限界があった。
北京大学らの研究チームが発表したGEAR(Guided End-to-end AutoRegression)は、この2段階構造を統合し、トークナイザーと自己回帰型生成器を同時・一貫して学習させる手法である。最大の技術的課題は、量子化(VQ)処理における勾配の非連続性であった。GEARはこれを「ハードブランチ」と「ソフトブランチ」の二重出力構造で解決し、生成器からの誤差信号をトークナイザーに還流させることに成功した。
画像生成品質の標準指標であるgFIDの収束速度は、強力なベースラインである「LlamaGen-REPA」比で最大10倍の高速化を達成した。また、画像の空間的一貫性や細部表現の品質も顕著に向上した。
ビジネスへの示唆
学習コストの大幅な削減は、画像生成AIを活用する複数の業種・部門に直接的な影響を与える。
- 広告・マーケティング部門: ビジュアルクリエイティブの自動生成モデルを内製化・カスタマイズする際、学習コストを10分の1程度に抑制できる可能性がある。キャンペーンごとの専用モデル構築が現実的な選択肢となり、広告制作費やコンテンツ制作リードタイムの短縮というKPI改善につながる。
- ゲーム・エンターテインメント: キャラクターや背景の自動生成パイプラインの刷新に応用できる。アセット生成の反復サイクルが加速し、開発期間短縮および人件費圧縮に寄与する。
- 医療画像・製造業: 病理画像の合成や製品外観検査用データの拡張において、高精度な空間的一貫性が求められる。GEARの特性はこうした用途と親和性が高く、検査精度向上やデータ収集コスト削減につながり得る。
クラウドAIサービスを提供する事業者にとっては、学習ジョブあたりのGPU時間が大幅に短縮されることで、インフラコスト削減とサービス単価の引き下げが同時に実現する。競合差別化の軸としても注目に値する。
また、GEARが複数の量子化方式(VQVAE、LFQ、IBQ)に対応していることは、既存の画像生成基盤を持つ企業が追加の設計変更なく恩恵を受けられることを意味する。既存資産の流用が可能なため、導入ハードルは低い。
今後の展望
研究チームはテキストから画像を生成するタスクへの汎化も確認しており、実用的な応用範囲は広い。今後は動画生成や3Dコンテンツ生成への拡張が見込まれ、映像制作・建築・ファッション分野への波及も予想される。
一方、エンドツーエンド学習の複雑性は実装・運用面での技術的ハードルを伴う。自社でのファインチューニングを検討する企業は、MLOps体制の整備とあわせて評価することが求められる。学習コスト削減の恩恵を最大化するには、モデル管理・監視の仕組みを先行して構築することが望ましい。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
画像生成AI、逆流を抑え指示への忠実度向上
画像生成AIが途中経過の誤りを自らの文章理解に反映し、ずれを固定化する現象が判明した。この逆流を抑える新手法SFGは、追加コストを抑えつつ指示への忠実度を高める。
生成AI再撮影の破綻を撮影現場で事前に可視化
撮影後にカメラ動作を変える生成AI再撮影では、未撮影部分の捏造が撤収後に発覚する課題がある。新手法は現場で破綻リスクを即時に可視化し、手戻りの抑制を目指す。
静止3D空間を無限ループ動画化するAI登場
台湾の研究チームが、静止した3D空間に多様な動きを与え、どの視点からも途切れず循環させる手法OuroWorldを発表した。3D空間の「動く資産」化を低コストで進める技術として注目される。