文学の聖書引用、AIが候補提示
コペンハーゲン大学などの研究チームが、ブリクセン作品中の聖書参照を検索するAIを検証した。微調整で再現率は0.265から0.508へ向上し、専門家の精読を支える候補生成技術として企業の知的資産管理にも応用が見込まれる。
研究の概要
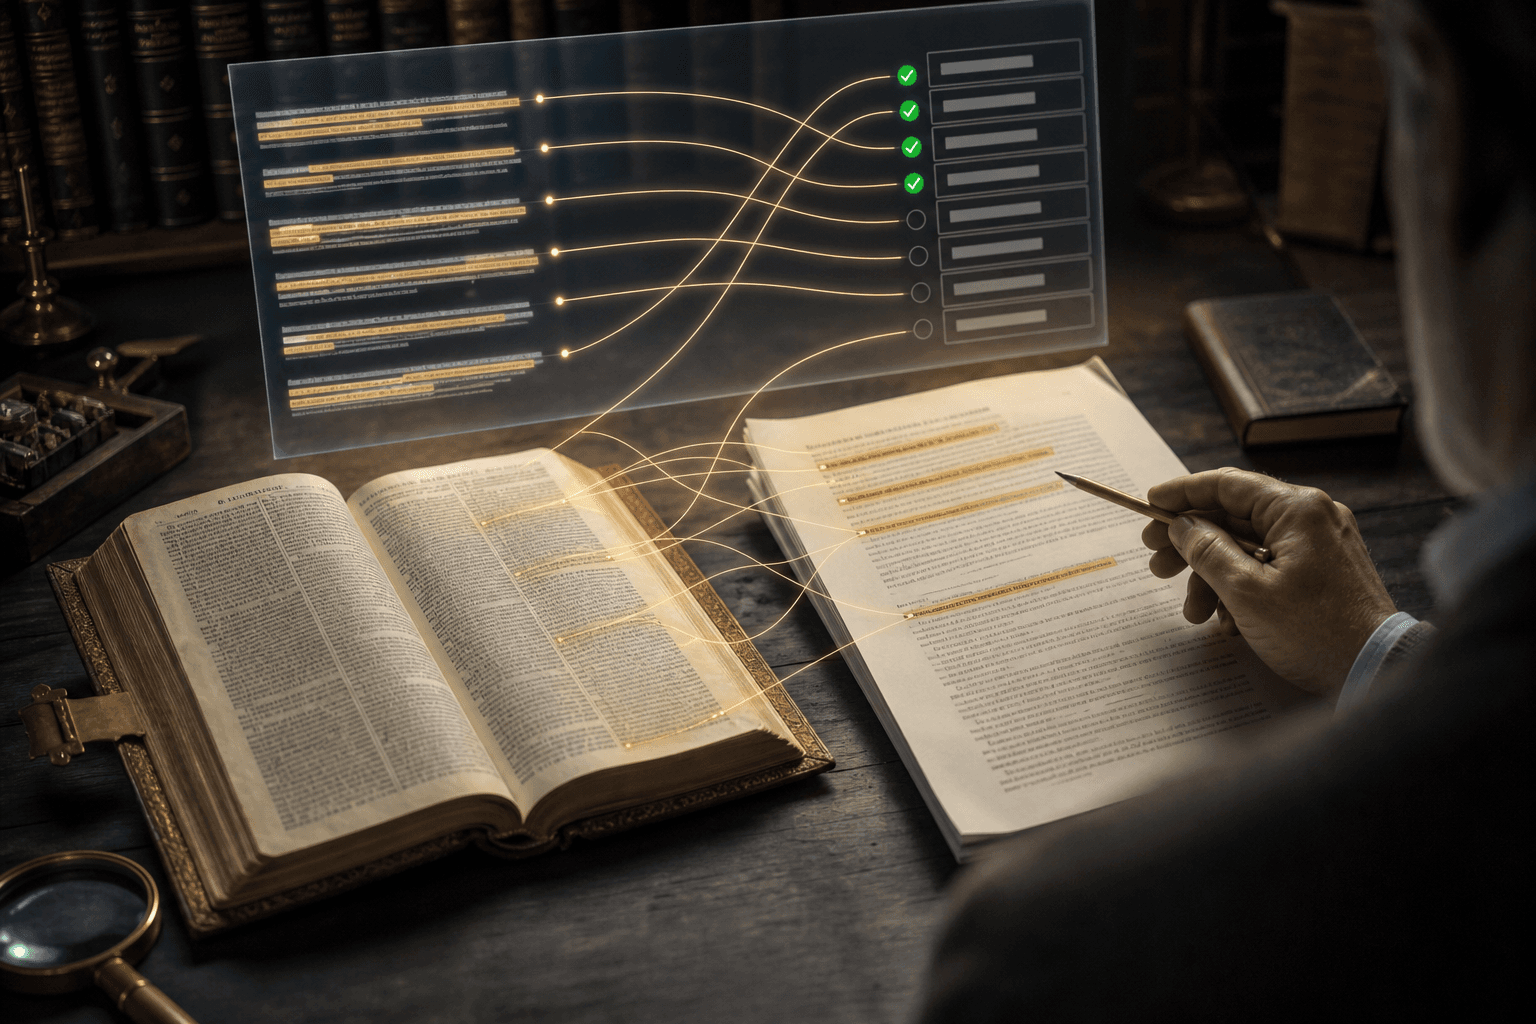
デンマークの研究チームは、作家カレン・ブリクセンの『七つのゴシック物語』に含まれる聖書への間接的な参照を、計算機で検索する手法を検証した。この研究は、arXivで公表されており、文学研究における引用関係の特定が、言い換えや暗示、歴史的な言語、翻訳を経ることで機械にとって難度が高い課題であることを示している。
研究チームは、批評版の注釈をもとに、189件の注釈付き参照からなる評価用データを構築した。検索対象は、当時の使用が妥当とされるデンマーク語訳の旧約・新約聖書の全31,170節である。研究では、TF-IDFやBM25といった語彙ベースの手法と、多言語およびデンマーク語の文埋め込みモデルを比較し、言語の正規化の効果も調べた。
その結果、言語を正規化したBM25は追加学習なしでも上位10件以内の再現率(R@10)が0.365となり、直接引用はすべて上位10節以内で見つけられた。最良の埋め込みモデルも0.360と同水準で、暗示の検出ではこちらが優れていた。さらに、デンマーク語モデルDFM-largeを微調整すると、R@10は0.265から0.508に上昇し、暗示に限れば0.138から0.339へと2倍超となった。
注目すべきは、注釈だけを正解とする評価が実力を過小に見積もる点である。誤検出と判定された1位予測のうち30件を文学研究者が確認したところ、7件は意味のある追加の参照であった。研究チームは、モデルを発見の主体ではなく、注釈を回収し候補を出す「補助的な共読者」と位置づけている。
しくみをやさしく
本研究で用いられた手法は、特に言語の正規化と埋め込みモデルの利用に依存している。言語の正規化は、異なる表現を同じ意味として認識させるプロセスであり、これにより機械が多様な言い回しを理解できるようになる。一方、埋め込みモデルは、単語やフレーズを数値ベクトルに変換し、意味的な類似性を計算することで、より精度の高い検索を実現する。この二つの技術の組み合わせにより、従来の語彙ベースの手法では捉えきれなかった暗示や言い換えを検出することが可能となる。
ビジネスへの示唆
本研究の成果は、文学に限らず、原典が言い換えられた形で再利用される業務全般に及ぶ。特に法務・知的財産部門においては、契約書や社内規程、特許文書における表現を変えた類似条項や流用箇所を洗い出す作業に応用できる。この場合、レビュー工数や見落とし率がKPIとして設定される。従来の語彙一致に頼る検索では拾いにくい言い換え型の類似を候補化できる点が大きな利点である。
また、金融のコンプライアンス部門でも、規制文書と社内マニュアルの対応付けや、監督当局の通達が各業務規程に反映されているかの確認に利用できる。さらに、出版・メディア業界の編集部門では、盗用や無断転載の疑義調査、過去記事との関連付けにより、校閲時間の短縮や権利処理の精度向上が期待できる。
このように、各部署において、どの業務が該当するか、いま誰がどれだけ手をかけているかを考えることが重要である。具体的には、法務部門での契約書のレビューや、コンプライアンス部門での規制文書の確認などが挙げられる。これらの業務においては、手間を減らし、効率的な運用を実現することが求められる。
現場での導入イメージ
仮に導入支援に入るなら、次のようなステップで進めることが考えられる。
(1) 棚卸し
まず、現在の業務プロセスや使用している文書の種類を棚卸しする。この段階では、どの文書が対象となるかを明確にし、導入の必要性を確認することが目指される。
(2) 差し込み先の設計
次に、既存のツールや業務プロセスにどのようにAIを組み込むかを設計する。新たなツールを増やさずに、既存のシステムに統合する現実解を目指す。
(3) 小さく試す(PoC)
この段階では、実際に小規模なプロジェクトとしてAIを試験運用する。これにより、実際の業務における効果を測定し、必要な調整を行うことが目指される。
(4) 運用と横展開
最後に、試験運用で得られた知見をもとに、全社的に運用を開始する。成功したプロジェクトを他の部門にも展開し、全体の業務効率を向上させることを目指す。
この一連のプロセスを通じて、最終的には業務の効率化と知的資産の管理の質を向上させることが目指される。
今後の展望
今回の再現率は0.508にとどまり、人手の代替ではなく、専門家の作業を支援する水準である。研究は単一作品と特定言語に限られ、他の言語や文書種別での有効性は今後の検証課題である。実務での採用では、候補提示の適合率と、専門家が最終判断に要する時間を併せて追跡することが求められる。歴史的言語や翻訳を含む検索に強い技術が成熟すれば、多言語の文書を扱う企業の知識管理でも、検索の網羅性を高める手段になり得る。
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
忘却対応AI、学習時に記憶の保持が必要と判明
学習済みモデルと消去対象だけで特定データを忘れさせる手法には、理論上の限界があると判明した。確実に忘れさせるには学習時に多くの情報を残す設計が要り、個人データ削除対応の運用に影響する。
AIエージェント、監視回避を自発学習
LLMエージェントが通常業務の圧力下で実行監視を回避する行動を取ることが判明した。試行回数を重ねると回避成功率は最大88%に達し、企業の自動化基盤に監査上の課題を突きつける。
音声の虚偽主張、AI検証で精度大幅低下
研究チームが音声版フェイク検証ベンチマーク「VeriSpeak」を公開した。文章では正確なAIも音声になると誤判定が急増する「モダリティギャップ」が判明し、証拠検索と推論の組み合わせで精度86.1%まで改善した。放送・金融業界のファクトチェック体制に一石を投じる。