生成AIの出力属性を後処理で目標分布に整合
米研究チームは、内部に触れられない生成AIの出力を、繰り返し問い合わせと選別で属性分布を目標に近づける手法を提案した。クエリ数最小化と漸近最適性も示し、公平性対応やデータ生成の実務に影響する。
研究の概要
Kevin Jiang氏、Morgane Austern氏、Edgar Dobriban氏、Jason M. Klusowski氏らの研究チームは、生成AIの出力に含まれる属性の分布を、利用者が指定した目標分布に整合させる後処理アルゴリズムを発表した。この研究は、モデルの内部や重みに触れることができない「ブラックボックス」環境において、繰り返し問い合わせることで出力を調整する手法を提案している。企業が外部のAPI経由で生成AIを利用する際の実務に即した設定であり、特に重要なテーマである。
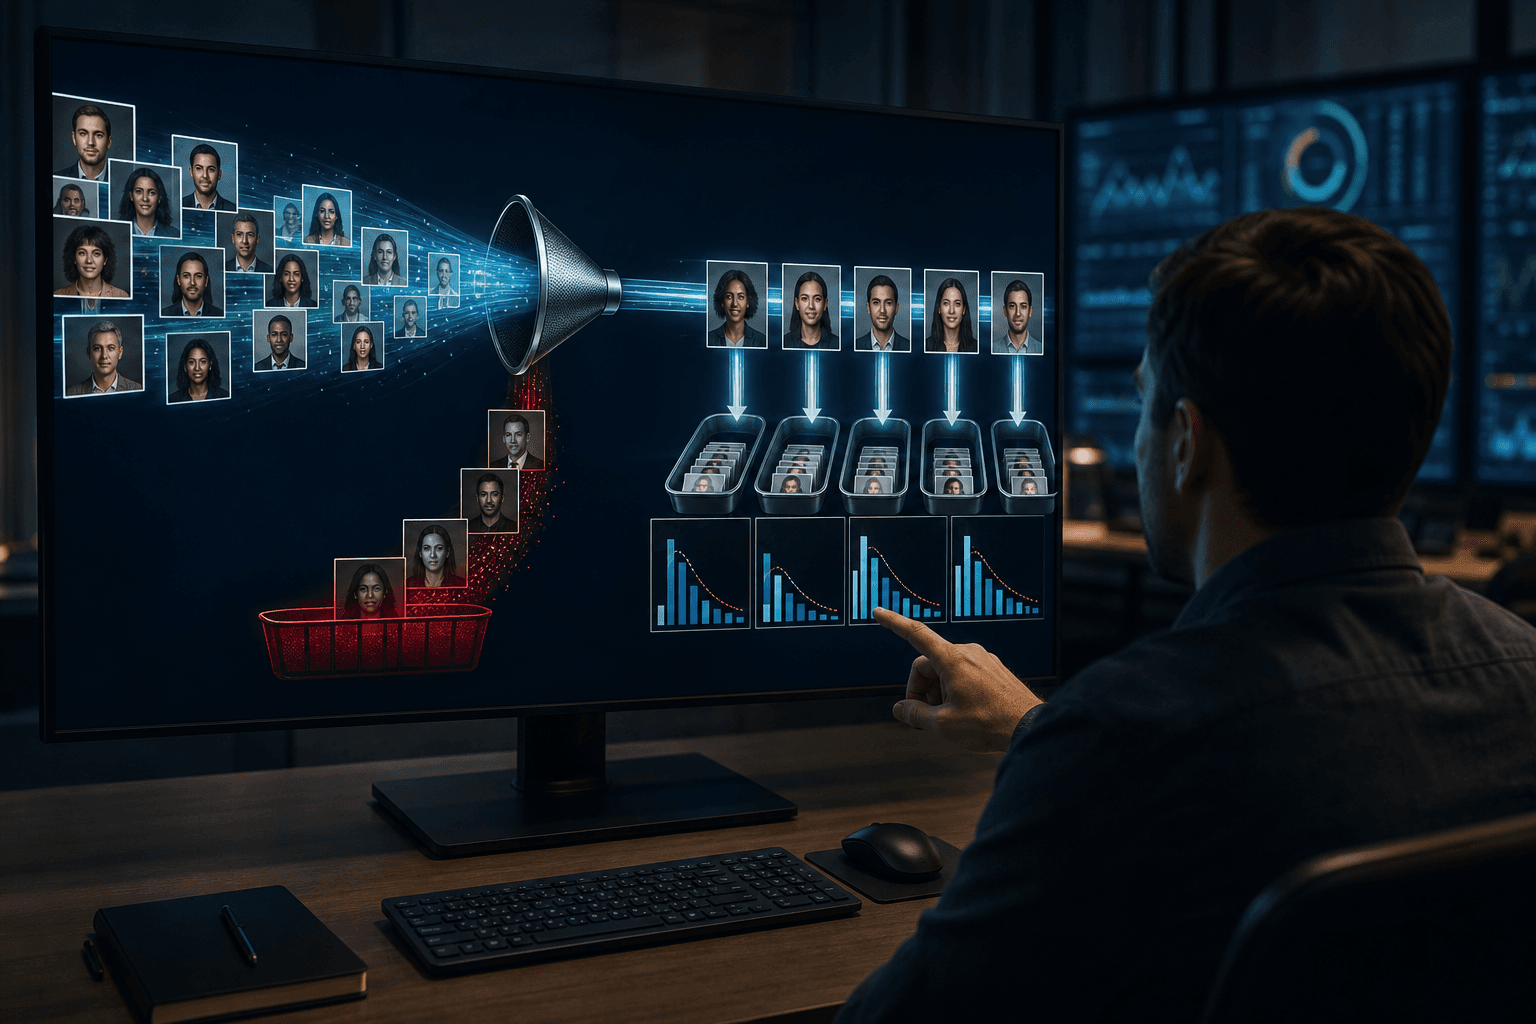
研究の主な目的は、m個(mは1以上)の出力を返す際に、それらの属性の同時分布を目標に近づけることである。具体的には、性別、人種、年齢層などの保護属性が想定されており、合成データを目標とする母集団の構成に合わせる用途も考慮されている。提案された手法は、生成器への期待クエリ数を最小化するように設計されており、厳密な整合と近似的な整合の両方についてのアルゴリズムが構築されている。要求する出力数mが無限大に近づく場合に、その手法が最適であることを理論的に示している。
実験は、テキストから画像を生成するタスクと、地理情報付きのペルソナ生成タスクで実施され、その結果、後処理アルゴリズムが統計的な属性整合を改善し、プロンプトの工夫による従来の介入を補完することが確認された。
しくみをやさしく
本手法は、生成AIから得られる出力の属性分布を目標に近づけるために、出力を繰り返し選別し、必要に応じて再生成を行うものである。具体的には、ユーザーが指定した属性分布に基づいて、生成されたデータの中から適切なものを選び出す。これにより、出力の公平性や代表性を高めることが可能となる。
このアプローチは、ブラックボックス環境での利用を前提としているため、モデルの内部構造に依存せず、外部APIを通じて生成AIを活用する企業にとっても実用的である。
ビジネスへの示唆
本手法の最大の特徴は、モデルの再学習や微調整を要せず、出力側で分布を制御できる点である。これにより、外部ベンダーのモデルを利用する企業でも、自社の運用層で導入しやすい。具体的な影響が見込まれる領域と指標は以下の通りである。
- 広告・マーケティング部門: 生成画像や訴求コンテンツにおける人物属性の偏りの是正。これにより、ブランドリスクの低減とターゲット層との表象の一致度の向上が期待される。
- 市場調査・商品企画部門: 地域別の人口構成に合わせた合成ペルソナの生成が可能となり、サンプルの代表性や調査設計の再現性の向上が図られる。
- 人事部門: 採用広報資料や研修教材の生成物における属性バランスの管理が容易になり、公平性監査への対応工数を削減できる。
- 金融・保険部門: 合成データを用いたモデル検証において、顧客構成の再現精度が向上する。
このように、各部門において本手法の導入がもたらす利点は明確である。読者は、自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを考えるべきである。特に、広告やマーケティング部門では、出力の属性分布を保証することが難しいため、本手法が提供する統計的に目標分布へ近づける仕組みは、コンプライアンス部門や法務部門にとっても重要な材料となり得る。
一方で、後処理は出力の選別や再生成を伴うため、追加のクエリが発生する。API従量課金の環境では、1件あたりの生成コストと応答時間が新たなKPIとなる。本研究が期待クエリ数の最小化を掲げている点は、コスト面の懸念を和らげる要素となる。
現場での導入イメージ
仮に導入支援に入るなら、以下の4つのステップで進めることが考えられる。
(1) 棚卸し: まず、現在の業務プロセスや生成AIの利用状況を棚卸しし、どのような属性が出力に含まれているかを把握する。目指す到達点は、現状の理解を深めることである。
(2) 差し込み先の設計: 次に、既存ツールや業務プロセスの中で、どこに本手法を適用するかを設計する。新ツールを増やさずに、既存の業務フローに組み込むことを目指す。
(3) 小さく試す(PoC): 小規模なプロジェクトとして試行を行い、実際に生成されたデータの属性分布が目標に近づくかを検証する。目指す到達点は、実用性の確認と問題点の洗い出しである。
(4) 運用と横展開: 最後に、成功した試行を基に、全社的な運用へと横展開する。目指す到達点は、全社での一貫したデータ生成プロセスの確立である。
このように、導入支援を通じて目指す全体の目標は、生成AIを用いた出力の公平性と代表性を高めることである。
今後の展望
生成AIの利用が広がる中、出力の公平性や代表性を求める規制や社会的要請は強まる傾向にある。ブラックボックス環境で使える後処理型の整合手法は、モデル提供者に依存しない統制手段として位置付けられよう。
実装にあたっては、属性を判定する分類器の精度が結果を左右する。属性の推定誤差や、複数属性を同時に扱う際の計算負荷など、運用上の課題は残る。実験も画像生成とペルソナ生成の2タスクに限られ、他の領域での有効性は今後の検証を要する。
企業にとっては、プロンプト設計による前段の制御と、後処理による統計的な保証を組み合わせる二層の運用が現実的な選択肢となる。生成AIのガバナンス体制を整える上で、実務への応用が注目される。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AIが能力を隠せると証明、評価の限界露呈
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

ReLU網が描ける形状の規模を数学が証明
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

概念を隠して画像AIの判断根拠を探る新手法
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
