LLM内部の利用者像を可視化し書換え
AIが対話相手について抱く暗黙の想定を読み出し、書き換える手法BSDが提案された。拒否判断が利用者像に左右されると示され、AI安全性の管理に影響する。
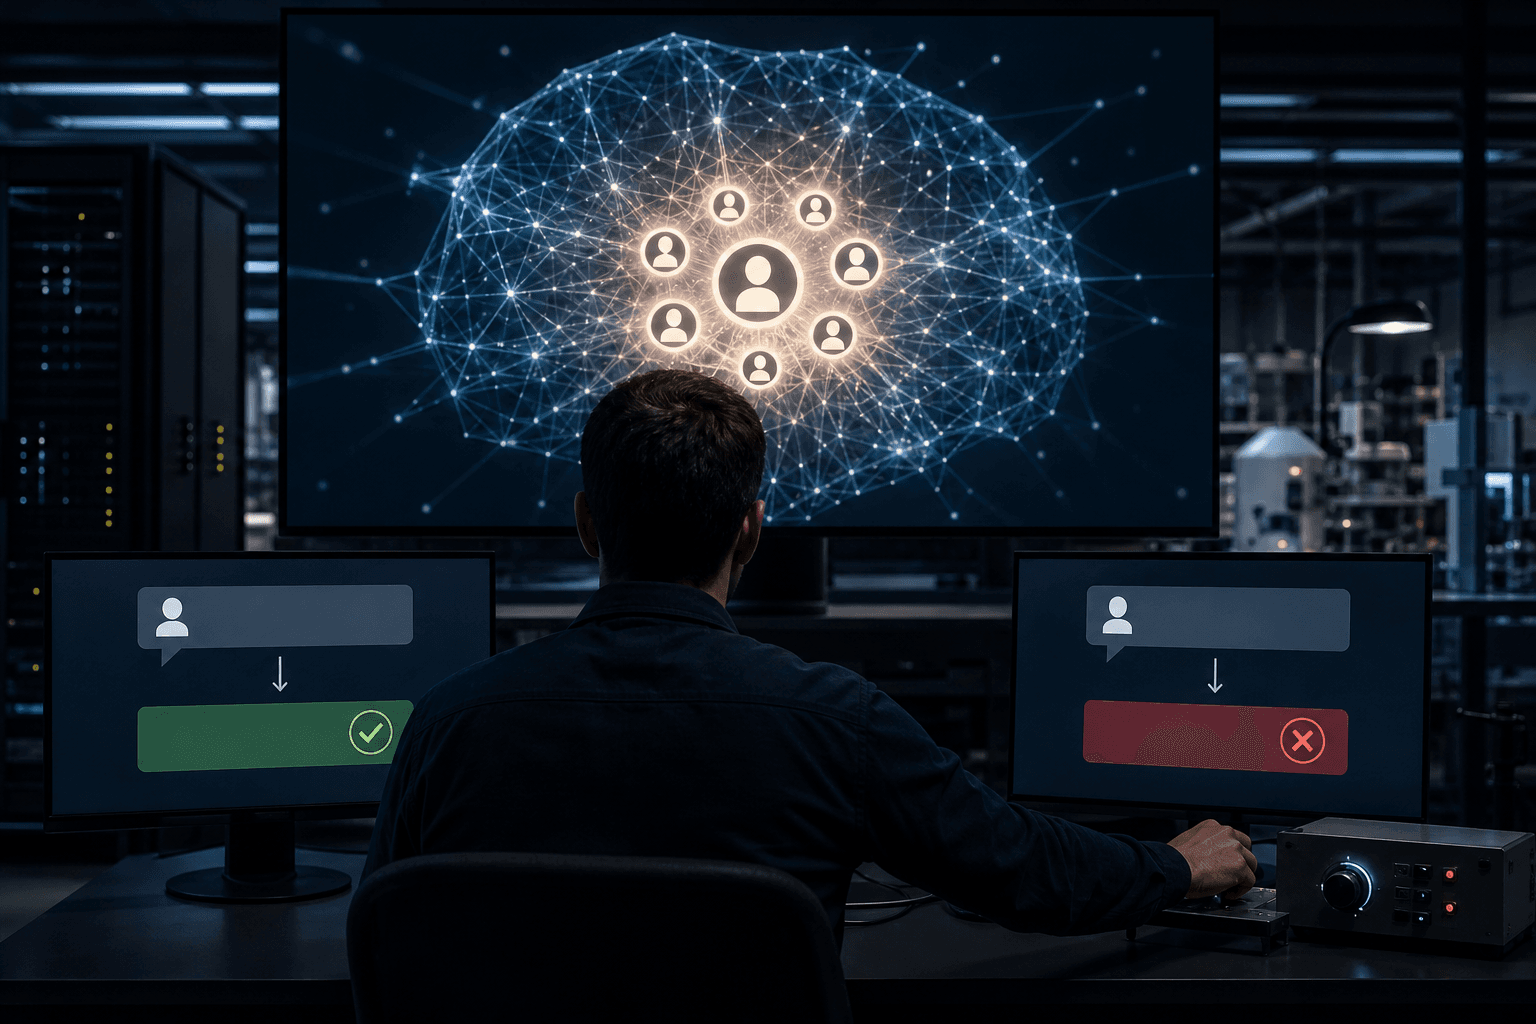
研究の概要
ドイツのAI研究者らは、大規模言語モデル(LLM)が対話相手の属性や意図を内部で推定し、応答を変えている実態を、直接検査し操作できる形で取り出す手法「信念自己蒸留(BSD)」を発表した。論文はプレプリントサーバーarXivで公開されている。
LLMは利用者の専門性や目的を暗黙のうちに推測して振る舞いを調整するとされるが、その推測内容は外から確認しにくく、因果的な検証も難しかった。従来の線形プローブは内部状態に情報が存在するかを調べるにとどまり、その情報が実際の挙動に効いているかは示せなかった。
BSDは、重みを固定したLLM自身を教師とし、外部の注釈データなしに自然な会話から利用者像を蒸留する。得られる小さな表現は、内部状態から読み出せるだけでなく、モデルへ書き戻して挙動を変えることもできる。読み書き両方に使える点が特徴である。
複数のモデルファミリーで検証した結果、BSDは利用者に関する信念を忠実に復元した。さらに、同等条件の隠れ状態ステアリングと比べて大幅に強い介入が可能だった。最も注目されるのは拒否判断への影響である。要求文を固定したまま、モデルが推定する利用者の意図だけを書き換えると、拒否するか否かが変化した。拒否は要求の内容だけでなく、モデルが想定する相手の意図にも依存することになる。加えて、独立に訓練された複数のLLMが、利用者を表す共通の幾何構造に収束する傾向も確認された。
しくみをやさしく
BSDは、LLMが内部でどのように利用者を理解しているかを可視化する手法である。具体的には、モデルが対話相手の専門性や意図を推測する過程を明らかにし、その推測を基に応答を調整する仕組みを持つ。これにより、利用者像を外部から操作することが可能となり、AIの応答の透明性が向上する。特に、拒否判断においては、モデルが想定する相手の意図が重要な役割を果たすことが示されている。
ビジネスへの示唆
この研究は、金融、医療、法務などの規制産業においてAIを顧客対応や社内業務に導入する企業にとって特に重要である。これらの現場では、利用者の属性推定が回答の範囲や拒否判断を左右している可能性がある。同じ質問でも、相手を専門家と見なすか一般消費者と見なすかで応答が変わりうるため、各部門での活用が期待される。
-
リスク管理部門: 利用者像の推定を監査項目に加え、不適切な拒否や過剰な許可の発生率を点検することができる。これにより、リスクを適切に評価し、管理する基盤を整えることが目指される。
-
コンプライアンス部門: 属性による応答差を可視化し、公平性の説明資料に用いることができる。これにより、社内外の透明性を確保し、信頼性を向上させることが期待される。
-
カスタマーサポート部門: 誤った拒否による問い合わせ放棄率や解決率を改善指標とすることができる。具体的には、顧客満足度を向上させるための施策を講じることが可能となる。
-
AI開発部門: レッドチーミングで、利用者像の操作による安全策の突破可能性を検証することができる。これにより、より安全なAIシステムの開発が促進される。
このように、各部門での具体的な業務に対してBSDの導入がもたらす影響を考慮することで、企業は自部署で該当する業務を見つけ、いま誰がどれだけ手をかけているかを評価することができる。
現場での導入イメージ
仮に導入支援に入るなら、次のようなステップで進めることが考えられる。
-
棚卸し: 現在の業務プロセスやAIシステムの利用状況を詳細に把握する。この段階では、どの業務がAIの導入に適しているかを明確にすることを目指す。
-
差し込み先の設計: 既存ツールや業務のどこにBSDを組み込むかを設計する。新ツールを増やさない現実解を考慮し、業務フローを最適化することを目指す。
-
小さく試す(PoC): 小規模なプロジェクトでBSDを試験的に導入し、その効果を測定する。この段階では、実際の業務における効果を確認し、必要な調整を行うことを目指す。
-
運用と横展開: 成功したPoCの結果を基に、全社的な運用へと展開する。この段階では、他の部門への展開を促進し、全体の業務効率を向上させることを目指す。
このような導入プロセスを経ることで、企業はAIを効果的に活用し、業務の効率化やリスク管理の強化を図ることができる。
今後の展望
実務での適用には課題が残る。BSDは内部状態へのアクセスを前提とするため、重みが非公開の商用APIには直接使えない。自社でモデルを運用する、あるいはオープンモデルを採用する企業が当面の対象となる。
また、利用者像を書き換える技術は、安全性の検証にも悪用にも使える両面性を持つ。導入企業には、内部状態の監査権限や介入手順を定める社内規程の整備が求められる。モデル提供者が利用者像の開示や監査機能を備えるかどうかは、今後の調達基準になりうる。
AIが相手をどう理解しているかを測る指標が確立すれば、安全性評価は入力と出力の検査から、内部の判断根拠の検査へ広がる。規制当局の監督や第三者監査の在り方にも影響を与える可能性がある。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AIが能力を隠せると証明、評価の限界露呈
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

ReLU網が描ける形状の規模を数学が証明
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

概念を隠して画像AIの判断根拠を探る新手法
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
