非同期パイプライン並列学習、大規模LLM開発を加速
米欧の研究チームが、大規模言語モデルの事前学習における非同期パイプライン並列処理の性能劣化問題を解決する手法を発表した。GPU稼働率の抜本的改善により、AI開発コストの大幅削減が見込まれる。
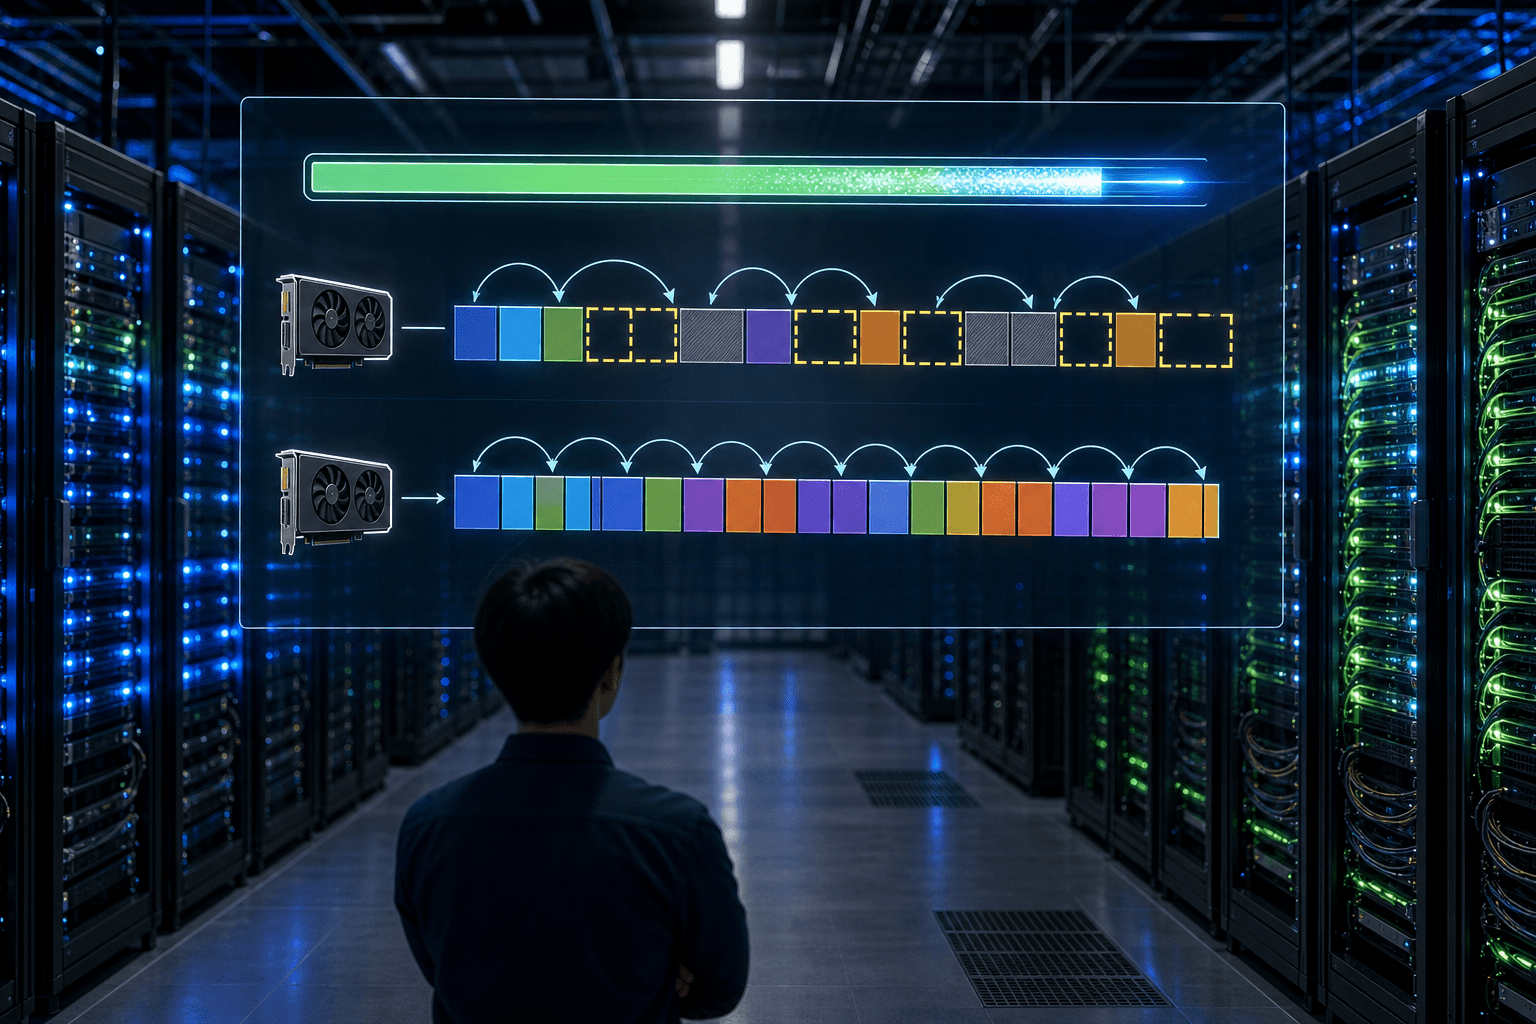
研究の概要
大規模言語モデル(LLM)の事前学習において、複数のGPUを効率的に活用するための技術として「パイプライン並列処理」が広く採用されている。しかし従来の同期型実装では、GPUが処理待ちとなる「パイプラインバブル」と呼ばれる空き時間が不可避的に発生し、計算資源が無駄になるという課題があった。
Philip Zmushkoらの研究チームは、この問題を解消する非同期型スケジュール「PipeDream-2BW」に着目した。同手法はパイプラインの深さによらず勾配の遅延を常に1ステップに抑えられる優れた特性を持つが、「遅延下での学習は根本的に不安定」という通念から実用化が進んでいなかった。
研究チームはこの通念に正面から異議を唱え、性能劣化がオプティマイザの選択に強く依存することを実証した。現在主流のオプティマイザ「AdamW」は1ステップの勾配遅延のもとで深刻な精度低下を示す一方、近年注目される「Muon」と呼ばれるオプティマイザは強い堅牢性を発揮することを確認した。さらに「誤差フィードバック」に着想を得た補正手法を組み合わせることで、遅延の影響をさらに低減できるという。100億パラメータ規模のモデルでの検証でも、同期型学習との性能差をほぼ解消できることが示された。
ビジネスへの示唆
この研究が持つ産業界への影響は広範にわたる。LLMの開発・運用に多大な投資を行う企業にとって、GPU稼働率の向上は直接的なコスト削減につながるからだ。
パイプラインバブルによるGPU空き時間はクラスタ規模が大きくなるほど深刻化する。非同期処理によってこれを排除できれば、同じ計算予算でより大規模なモデルを学習させることが可能となり、学習コストあたりのモデル性能というKPIを大きく改善できる。
影響が特に大きい領域は以下のとおりである。
- クラウド・インフラ事業者: データセンターのGPU稼働率(利用率)向上により、同一設備でのサービス提供能力が拡大する
- 金融・保険業のAI部門: 独自LLM開発における計算費用を圧縮し、モデル更新サイクルの短縮が見込める
- 製薬・創薬研究部門: 大規模な分子設計モデルや臨床文書解析モデルの学習期間短縮につながる
- 通信・メディア企業のMLOpsチーム: GPU予算の最適化指標(コストパーFLOP)改善に直結する
また、自社データセンターを持たず外部クラウドを利用する企業にとっても、学習時間の短縮は従量課金コストの削減を意味する。研究成果はオープンな形で発表されており、主要なディープラーニングフレームワークへの実装が進めば、特定ベンダーに依存せず広く活用できる可能性がある。
今後の展望
本研究の成果がフレームワークに統合されれば、数百億から数千億パラメータ規模のモデル開発における標準的な学習手法が塗り替えられる可能性がある。オプティマイザ選択という実装上の判断が、インフラ投資の効率を左右するという知見は、AI開発戦略の立案においても重要な示唆を与える。
一方で、Muonオプティマイザ自体がまだ普及途上にあり、既存の学習パイプラインへの移行にはエンジニアリングコストが伴う点も考慮が必要だ。今後は実装の簡便化と、より多様なモデルアーキテクチャへの適用検証が課題となろう。AI開発コストの削減競争が激化する中、非同期並列学習の実用化は業界全体の開発速度を底上げする可能性を秘めている。
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
AIが能力を隠せると証明、評価の限界露呈
AIモデルの重みの中に暗号化した別のネットワークを隠し、秘密の合図でのみ作動させられることが示された。導入前の能力評価だけでは危険性を見抜けない可能性があり、調達や監査の前提を揺るがす。

ReLU網が描ける形状の規模を数学が証明
ニューラルネットの出力が持つ「穴の数」を表現するのに必要な網の大きさを、数学的に導出した論文が登場した。モデル規模を設計根拠で決める道を開く成果である。

概念を隠して画像AIの判断根拠を探る新手法
重みや概念ラベルなしで画像AIの判断根拠を概念単位で示す手法HnSが提案された。分類以外の字幕生成や衛星画像分割にも適用でき、AIの説明責任を果たす実務の選択肢が広がる。
