多言語医療AIがインド農村の診断格差を縮小
IIT Patnaらの研究チームが、インド系7言語に対応した多モーダル医療推論フレームワーク「ArogyaSutra」を発表した。農村部における言語障壁を起因とするヘルスケアアクセス格差の解消に向け、製薬・医療テック企業の事業戦略に影響を与えうる成果である。
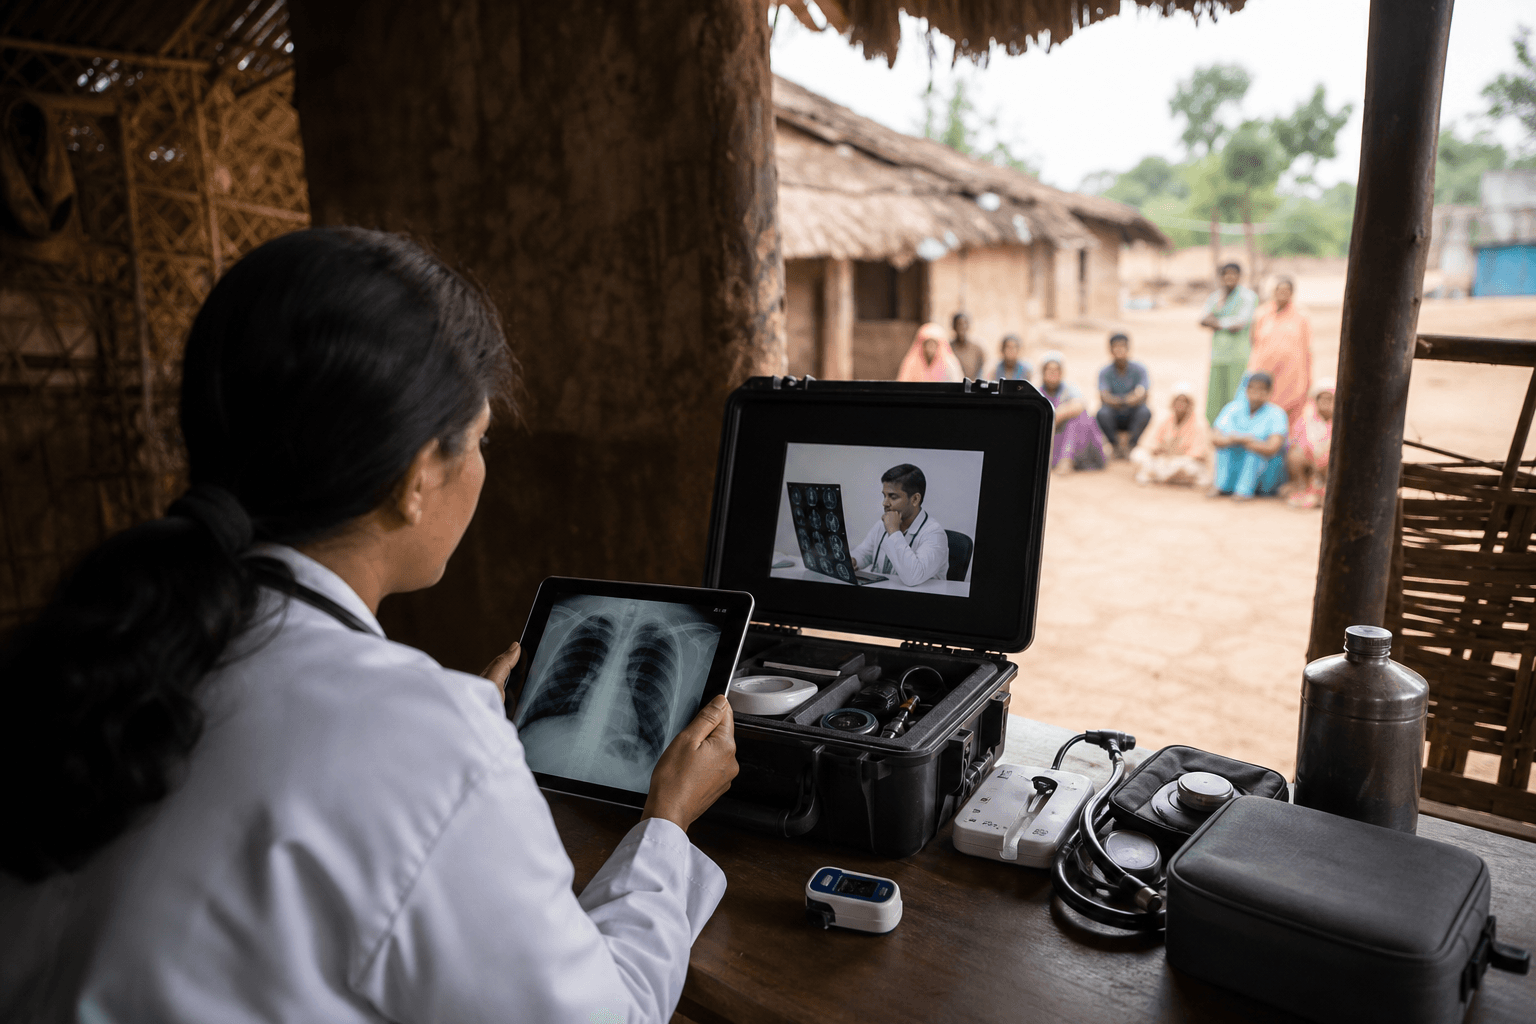
インド工科大学パトナ校などの共同研究チームは、英語と7つの主要インド系言語に対応した多言語・多モーダル医療質問応答データセット「ArogyaBodha」と、それを活用した多エージェント推論フレームワーク「ArogyaSutra」を発表した。論文はarXivにて公開されている。
ArogyaBodhaは8つの異種ソースから構築され、31の身体系統、6種の画像診断モダリティ、21の臨床領域を網羅する大規模データセットである。対応言語はヒンディー語、ベンガル語、タミル語など、インド農村部で広く使用される言語群を含む。既存の英語中心の大規模言語モデルでは対応が困難だった低リソース言語環境における医療支援を初めて本格的にスコープに収めた点が特徴である。
ArogyaSutraは「アクター・クリティック」型の多エージェントアーキテクチャを採用し、ツールグラウンディングとデュアルメモリ機構を組み合わせることで、段階的かつ推論根拠を伴う意思決定を実現する。さらに、アクター・クリティックのシミュレーション軌跡を蒸留に活用することで、より軽量なモデルへの知識移転も可能としている。実験結果では、同フレームワークが対象とする全インド系言語において多言語医療推論の精度を向上させたことが確認されており、アブレーション研究が各構成要素の有効性を個別に検証している。
ビジネスへの影響は複数のセクターに及ぶ。まず医療テック企業にとっては、インド農村部向けの遠隔医療プラットフォームに本フレームワークを組み込むことで、問診・トリアージの自動化精度向上が期待できる。KPIとして想定されるのは、誤診率の低減、初回問診の解決率(FCR: First Contact Resolution)、および医師一人当たりの診療件数増加である。インドの農村人口は約8億人に上り、医師不足が慢性的な課題となっている市場において、言語対応型AIは差別化要因となりうる。
製薬企業にとっては、臨床試験における患者リクルートメントや副作用報告の多言語収集プロセスへの応用が考えられる。規制当局への提出書類作成を支援するメディカルアフェアーズ部門では、地方語での患者報告アウトカム(PRO)データの収集・解析コスト削減につながる可能性がある。
保険セクターでは、医療保険の引受審査や請求処理において、農村部加入者が母国語で申告した症状や診断書を正確に解析する基盤として活用できる。査定部門における処理時間短縮と不正請求検知率の改善が主要KPIとなろう。
グローバルな観点では、同様の低リソース言語環境を抱えるアフリカ・東南アジア市場への展開可能性も示唆される。フレームワークのアーキテクチャ自体は言語非依存であり、スワヒリ語やタガログ語など他の新興市場言語への転用コストは比較的低いと見られる。ソースコードとデータセットは公開されており、製品開発への組み込みに向けた技術的障壁は低い。
課題としては、医療AIの規制承認プロセスの複雑さが挙げられる。インドでは医療機器としてのAIソフトウェアに関する規制が整備途上にあり、商業化には当局との継続的な対話が必要である。また、データの品質管理とバイアス検証も商用展開前に不可欠なプロセスとなる。各言語コミュニティにおける医療専門家による検証体制の構築が、信頼性確保の鍵を握る。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
生成・検証・改善で視覚推論を実現
英国の研究チームが、候補の生成、検証、反復改善を一体化した推論枠組みGenVerOptを提案した。IQパズルや前立腺がん領域の抽出で人間や臨床医に並ぶ成果を示し、画像判断業務の自動化に道を開く。
臓器グラフでCTと所見を融合し病期予測
CT画像と読影レポートを臓器単位のグラフで結び付け、喉頭咽頭がんのT分類を予測する枠組みが提案された。腫瘍の手作業での切り出しを要さず、生検に頼る診断の補完を狙う。
RNA動態をAIが生成・理解する基盤が登場
RNADynBenchとRNADynNetが公開された。2585本の全原子MD軌道を整備し、軌道生成と動態理解を単一モデルで扱う。RNA創薬の探索工程を効率化する基盤として注目される。